{
  "revision": "ed5423d809c6b10b8c1e9ef4a0c8ddc7f2ef7f3d",
  "sourceRepository": "https://github.com/SillyTavern/SillyTavern-Docs",
  "license": "AGPL-3.0",
  "pages": [
    {
      "slug": "",
      "title": "使用指南",
      "group": "Usage",
      "order": 40,
      "source": "Usage/index.md",
      "sourceUrl": "https://docs.sillytavern.app/usage/",
      "sourceSha256": "8c6c782e5bca8de80e572e8715efb2e106bc9437ff0d45b02eb3fb19fc8460aa",
      "headings": [
        {
          "id": "usage",
          "depth": 1,
          "title": "使用指南"
        },
        {
          "id": "getting-started",
          "depth": 2,
          "title": "入门指南"
        },
        {
          "id": "fundamentals",
          "depth": 2,
          "title": "基础知识"
        },
        {
          "id": "building-on-sillytavern",
          "depth": 2,
          "title": "在 SillyTavern 基础上扩展"
        },
        {
          "id": "control-panels",
          "depth": 2,
          "title": "控制面板"
        }
      ],
      "content": "# 使用指南\n\n以你喜欢的方式与 AI 互动，构建你的世界、作品或梦想。\n\n> ## 入门指南\n>\n> **[快速入门](/guides/sillytavern/quick-start/)**\n>\n> 向 AI 发送第一条消息并获得回复\n>\n> **[聊天](/guides/sillytavern/chatting/)**\n>\n> 如何与 AI 聊天，以及如何使用聊天界面\n>\n> **[常见问题](/guides/sillytavern/faq/)**\n>\n> 关于 SillyTavern、AI 模型、创建角色、获得更好回复等方面的常见问题\n\n> ## 基础知识\n>\n> **[API 连接](/guides/sillytavern/api-connections/)**\n>\n> 连接到 AI 模型以生成文本、图像等\n>\n> **[角色](/guides/sillytavern/characters/)** 和 **[用户人设](/guides/sillytavern/core-concepts/personas/)**\n>\n> 创建和使用角色来塑造 AI 的身份，并用用户人设定义你自己的身份\n>\n> **[回复配置](/guides/sillytavern/common-settings/)** 和 **[提示词](/guides/sillytavern/prompts/)**\n>\n> 控制发送给 AI 的请求，以及 AI 的回复方式\n>\n> **[欢迎页助手](/guides/sillytavern/welcome-assistants/)**\n>\n> 了解如何设置和使用欢迎页助手，让指定角色在欢迎页面上与你互动。\n\n> ## 在 SillyTavern 基础上扩展\n>\n> **[世界书](/guides/sillytavern/core-concepts/worldinfo/)**\n>\n> 管理信息，以及将信息插入提示词的时机\n>\n> **[资料库](/guides/sillytavern/core-concepts/data-bank/)**\n>\n> 存储和检索信息，供 AI 在回复时使用\n>\n> **[扩展](https://docs.sillytavern.app/extensions/)**\n>\n> 为 AI 或界面添加新功能\n>\n> **[开发与自动化](https://docs.sillytavern.app/for-contributors/)**\n>\n> 自动化任务，让您的 AI 与世界互动，并编写您自己的扩展\n\n***\n\n## 控制面板\n\n所有按钮的作用（从左到右）：\n\n> <i class=\"fa-solid fa-sliders fa-2xl fa-fw\"></i> **[回复配置](/guides/sillytavern/common-settings/)**\n> 和 **[提示词管理器](/guides/sillytavern/prompts/prompt-manager/)**\n>\n> 控制文本生成和采样，为聊天补全 API 自定义提示词的组织方式。\n\n> <i class=\"fa-solid fa-plug fa-2xl fa-fw\"></i> **[API 连接](/guides/sillytavern/api-connections/)**\n>\n> 连接到 AI 模型以生成文本、图像等\n\n> <i class=\"fa-solid fa-font fa-2xl fa-fw\"></i> **[高级格式设置](/guides/sillytavern/core-concepts/advancedformatting/)**\n>\n> 为文本补全 API 自定义提示词的组织方式\n\n> <i class=\"fa-solid fa-book-atlas fa-2xl fa-fw\"></i> **[世界书](/guides/sillytavern/core-concepts/worldinfo/)**\n>\n> 管理信息，以及将信息插入提示词的时机\n\n> <i class=\"fa-solid fa-user-gear fa-2xl fa-fw\"></i> **[用户设置](/guides/sillytavern/user-settings/)**\n>\n> 更改主题以及消息和聊天的外观和风格\n\n> <i class=\"fa-solid fa-panorama fa-2xl fa-fw\"></i> **背景**\n>\n> 更改背景图片\n\n> <i class=\"fa-solid fa-cubes fa-2xl fa-fw\"></i> **[扩展](https://docs.sillytavern.app/extensions/)**\n>\n> 为 AI 或界面添加新功能\n\n> <i class=\"fa-solid fa-face-smile fa-2xl fa-fw\"></i> **[用户人设](/guides/sillytavern/core-concepts/personas/)**\n>\n> 创建和管理与 AI 互动时使用的用户人设\n\n> <i class=\"fa-solid fa-address-card fa-2xl fa-fw\"></i> **[角色](/guides/sillytavern/characters/)**\n>\n> 创建和管理供 AI 使用的角色\n",
      "searchText": "使用指南 以你喜欢的方式与 AI 互动，构建你的世界、作品或梦想。 入门指南 快速入门 向 AI 发送第一条消息并获得回复 聊天 如何与 AI 聊天，以及如何使用聊天界面 常见问题 关于 SillyTavern、AI 模型、创建角色、获得更好回复等方面的常见问题 基础知识 API 连接 连接到 AI 模型以生成文本、图像等 角色 和 用户人设 创建和使用角色来塑造 AI 的身份，并用用户人设定义你自己的身份 回复配置 和 提示词 控制发送给 AI 的请求，以及 AI 的回复方式 欢迎页助手 了解如何设置和使用欢迎页助手，让指定角色在欢迎页面上与你互动。 在 SillyTavern 基础上扩展 世界书 管理信息，以及将信息插入提示词的时机 资料库 存储和检索信息，供 AI 在回复时使用 扩展 为 AI 或界面添加新功能 开发与自动化 自动化任务，让您的 AI 与世界互动，并编写您自己的扩展 控制面板 所有按钮的作用（从左到右）： 回复配置 和 提示词管理器 控制文本生成和采样，为聊天补全 API 自定义提示词的组织方式。 API 连接 连接到 AI 模型以生成文本、图像等 高级格式设置 为文本补全 API 自定义提示词的组织方式 世界书 管理信息，以及将信息插入提示词的时机 用户设置 更改主题以及消息和聊天的外观和风格 背景 更改背景图片 扩展 为 AI 或界面添加新功能 用户人设 创建和管理与 AI 互动时使用的用户人设 角色 创建和管理供 AI 使用的角色",
      "translationStatus": "machine-draft"
    },
    {
      "slug": "quick-start",
      "title": "快速入门",
      "group": "Usage",
      "order": 190,
      "source": "Usage/quick-start.md",
      "sourceUrl": "https://docs.sillytavern.app/usage/quick-start/",
      "sourceSha256": "f7eea8a052fad189943443703c1d8aba5a87b8493b769fe9d9d47932c9210d35",
      "headings": [
        {
          "id": "quick-start",
          "depth": 1,
          "title": "快速入门"
        },
        {
          "id": "quick-start-with-ai-horde",
          "depth": 2,
          "title": "通过 AI Horde 快速入门"
        },
        {
          "id": "quick-start-with-openai",
          "depth": 2,
          "title": "通过 OpenAI 快速入门"
        },
        {
          "id": "install-sillytavern",
          "depth": 3,
          "title": "安装SillyTavern"
        },
        {
          "id": "get-access-to-openai",
          "depth": 3,
          "title": "访问 OpenAI"
        },
        {
          "id": "configure-sillytavern-to-use-your-api",
          "depth": 3,
          "title": "配置 SillyTavern 以使用您的 API"
        },
        {
          "id": "test-your-setup",
          "depth": 3,
          "title": "测试您的设置"
        }
      ],
      "content": "# 快速入门\n\n> 我完全不懂。请直接手把手教我，用最简单、最快的方式开始使用 SillyTavern。—— *匿名*\n\n您只需几分钟即可开始使用 SillyTavern。以下是两种简单的入门方法：\n\n- 你可以 [使用 AI Horde](#quick-start-with-ai-horde)，而且免费。AI Horde 是由社区驱动的 AI 服务，提供多种 AI 模型。\n\n- 如果您有 OpenAI 帐户或想注册一个，您可以 [使用 OpenAI](#quick-start-with-openai).\n\n## 通过 AI Horde 快速入门\n\n1. 遵循 [安装指南](https://docs.sillytavern.app/installation/) 安装并启动SillyTavern。\n\n2. 在 SillyTavern 的首次使用引导页面中，输入用户人设的名称。聊天中将使用这个名称。\n\n   ![操作示意图](/docs/sillytavern/static/quick-start/1_name.png)\n\n3. 单击顶部栏中的 API 连接按钮。\n\n   ![操作示意图](/docs/sillytavern/static/quick-start/2_api_conn.png)\n\n4. 输入 AI Horde 的 API 密钥。您可以使用 `0000000000` 暂时使用，也可以获取免费密钥，来源为 [AI Horde](https://aihorde.net/).\n\n   ![操作示意图](/docs/sillytavern/static/quick-start/3_horde_key.png)\n\n5. 选择一些要使用的AI模型。只需从顶部选择一些即可。您以后可以随时更改它们。\n\n   ![操作示意图](/docs/sillytavern/static/quick-start/4_horde_models.png)\n\n6. 关闭 API 连接窗口。在底部的聊天框中输入消息，然后按 Enter。\n\n   ![操作示意图](/docs/sillytavern/static/quick-start/5_msg.png)\n\n7. 稍等片刻，AI 就会回复。你可以继续与它[聊天](/guides/sillytavern/chatting/)。成功了！\n\n   ![操作示意图](/docs/sillytavern/static/quick-start/6_success.png)\n\n## 通过 OpenAI 快速入门\n\n### 安装SillyTavern\n\n遵循 [安装指南](https://docs.sillytavern.app/installation/) 安装并启动SillyTavern。\n\n### 访问 OpenAI\n\n1. 注册 OpenAI。\n2. 前往 <https://platform.openai.com>\n3. 单击右上角的帐户图标，然后单击“查看 API 密钥”。\n4. 点击“Create new secret key（创建新密钥）”，立即将其复制并保存。 **请勿共享此密钥。无论谁拥有它都可以使用您的帐户来使用 GPT，费用由您承担。**\n\n### 配置 SillyTavern 以使用您的 API\n\n1. 在 SillyTavern 的顶部栏中，单击 API 连接。\n2. 在 API 下，选择聊天补全 (OpenAI)。\n3. 在聊天补全源下，选择 OpenAI。\n4. 粘贴您在上一步中保存的 API 密钥。\n5. 单击“连接”按钮。确认它显示有效。\n6. 默认情况下，SillyTavern 使用 GPT-4 Turbo。你可以选择其他模型，但需要先了解其价格。\n\n### 测试您的设置\n\n1. 在SillyTavern的顶部栏中，单击最右侧的角色管理。\n2. 选择一个现有角色，例如 Seraphina。\n3. 在底部的文本框中，向 Seraphina 写一些内容，然后按 Enter 或单击“发送”按钮。\n\n如果以上操作都正确，几秒钟后 Seraphina 应该就会回复。\n",
      "searchText": "快速入门 我完全不懂。请直接手把手教我，用最简单、最快的方式开始使用 SillyTavern。—— 匿名 您只需几分钟即可开始使用 SillyTavern。以下是两种简单的入门方法： 你可以 使用 AI Horde，而且免费。AI Horde 是由社区驱动的 AI 服务，提供多种 AI 模型。 如果您有 OpenAI 帐户或想注册一个，您可以 使用 OpenAI. 通过 AI Horde 快速入门 遵循 安装指南 安装并启动SillyTavern。 在 SillyTavern 的首次使用引导页面中，输入用户人设的名称。聊天中将使用这个名称。 单击顶部栏中的 API 连接按钮。 输入 AI Horde 的 API 密钥。您可以使用 0000000000 暂时使用，也可以获取免费密钥，来源为 AI Horde. 选择一些要使用的AI模型。只需从顶部选择一些即可。您以后可以随时更改它们。 关闭 API 连接窗口。在底部的聊天框中输入消息，然后按 Enter。 稍等片刻，AI 就会回复。你可以继续与它聊天。成功了！ 通过 OpenAI 快速入门 安装SillyTavern 遵循 安装指南 安装并启动SillyTavern。 访问 OpenAI 注册 OpenAI。 前往 https://platform.openai.com 单击右上角的帐户图标，然后单击“查看 API 密钥”。 点击“Create new secret key（创建新密钥）”，立即将其复制并保存。 请勿共享此密钥。无论谁拥有它都可以使用您的帐户来使用 GPT，费用由您承担。 配置 SillyTavern 以使用您的 API 在 SillyTavern 的顶部栏中，单击 API 连接。 在 API 下，选择聊天补全 (OpenAI)。 在聊天补全源下，选择 OpenAI。 粘贴您在上一步中保存的 API 密钥。 单击“连接”按钮。确认它显示有效。 默认情况下，SillyTavern 使用 GPT-4 Turbo。你可以选择其他模型，但需要先了解其价格。 测试您的设置 在SillyTavern的顶部栏中，单击最右侧的角色管理。 选择一个现有角色，例如 Seraphina。 在底部的文本框中，向 Seraphina 写一些内容，然后按 Enter 或单击“发送”按钮。 如果以上操作都正确，几秒钟后 Seraphina 应该就会回复。",
      "translationStatus": "machine-draft"
    },
    {
      "slug": "faq",
      "title": "常见问题",
      "group": "Usage",
      "order": 180,
      "source": "Usage/faq.md",
      "sourceUrl": "https://docs.sillytavern.app/usage/faq/",
      "sourceSha256": "c4c216ee0a09c1c36ec822789dc5183c627f70ab5ce068846a83982294a3028c",
      "headings": [
        {
          "id": "faq",
          "depth": 1,
          "title": "常见问题"
        },
        {
          "id": "explain-what-sillytavern-is-about",
          "depth": 2,
          "title": "解释一下SillyTavern是什么意思"
        },
        {
          "id": "give-me-an-overview-of-my-ai-model-options",
          "depth": 2,
          "title": "概述一下我的 AI 模型选项"
        },
        {
          "id": "paid-web-service-ais",
          "depth": 3,
          "title": "付费网络服务 AI"
        },
        {
          "id": "self-hosted-ais",
          "depth": 3,
          "title": "自托管 AI"
        },
        {
          "id": "can-i-use-sillytavern-on-my-phone-or-tablet",
          "depth": 2,
          "title": "我可以在手机或平板电脑上使用 SillyTavern 吗？"
        },
        {
          "id": "i-tried-to-import-a-png-character-card-but-got-an-error-that-its-invalid-why",
          "depth": 2,
          "title": "我尝试导入 PNG 角色卡，但收到错误消息，指出它无效。为什么？"
        },
        {
          "id": "how-can-i-make-my-own-ai-character",
          "depth": 2,
          "title": "如何制作自己的AI 角色？"
        },
        {
          "id": "where-are-my-api-keys-stored-why-cant-i-see-them",
          "depth": 2,
          "title": "我的 API 密钥存储在哪里？为什么我看不到他们？"
        },
        {
          "id": "performance-tips",
          "depth": 2,
          "title": "性能技巧"
        },
        {
          "id": "why-is-the-ui-so-slowjittery",
          "depth": 3,
          "title": "为什么用户界面如此缓慢/不稳定？"
        },
        {
          "id": "im-experiencing-an-input-lag-what-can-i-do",
          "depth": 3,
          "title": "我遇到输入延迟。我能做些什么？"
        },
        {
          "id": "when-i-import-a-lot-of-characters-the-app-becomes-slow-why",
          "depth": 3,
          "title": "当我导入大量角色时，应用程序变得很慢。为什么？"
        },
        {
          "id": "how-to-make-the-ai-write-more",
          "depth": 2,
          "title": "如何让AI写得更多？"
        },
        {
          "id": "how-to-make-the-ai-write-less",
          "depth": 2,
          "title": "如何让AI少写？"
        },
        {
          "id": "how-to-make-the-ai-stop-writing-the-actions-of-my-character-and-driving-the-plot-all-on-its-own",
          "depth": 2,
          "title": "如何让AI不再编写我的角色的动作，并自行驱动剧情？"
        }
      ],
      "content": "# 常见问题\n\n## 解释一下SillyTavern是什么意思\n\nChatGPT 等现代 AI 语言模型已经变得如此强大，以至于其中一些模型现在能够令人信服地模拟您创建的角色，以及您可以与谁聊天、写小说等。例如，您可以告诉 AI 假装是来自中世纪日本的围棋教练 Jubei，它会做出相应的行动和响应。你可以与 Jubei 进行长时间的聊天，一起去酒吧，决定与武士打架，无论你能想象到什么，AI 都会围绕这些内容进行游戏和编写/反应，充当你的陪衬和地下城主。你的想象力是极限。你可以告诉人工智能假装它是神奇女侠。您还可以指定场景（“神奇女侠和我正在抢劫银行”）、写作风格（“神奇女侠用黑檀木说话”）或您能想到的任何其他内容。\n\nSillyTavern 是一个促进这些用途的应用程序：\n\n- 它是一个处理与人工智能语言模型通信的用户界面。\n- 它可以让您创建新的角色卡 (提示词)，并在它们之间轻松切换。\n- 它允许您导入其他人创建的角色。\n- 它将用角色保存您的聊天记录，以便您随时恢复、开始新聊天、查看旧聊天等。\n- 在后台，它会执行必要的操作来为您准备 AI 提示词。具体来说，它将发送一个系统提示词（AI 指令），让 AI 遵循某些规则以提高响应准确性。\n\n## 概述一下我的 AI 模型选项\n\nSillyTavern可以与两种类型的AI交互：\n\n1. [网络服务](/guides/sillytavern/api-connections/openai/) （基于云、通常付费、专有、封闭）\n2. [自托管](/guides/sillytavern/how-to-use-a-self-hosted-model/) （本地、免费、开源）\n\n### 付费网络服务 AI\n\n付费网络模型是黑匣子。你付费给一家公司使用他们的人工智能服务。您将帐户信息放入 SillyTavern，它将连接到您的提供商以代表您使用 AI。\n\n优点：\n\n- 真的很容易上手。\n- 最高质量的人工智能写作。\n\n缺点：\n\n- 它们的使用需要花钱。\n- 一切都记录在他们的服务器上。隐私问题。\n- 他们经常受到审查，并且会拒绝与您谈论某些主题。\n\n### 自托管 AI\n\n自托管模型是可以在 PC 上运行的免费模型，但需要功能强大的 PC 和更多的设置工作。\n\n优点：\n\n- 设置完成后，即使没有互联网连接也可以免费使用它们。\n- 完全隐私。您编写的所有内容都保留在您自己的电脑上。\n- 有各种各样的型号。作为社区驱动的技术，您可以找到适合您想要的某些任务或行为的模型。\n\n缺点：\n\n- 他们没有能力 <abbr title=\"State of the art\">索塔</abbr> 模型（即，他们写的对话更糟糕，创意更少，等等）。\n- 运行本地模型需要具有至少 6GB VRAM 的 GPU。\n\n如果您有兴趣使用这些，请参阅此处的专用指南： [如何使用自托管模型](/guides/sillytavern/how-to-use-a-self-hosted-model/).\n\n## 我可以在手机或平板电脑上使用 SillyTavern 吗？\n\niPhone 和 iPad 无法运行整个 SillyTavern 应用程序，但由于它只是一个 Web 界面，因此您可以在家庭 Wi-Fi 上的另一台计算机上运行它，然后在移动浏览器中访问它。参考 [远程连接](https://docs.sillytavern.app/usage/remoteconnections/) 了解更多信息。\n\n对于 Android 用户，除了上述之外，您还可以使用 Termux 应用程序直接在手机上运行整个 SillyTavern，无需 PC。参考 [安装（安卓）](https://docs.sillytavern.app/installation/android-\\(termux\\)/)。 （注意：Termux 安装不受官方支持，我们不能保证它能够正常工作。）\n\n## 我尝试导入 PNG 角色卡，但收到错误消息，指出它无效。为什么？\n\n两种可能性：\n\n1. 该卡没有嵌入其中的定义，只是一个普通的图像文件。某些程序或文件管理器会在您保存时从卡中删除嵌入的定义。确保您使用的是共享该文件的人发布的原始 PNG 文件。\n2. PNG 文件实际上是一个 WEBP 文件，带有 `.png` 文件名。您可以尝试将卡重命名为 `.webp` 在导入之前，或者查找图像的正确 PNG 版本。\n\n## 如何制作自己的AI 角色？\n\n1. 单击角色管理按钮\n2. 单击创建新角色\n3. 在角色名称下，给出一个名字，例如 Amanda\n4. 或者，单击“选择头像”按钮为此角色选择图像肖像\n5. 在“描述”下，描述角色，并包含您认为与聊天相关的任何信息。例如： `Amanda is a student traveling during her gap year. She's 6 feet tall, and a volleyball player. She has an athletic figure. She has long brown hair. She loves the Victorian England period, and watching TV and reading novels relating to that period.`\n   例如，如果您希望阿曼达友善，那么您可以添加： `Amanda is extremely cheerful and outgoing.`\n6. 在“第一条消息”下，写下开始新聊天时角色的问候语。例如： `*Amanda waves at you* Hey! Are you a backpacker too?`\n7. 单击创建角色按钮\n\n您现在有了一个可以聊天的基本角色。从角色列表中选择 Amanda，新的聊天将开始。\n\n请注意，您可以使用描述和/或第一条消息来创建更具体的场景，和/或将您自己包含在描述中。例如：\n\n```txt\nDescription:\nAmanda is a student traveling during her gap year. She's 6 feet tall, and a volleyball player. She has an athletic figure. She has long brown hair. She loves the Victorian England period, and watching TV and reading novels relating to that period. She's been keeping a secret that weighs heavily on her soul. She's waiting for the right person to unburden herself to, but this may lead to a cat and mouse game against a powerful secret society. She's recently arrived in Calcutta.\n\nYou're Rajesh Nahasmapetilon, a world-famous Indian volleyball superstar. You're out for a walk in Calcutta. Amanda spots you and screams in excitement.\n\nFirst Message:\n*Amanda runs up to you, beaming.* Rajesh! I can't believe it! I'm such a big fan. I have your poster in my bedroom.\n```\n\n您提供的任何相关信息都可以使用。它的使用效果取决于人工智能模型的能力水平。\n\n注意：创建角色后，您可以返回并编辑任何此信息（名称除外）。\n\n## 我的 API 密钥存储在哪里？为什么我看不到他们？\n\nSillyTavern 将您的 API 密钥保存到 `secrets.json` 用户数据目录中的文件（`/data/default-user/secrets.json` 是默认路径）。\n\n默认情况下，保存 API 密钥并刷新页面后，在界面中将看不到它们。\n\n为了能够查看您的密钥：\n\n1. 设置值 `allowKeysExposure` 到 `true` 在 `config.yaml` 文件。\n2. 重新启动SillyTavern服务器。\n3. 单击 API 连接面板右下角的“查看隐藏的 API 密钥”链接。\n\n## 性能技巧\n\n### 为什么用户界面如此缓慢/不稳定？\n\n- 尝试在用户设置面板上启用无模糊效果（快速 UI）模式。\n- 在 UI 主题设置中启用“减少运动”以删除装饰动画。\n- 确保您的浏览器正在使用硬件加速。\n- 如果使用响应流，请将流 FPS 设置为较低的值（建议 10-15 FPS）。\n\n### 我遇到输入延迟。我能做些什么？\n\n性能下降，尤其是输入延迟，最常见的原因是浏览器扩展。已知有问题的扩展包括：\n\n- iCloud 密码管理器\n- 深度翻译\n- 基于人工智能的语法纠正工具\n- 各种广告拦截扩展\n\n如果您遇到性能问题且无法确定原因，或者怀疑 SillyTavern 本身存在问题，请：\n\n1. [记录性能概况](https://developer.chrome.com/docs/devtools/performance/reference)\n2. 将配置文件导出为 JSON 文件\n3. 提交给开发团队分析\n\n我们建议首先禁用所有浏览器扩展和第三方 SillyTavern 扩展进行测试，以隔离性能下降的根源。\n\n### 当我导入大量角色时，应用程序变得很慢。为什么？\n\n不幸的是，SillyTavern 并不是为处理巨大的角色库而设计的。您拥有的越多，加载角色列表所需的时间就越长。证据数据表明，当角色超过 1000 个时，性能下降开始变得明显。\n\n但是，您可以采取一些措施来缓解该问题：\n\n**1.使用延迟加载。**\n\n启用角色设置值的延迟加载 `performance.lazyLoadCharacters` 为真在 `config.yaml` 文件。下次服务器重新启动后，角色列表将仅加载您与之交互的角色的完整数据。请注意，如果某些第三方扩展未更新为支持此设置，则在启用此设置的情况下，某些第三方扩展可能无法正常工作（请联系扩展开发人员以获取更多信息）。\n\n**2.使用内存缓存。**\n\n如果您有一些空闲 RAM，请增加内存缓存容量。这将允许服务器在内存中保留更多角色 ，从而减少加载它们所需的时间。您可以通过调整值来做到这一点 `performance.memoryCacheCapacity` 到更高的数字 `config.yaml` 文件。默认值为 `100mb`。大致的经验法则：每拥有 3000 个角色，就将值增加 100mb。\n\n**限制：**\n\n1. 高级（模糊）角色搜索将无法在启用延迟加载的情况下使用。仅搜索角色名称。\n2. 由于可用内存量有限，Android 设备上的内存缓存被禁用。\n\n## 如何让AI写得更多？\n\n有时，当您希望 AI 更详细时，它只会回复一句话。\n这通常是本地运行模型的问题。\n\n如果您只是想让机器人从最近回复结束时停止的位置继续写入，您可以通过在输入栏中不输入任何内容并单击“发送”来发送一条空的用户消息。这将迫使机器人继续讲故事。\n\n解决此问题的策略：\n\n- 增加值 `Response Length` 设置\n- 设计一个好的 `First Message` 对于角色，这表明他们说话很啰嗦。当给出有关您期望的写作风格的指导时，人工智能模型可以取得很大的进步。\n- 在角色的描述框中添加短语，例如“喜欢说很多话”或“非常冗长的演讲者”\n- 为你做同样的事情 `Author's Note`, 或 `Post-History Instruction Prompt`\n- 作为最后的手段，您可以尝试打开 `Auto-Continue` （在“用户设置”面板中），但会使响应速度变慢，因为它使人工智能连续产生小回复，然后将它们组合在一起形成一个大回复。它还可能与某些 API 选项不兼容。\n\n## 如何让AI少写？\n\n对于 ChatGPT 或 Claude 等模型来说，这主要是一个问题。可以应用相同的策略，但方向相反。\n\n- 减少的值 `Response Length` 设置\n- 在角色的描述中为角色添加诸如“简短发言”或“不多说话”之类的短语。\n- 向角色发送简短的第一条消息，以设定聊天的基调和期望。\n- 确保 `Auto-Continue` 已关闭。\n\n## 如何让AI不再编写我的角色的动作，并自行驱动剧情？\n\n这应该在 `Author's Note` 与短语的组合，例如：\n\n- {{char}} 的响应只能是被动的，并且对 {{user}} 的操作做出反应。\n- 您的下一个回复应仅来自 {{char}} 的 POV。\n- 您绝不能为 {{user}} 指定动作或言语。\n",
      "searchText": "常见问题 解释一下SillyTavern是什么意思 ChatGPT 等现代 AI 语言模型已经变得如此强大，以至于其中一些模型现在能够令人信服地模拟您创建的角色，以及您可以与谁聊天、写小说等。例如，您可以告诉 AI 假装是来自中世纪日本的围棋教练 Jubei，它会做出相应的行动和响应。你可以与 Jubei 进行长时间的聊天，一起去酒吧，决定与武士打架，无论你能想象到什么，AI 都会围绕这些内容进行游戏和编写/反应，充当你的陪衬和地下城主。你的想象力是极限。你可以告诉人工智能假装它是神奇女侠。您还可以指定场景（“神奇女侠和我正在抢劫银行”）、写作风格（“神奇女侠用黑檀木说话”）或您能想到的任何其他内容。 SillyTavern 是一个促进这些用途的应用程序： 它是一个处理与人工智能语言模型通信的用户界面。 它可以让您创建新的角色卡 (提示词)，并在它们之间轻松切换。 它允许您导入其他人创建的角色。 它将用角色保存您的聊天记录，以便您随时恢复、开始新聊天、查看旧聊天等。 在后台，它会执行必要的操作来为您准备 AI 提示词。具体来说，它将发送一个系统提示词（AI 指令），让 AI 遵循某些规则以提高响应准确性。 概述一下我的 AI 模型选项 SillyTavern可以与两种类型的AI交互： 网络服务 （基于云、通常付费、专有、封闭） 自托管 （本地、免费、开源） 付费网络服务 AI 付费网络模型是黑匣子。你付费给一家公司使用他们的人工智能服务。您将帐户信息放入 SillyTavern，它将连接到您的提供商以代表您使用 AI。 优点： 真的很容易上手。 最高质量的人工智能写作。 缺点： 它们的使用需要花钱。 一切都记录在他们的服务器上。隐私问题。 他们经常受到审查，并且会拒绝与您谈论某些主题。 自托管 AI 自托管模型是可以在 PC 上运行的免费模型，但需要功能强大的 PC 和更多的设置工作。 优点： 设置完成后，即使没有互联网连接也可以免费使用它们。 完全隐私。您编写的所有内容都保留在您自己的电脑上。 有各种各样的型号。作为社区驱动的技术，您可以找到适合您想要的某些任务或行为的模型。 缺点： 他们没有能力 索塔 模型（即，他们写的对话更糟糕，创意更少，等等）。 运行本地模型需要具有至少 6GB VRAM 的 GPU。 如果您有兴趣使用这些，请参阅此处的专用指南： 如何使用自托管模型. 我可以在手机或平板电脑上使用 SillyTavern 吗？ iPhone 和 iPad 无法运行整个 SillyTavern 应用程序，但由于它只是一个 Web 界面，因此您可以在家庭 Wi-Fi 上的另一台计算机上运行它，然后在移动浏览器中访问它。参考 远程连接 了解更多信息。 对于 Android 用户，除了上述之外，您还可以使用 Termux 应用程序直接在手机上运行整个 SillyTavern，无需 PC。参考 安装（安卓）。 （注意：Termux 安装不受官方支持，我们不能保证它能够正常工作。） 我尝试导入 PNG 角色卡，但收到错误消息，指出它无效。为什么？ 两种可能性： 该卡没有嵌入其中的定义，只是一个普通的图像文件。某些程序或文件管理器会在您保存时从卡中删除嵌入的定义。确保您使用的是共享该文件的人发布的原始 PNG 文件。 PNG 文件实际上是一个 WEBP 文件，带有 .png 文件名。您可以尝试将卡重命名为 .webp 在导入之前，或者查找图像的正确 PNG 版本。 如何制作自己的AI 角色？ 单击角色管理按钮 单击创建新角色 在角色名称下，给出一个名字，例如 Amanda 或者，单击“选择头像”按钮为此角色选择图像肖像 在“描述”下，描述角色，并包含您认为与聊天相关的任何信息。例如： Amanda is a student traveling during her gap year. She's 6 feet tall, and a volleyball player. She has an athletic figure. She has long brown hair. She loves the Victorian England period, and watching TV and reading novels relating to that period. 例如，如果您希望阿曼达友善，那么您可以添加： Amanda is extremely cheerful and outgoing. 在“第一条消息”下，写下开始新聊天时角色的问候语。例如： *Amanda waves at you* Hey! Are you a backpacker too? 单击创建角色按钮 您现在有了一个可以聊天的基本角色。从角色列表中选择 Amanda，新的聊天将开始。 请注意，您可以使用描述和/或第一条消息来创建更具体的场景，和/或将您自己包含在描述中。例如： Description: Amanda is a student traveling during her gap year. She's 6 feet tall, and a volleyball player. She has an athletic figure. She has long brown hair. She loves the Victorian England period, and watching TV and reading novels relating to that period. She's been keeping a secret that weighs heavily on her soul. She's waiting for the right person to unburden herself to, but this may lead to a cat and mouse game against a powerful secret society. She's recently arrived in Calcutta. You're Rajesh Nahasmapetilon, a world-famous Indian volleyball superstar. You're out for a walk in Calcutta. Amanda spots you and screams in excitement. First Message: *Amanda runs up to you, beaming.* Rajesh! I can't believe it! I'm such a big fan. I have your poster in my bedroom. 您提供的任何相关信息都可以使用。它的使用效果取决于人工智能模型的能力水平。 注意：创建角色后，您可以返回并编辑任何此信息（名称除外）。 我的 API 密钥存储在哪里？为什么我看不到他们？ SillyTavern 将您的 API 密钥保存到 secrets.json 用户数据目录中的文件（/data/default-user/secrets.json 是默认路径）。 默认情况下，保存 API 密钥并刷新页面后，在界面中将看不到它们。 为了能够查看您的密钥： 设置值 allowKeysExposure 到 true 在 config.yaml 文件。 重新启动SillyTavern服务器。 单击 API 连接面板右下角的“查看隐藏的 API 密钥”链接。 性能技巧 为什么用户界面如此缓慢/不稳定？ 尝试在用户设置面板上启用无模糊效果（快速 UI）模式。 在 UI 主题设置中启用“减少运动”以删除装饰动画。 确保您的浏览器正在使用硬件加速。 如果使用响应流，请将流 FPS 设置为较低的值（建议 10-15 FPS）。 我遇到输入延迟。我能做些什么？ 性能下降，尤其是输入延迟，最常见的原因是浏览器扩展。已知有问题的扩展包括： iCloud 密码管理器 深度翻译 基于人工智能的语法纠正工具 各种广告拦截扩展 如果您遇到性能问题且无法确定原因，或者怀疑 SillyTavern 本身存在问题，请： 记录性能概况 将配置文件导出为 JSON 文件 提交给开发团队分析 我们建议首先禁用所有浏览器扩展和第三方 SillyTavern 扩展进行测试，以隔离性能下降的根源。 当我导入大量角色时，应用程序变得很慢。为什么？ 不幸的是，SillyTavern 并不是为处理巨大的角色库而设计的。您拥有的越多，加载角色列表所需的时间就越长。证据数据表明，当角色超过 1000 个时，性能下降开始变得明显。 但是，您可以采取一些措施来缓解该问题： 1.使用延迟加载。 启用角色设置值的延迟加载 performance.lazyLoadCharacters 为真在 config.yaml 文件。下次服务器重新启动后，角色列表将仅加载您与之交互的角色的完整数据。请注意，如果某些第三方扩展未更新为支持此设置，则在启用此设置的情况下，某些第三方扩展可能无法正常工作（请联系扩展开发人员以获取更多信息）。 2.使用内存缓存。 如果您有一些空闲 RAM，请增加内存缓存容量。这将允许服务器在内存中保留更多角色 ，从而减少加载它们所需的时间。您可以通过调整值来做到这一点 performance.memoryCacheCapacity 到更高的数字 config.yaml 文件。默认值为 100mb。大致的经验法则：每拥有 3000 个角色，就将值增加 100mb。 限制： 高级（模糊）角色搜索将无法在启用延迟加载的情况下使用。仅搜索角色名称。 由于可用内存量有限，Android 设备上的内存缓存被禁用。 如何让AI写得更多？ 有时，当您希望 AI 更详细时，它只会回复一句话。 这通常是本地运行模型的问题。 如果您只是想让机器人从最近回复结束时停止的位置继续写入，您可以通过在输入栏中不输入任何内容并单击“发送”来发送一条空的用户消息。这将迫使机器人继续讲故事。 解决此问题的策略： 增加值 Response Length 设置 设计一个好的 First Message 对于角色，这表明他们说话很啰嗦。当给出有关您期望的写作风格的指导时，人工智能模型可以取得很大的进步。 在角色的描述框中添加短语，例如“喜欢说很多话”或“非常冗长的演讲者” 为你做同样的事情 Author's Note, 或 Post-History Instruction Prompt 作为最后的手段，您可以尝试打开 Auto-Continue （在“用户设置”面板中），但会使响应速度变慢，因为它使人工智能连续产生小回复，然后将它们组合在一起形成一个大回复。它还可能与某些 API 选项不兼容。 如何让AI少写？ 对于 ChatGPT 或 Claude 等模型来说，这主要是一个问题。可以应用相同的策略，但方向相反。 减少的值 Response Length 设置 在角色的描述中为角色添加诸如“简短发言”或“不多说话”之类的短语。 向角色发送简短的第一条消息，以设定聊天的基调和期望。 确保 Auto-Continue 已关闭。 如何让AI不再编写我的角色的动作，并自行驱动剧情？ 这应该在 Author's Note 与短语的组合，例如： {{char}} 的响应只能是被动的，并且对 {{user}} 的操作做出反应。 您的下一个回复应仅来自 {{char}} 的 POV。 您绝不能为 {{user}} 指定动作或言语。",
      "translationStatus": "machine-draft"
    },
    {
      "slug": "common-settings",
      "title": "通用设置",
      "group": "Usage",
      "order": 160,
      "source": "Usage/Common-Settings.md",
      "sourceUrl": "https://docs.sillytavern.app/usage/common-settings/",
      "sourceSha256": "c2dc88e93e1bc3a8573ff175619d891308ef89a1cc28312b4d232747f54e6ee1",
      "headings": [
        {
          "id": "common-settings",
          "depth": 1,
          "title": "通用设置"
        },
        {
          "id": "context-settings",
          "depth": 2,
          "title": "上下文设置"
        },
        {
          "id": "response-tokens",
          "depth": 3,
          "title": "响应（token）"
        },
        {
          "id": "context-tokens",
          "depth": 3,
          "title": "上下文 (token)"
        },
        {
          "id": "sampler-parameters",
          "depth": 2,
          "title": "采样器参数"
        },
        {
          "id": "temperature",
          "depth": 3,
          "title": "温度"
        },
        {
          "id": "repetition-penalty",
          "depth": 3,
          "title": "重复处罚"
        },
        {
          "id": "repetition-penalty-range",
          "depth": 4,
          "title": "重复处罚范围"
        },
        {
          "id": "repetition-penalty-slope",
          "depth": 4,
          "title": "重复罚分斜率"
        },
        {
          "id": "top-k",
          "depth": 3,
          "title": "前K"
        },
        {
          "id": "top-p",
          "depth": 3,
          "title": "Top P"
        },
        {
          "id": "typical-p",
          "depth": 3,
          "title": "典型P"
        },
        {
          "id": "min-p",
          "depth": 3,
          "title": "最小P"
        },
        {
          "id": "top-a",
          "depth": 3,
          "title": "顶级A"
        },
        {
          "id": "tail-free-sampling",
          "depth": 3,
          "title": "无尾采样"
        },
        {
          "id": "smoothing-factor",
          "depth": 3,
          "title": "平滑因子"
        },
        {
          "id": "dynamic-temperature",
          "depth": 3,
          "title": "动态温度"
        },
        {
          "id": "epsilon-cutoff",
          "depth": 3,
          "title": "厄普西隆截止"
        },
        {
          "id": "eta-cutoff",
          "depth": 3,
          "title": "埃塔截止值"
        },
        {
          "id": "dry-repetition-penalty",
          "depth": 3,
          "title": "DRY 重复罚分"
        },
        {
          "id": "exclude-top-choices-xtc",
          "depth": 3,
          "title": "排除首选 (XTC)"
        },
        {
          "id": "mirostat",
          "depth": 3,
          "title": "米罗司他"
        },
        {
          "id": "beam-search",
          "depth": 3,
          "title": "波束搜索"
        },
        {
          "id": "top-nsigma",
          "depth": 3,
          "title": "顶级尼西格玛"
        }
      ],
      "content": "# 通用设置\n\n这些设置控制使用语言模型生成文本时的采样过程。这些设置的含义对于所有支持的后端都是通用的。\n\n## 上下文设置\n\n### 响应（token）\n\nAPI 将生成用于响应的 token 的最大数量。\n\n- 响应长度越长，生成响应所需的时间就越长。\n- 如果API支持，您可以启用 `Streaming` 逐位显示正在生成的响应。\n- 当 `Streaming` 关闭后，响应将在完成后立即显示。\n\n### 上下文 (token)\n\nSillyTavern 将作为提示词发送到 API 的 token 的最大数量减去响应长度。\n\n- 上下文包括角色信息、系统提示词、聊天记录等。\n- 消息之间的虚线表示聊天的上下文范围。该线以上的消息不会发送到 AI。\n- 要在生成消息后查看上下文的组成，请单击 `Prompt Itemization` 消息选项（展开 `...` 菜单并单击带线条的方形图标）。\n\n## 采样器参数\n\n### 温度\n\n温度控制token选择的随机性：\n\n- 低温（<1.0）导致文本更可预测，有利于更高的概率 token\n- 高温（>1.0）通过为较低概率的 token 提供更好的机会来增加输出的创造力和多样性。\n\n将原始概率设置为 1。\n\n### 重复处罚\n\n尝试根据 token 在上下文中出现的频率对其进行惩罚，以遏制重复。\n\n将值设置为 1 可禁用其效果。\n\n#### 重复处罚范围\n\n最后生成的 token 中有多少个 token 将被考虑作为重复惩罚。如果设置得太高，可能会破坏响应，因为像“the、a、and”等常见单词将受到最严重的惩罚。\n\n将值设置为 0 可禁用其效果。\n\n#### 重复罚分斜率\n\n如果这和 `Repetition Penalty Range` 大于 0 时，重复惩罚将在提示词末尾产生更大的影响。值越高，效果越强。\n\n将值设置为 0 可禁用其效果。\n\n### 前K\n\nTop K 设置了可以选择的 top token 的最大数量。例如，如果 Top K 为 20，则这意味着仅保留排名最高的 20 个 token（无论它们的概率是多样的还是有限的）。\n\n设置为 0（或 -1，取决于您的后端）以禁用。\n\n### Top P\n\n顶部 P（又名核采样）将合计达到目标百分比所需的所有顶部 token 相加。如果前 2 个 token 均为 25%，且 Top P 为 0.50，则仅考虑前 2 个 token。\n\n将值设置为 1 可禁用其效果。\n\n### 典型P\n\n典型的 P 采样根据 token 与集合平均熵的偏差来确定优先级。它维护累积概率接近预定义阈值（例如0.5）的token，强调具有平均信息内容的那些。\n\n将值设置为 1 可禁用其效果。\n\n### 最小P\n\n通过切断相对于顶部 token 的低概率 token 来限制 token 池。产生更连贯的响应，但如果设置太高也会导致重复性恶化。\n\n- 在低值下效果最好，例如 `0.1-0.01`，但可以设置得更高 `Temperature`。例如： `Temperature: 5, Min P: 0.5`\n\n将值设置为 0 可禁用其效果。\n\n### 顶级A\n\nTop A 根据最高 token 概率的平方设置 token 选择的阈值。例如，如果 Top-A 值为 0.2，并且顶部 token 的概率为 50%，则排除概率低于 5% (0.2 \\* 0.5^2) 的 token。\n\n将值设置为 0 可禁用其效果。\n\n### 无尾采样\n\n无尾采样 (TFS) 通过使用导数分析 token 概率的变化率，在分布中搜索低概率 token 的尾部。它根据归一化二阶导数将 token 保留到阈值（例如 0.3）。越接近0，token被丢弃的越多。\n\n将值设置为 1 可禁用其效果。\n\n### 平滑因子\n\n使用二次变换增加高概率 token 的可能性，同时降低低概率 token 的可能性。旨在产生更具创造性的反应，无论 `Temperature`.\n\n- 在没有截断采样器的情况下效果最好，例如 `Top K`, `Top P`, `Min P`等\n\n将值设置为 0 可禁用其效果。\n\n### 动态温度\n\n根据顶部 token 的可能性动态缩放温度。旨在在不牺牲一致性的情况下产生更多创意输出。\n\n- 接受从最低到最高的温度范围。例如： `Minimum Temp: 0.75` 和 `Minimum Temp: 1.25`\n- `Exponent` 应用基于顶部 token 的指数曲线。\n\n取消勾选即可禁用其效果。\n\n### 厄普西隆截止\n\nEpsilon 截止设置了一个概率下限，低于该下限则 token 被排除在采样之外。以1e-4为单位；合理的值为 3。\n\n设置为 0 以禁用。\n\n### 埃塔截止值\n\nEta截止是特殊Eta采样技术的主要参数。以1e-4为单位；合理的值为 3。请参阅论文 [Hewitt 等人将截断采样作为语言模型去平滑。 (2022)](https://arxiv.org/abs/2210.15191) 了解详情。\n\n设置为 0 以禁用。\n\n### DRY 重复罚分\n\nDRY 对 token 进行惩罚，因为 token 会将输入的末尾扩展为先前在输入中出现的序列。如果您想允许逐字重复某些序列（例如名称），您可以将它们添加到序列破坏者列表中。查看拉取请求 [这里](https://github.com/oobabooga/text-generation-webui/pull/5677).\n\n将乘数设置为 0 以禁用。\n\n### 排除首选 (XTC)\n\nXTC 采样算法将最可能的 token 排除在考虑范围之外，而不是修剪最不可能的 token。它会删除除最不可能以给定概率满足给定阈值的 token 之外的所有内容。这确保了至少一个“可行”的选择得以保留，并保持了一致性。查看拉取请求 [这里](https://github.com/oobabooga/text-generation-webui/pull/6335).\n\n将概率设置为 0 以禁用。\n\n### 米罗司他\n\nMirostat 将输出困惑度与输入困惑度相匹配，从而避免重复陷阱（当自回归推理生成文本时，输出的困惑度趋于零）和混淆陷阱（困惑度发散）。详细信息请参阅论文 [Mirostat：一种直接控制困惑度的神经文本解码算法，作者：Basu 等人。 (2020)](https://arxiv.org/abs/2007.14966).\n\n模式选择 Mirostat 版本。\n\n- 0 = 禁用，\n- 1 = Mirostat 1.0（仅限 llama.cpp），\n- 2 = 米罗他2.0。\n\n### 波束搜索\n\nLLM 采样中使用的贪婪暴力算法，用于查找最可能的单词序列或 token。它一次扩展多个候选序列，在每一步保持固定数量（波束宽度）的顶部序列。\n\n### 顶级尼西格玛\n\n一种根据统计属性过滤逻辑的采样方法。它将 token 保持在最大 logit 值的 n 个标准偏差内，为 top-p/top-k 采样提供更简单的替代方案，同时保持不同温度下的采样稳定性。\n",
      "searchText": "通用设置 这些设置控制使用语言模型生成文本时的采样过程。这些设置的含义对于所有支持的后端都是通用的。 上下文设置 响应（token） API 将生成用于响应的 token 的最大数量。 响应长度越长，生成响应所需的时间就越长。 如果API支持，您可以启用 Streaming 逐位显示正在生成的响应。 当 Streaming 关闭后，响应将在完成后立即显示。 上下文 (token) SillyTavern 将作为提示词发送到 API 的 token 的最大数量减去响应长度。 上下文包括角色信息、系统提示词、聊天记录等。 消息之间的虚线表示聊天的上下文范围。该线以上的消息不会发送到 AI。 要在生成消息后查看上下文的组成，请单击 Prompt Itemization 消息选项（展开 ... 菜单并单击带线条的方形图标）。 采样器参数 温度 温度控制token选择的随机性： 低温（<1.0）导致文本更可预测，有利于更高的概率 token 高温（>1.0）通过为较低概率的 token 提供更好的机会来增加输出的创造力和多样性。 将原始概率设置为 1。 重复处罚 尝试根据 token 在上下文中出现的频率对其进行惩罚，以遏制重复。 将值设置为 1 可禁用其效果。 重复处罚范围 最后生成的 token 中有多少个 token 将被考虑作为重复惩罚。如果设置得太高，可能会破坏响应，因为像“the、a、and”等常见单词将受到最严重的惩罚。 将值设置为 0 可禁用其效果。 重复罚分斜率 如果这和 Repetition Penalty Range 大于 0 时，重复惩罚将在提示词末尾产生更大的影响。值越高，效果越强。 将值设置为 0 可禁用其效果。 前K Top K 设置了可以选择的 top token 的最大数量。例如，如果 Top K 为 20，则这意味着仅保留排名最高的 20 个 token（无论它们的概率是多样的还是有限的）。 设置为 0（或 -1，取决于您的后端）以禁用。 Top P 顶部 P（又名核采样）将合计达到目标百分比所需的所有顶部 token 相加。如果前 2 个 token 均为 25%，且 Top P 为 0.50，则仅考虑前 2 个 token。 将值设置为 1 可禁用其效果。 典型P 典型的 P 采样根据 token 与集合平均熵的偏差来确定优先级。它维护累积概率接近预定义阈值（例如0.5）的token，强调具有平均信息内容的那些。 将值设置为 1 可禁用其效果。 最小P 通过切断相对于顶部 token 的低概率 token 来限制 token 池。产生更连贯的响应，但如果设置太高也会导致重复性恶化。 在低值下效果最好，例如 0.1-0.01，但可以设置得更高 Temperature。例如： Temperature: 5, Min P: 0.5 将值设置为 0 可禁用其效果。 顶级A Top A 根据最高 token 概率的平方设置 token 选择的阈值。例如，如果 Top-A 值为 0.2，并且顶部 token 的概率为 50%，则排除概率低于 5% (0.2 * 0.5^2) 的 token。 将值设置为 0 可禁用其效果。 无尾采样 无尾采样 (TFS) 通过使用导数分析 token 概率的变化率，在分布中搜索低概率 token 的尾部。它根据归一化二阶导数将 token 保留到阈值（例如 0.3）。越接近0，token被丢弃的越多。 将值设置为 1 可禁用其效果。 平滑因子 使用二次变换增加高概率 token 的可能性，同时降低低概率 token 的可能性。旨在产生更具创造性的反应，无论 Temperature. 在没有截断采样器的情况下效果最好，例如 Top K, Top P, Min P等 将值设置为 0 可禁用其效果。 动态温度 根据顶部 token 的可能性动态缩放温度。旨在在不牺牲一致性的情况下产生更多创意输出。 接受从最低到最高的温度范围。例如： Minimum Temp: 0.75 和 Minimum Temp: 1.25 Exponent 应用基于顶部 token 的指数曲线。 取消勾选即可禁用其效果。 厄普西隆截止 Epsilon 截止设置了一个概率下限，低于该下限则 token 被排除在采样之外。以1e-4为单位；合理的值为 3。 设置为 0 以禁用。 埃塔截止值 Eta截止是特殊Eta采样技术的主要参数。以1e-4为单位；合理的值为 3。请参阅论文 Hewitt 等人将截断采样作为语言模型去平滑。 (2022) 了解详情。 设置为 0 以禁用。 DRY 重复罚分 DRY 对 token 进行惩罚，因为 token 会将输入的末尾扩展为先前在输入中出现的序列。如果您想允许逐字重复某些序列（例如名称），您可以将它们添加到序列破坏者列表中。查看拉取请求 这里. 将乘数设置为 0 以禁用。 排除首选 (XTC) XTC 采样算法将最可能的 token 排除在考虑范围之外，而不是修剪最不可能的 token。它会删除除最不可能以给定概率满足给定阈值的 token 之外的所有内容。这确保了至少一个“可行”的选择得以保留，并保持了一致性。查看拉取请求 这里. 将概率设置为 0 以禁用。 米罗司他 Mirostat 将输出困惑度与输入困惑度相匹配，从而避免重复陷阱（当自回归推理生成文本时，输出的困惑度趋于零）和混淆陷阱（困惑度发散）。详细信息请参阅论文 Mirostat：一种直接控制困惑度的神经文本解码算法，作者：Basu 等人。 (2020). 模式选择 Mirostat 版本。 0 = 禁用， 1 = Mirostat 1.0（仅限 llama.cpp）， 2 = 米罗他2.0。 波束搜索 LLM 采样中使用的贪婪暴力算法，用于查找最可能的单词序列或 token。它一次扩展多个候选序列，在每一步保持固定数量（波束宽度）的顶部序列。 顶级尼西格玛 一种根据统计属性过滤逻辑的采样方法。它将 token 保持在最大 logit 值的 n 个标准偏差内，为 top-p/top-k 采样提供更简单的替代方案，同时保持不同温度下的采样稳定性。",
      "translationStatus": "machine-draft"
    },
    {
      "slug": "core-concepts/macros",
      "title": "宏",
      "group": "Usage",
      "order": 140,
      "source": "Usage/macros.md",
      "sourceUrl": "https://docs.sillytavern.app/usage/core-concepts/macros/",
      "sourceSha256": "866dee2ec613f56e9c1c8d3008f93e936f2ee5c79fdf48a89537b71a326c6fc3",
      "headings": [
        {
          "id": "macros",
          "depth": 1,
          "title": "宏"
        },
        {
          "id": "finding-available-macros",
          "depth": 2,
          "title": "查找可用的宏"
        },
        {
          "id": "macro-autocomplete",
          "depth": 3,
          "title": "宏自动完成"
        },
        {
          "id": "basic-syntax",
          "depth": 2,
          "title": "基本语法"
        },
        {
          "id": "arguments",
          "depth": 2,
          "title": "论点"
        },
        {
          "id": "space-separator",
          "depth": 3,
          "title": "空间分隔符"
        },
        {
          "id": "double-colon-separator",
          "depth": 3,
          "title": "双冒号分隔符"
        },
        {
          "id": "single-colon-separator-legacy",
          "depth": 3,
          "title": "单冒号分隔符（旧版）"
        },
        {
          "id": "whitespace-in-macro-definitions",
          "depth": 2,
          "title": "宏定义中的空格"
        },
        {
          "id": "nested-macros",
          "depth": 2,
          "title": "嵌套宏"
        },
        {
          "id": "scoped-macros",
          "depth": 2,
          "title": "作用域宏"
        },
        {
          "id": "scoped-syntax",
          "depth": 3,
          "title": "作用域语法"
        },
        {
          "id": "examples",
          "depth": 3,
          "title": "示例"
        },
        {
          "id": "content-trimming",
          "depth": 3,
          "title": "内容修剪"
        },
        {
          "id": "conditional-macros",
          "depth": 2,
          "title": "条件宏"
        },
        {
          "id": "simple-condition",
          "depth": 3,
          "title": "简单条件"
        },
        {
          "id": "using-variable-shorthands-in-conditions",
          "depth": 3,
          "title": "在条件中使用变量简写"
        },
        {
          "id": "inverted-condition",
          "depth": 3,
          "title": "倒置条件"
        },
        {
          "id": "ifelse-branches",
          "depth": 3,
          "title": "If/Else 分支"
        },
        {
          "id": "macro-flags",
          "depth": 2,
          "title": "宏标志"
        },
        {
          "id": "syntax",
          "depth": 3,
          "title": "语法"
        },
        {
          "id": "implemented-flags",
          "depth": 3,
          "title": "实施的标志"
        },
        {
          "id": "planned-flags-not-yet-implemented",
          "depth": 3,
          "title": "计划中的标志（尚未实施）"
        },
        {
          "id": "flags-like-prefix-operators",
          "depth": 3,
          "title": "类似标志的前缀运算符"
        },
        {
          "id": "preserve-whitespace-flag",
          "depth": 3,
          "title": "保留空白标志"
        },
        {
          "id": "comments",
          "depth": 2,
          "title": "评论"
        },
        {
          "id": "escaping-macros",
          "depth": 2,
          "title": "转义宏"
        },
        {
          "id": "variable-shorthands",
          "depth": 2,
          "title": "变量简写"
        },
        {
          "id": "variable-shorthands-prefixes",
          "depth": 3,
          "title": "可变速记前缀"
        },
        {
          "id": "variable-names",
          "depth": 3,
          "title": "变量名称"
        },
        {
          "id": "nested-macros-in-values",
          "depth": 3,
          "title": "值中的嵌套宏"
        },
        {
          "id": "whitespace-handling",
          "depth": 3,
          "title": "空白处理"
        },
        {
          "id": "variable-shorthand-operators",
          "depth": 3,
          "title": "变量速记运算符"
        },
        {
          "id": "get-variable",
          "depth": 4,
          "title": "获取变量"
        },
        {
          "id": "set-variable",
          "depth": 4,
          "title": "设置变量"
        },
        {
          "id": "increment",
          "depth": 4,
          "title": "增量"
        },
        {
          "id": "decrement",
          "depth": 4,
          "title": "递减"
        },
        {
          "id": "add",
          "depth": 4,
          "title": "添加"
        },
        {
          "id": "subtract",
          "depth": 4,
          "title": "减去"
        },
        {
          "id": "logical-or",
          "depth": 4,
          "title": "逻辑或"
        },
        {
          "id": "nullish-coalescing",
          "depth": 4,
          "title": "空值合并"
        },
        {
          "id": "logical-or-assign",
          "depth": 4,
          "title": "逻辑或赋值"
        },
        {
          "id": "nullish-coalescing-assign",
          "depth": 4,
          "title": "空合并赋值"
        },
        {
          "id": "equals",
          "depth": 4,
          "title": "等于"
        },
        {
          "id": "not-equals",
          "depth": 4,
          "title": "不等于"
        },
        {
          "id": "greater-than",
          "depth": 4,
          "title": "大于"
        },
        {
          "id": "greater-than-or-equal",
          "depth": 4,
          "title": "大于或等于"
        },
        {
          "id": "less-than",
          "depth": 4,
          "title": "小于"
        },
        {
          "id": "less-than-or-equal",
          "depth": 4,
          "title": "小于或等于"
        },
        {
          "id": "legacy-syntax",
          "depth": 2,
          "title": "遗留语法"
        },
        {
          "id": "common-macros-by-category",
          "depth": 2,
          "title": "常用宏（按类别）"
        },
        {
          "id": "names--participants",
          "depth": 3,
          "title": "姓名及参与者"
        },
        {
          "id": "character-card--persona-fields",
          "depth": 3,
          "title": "角色卡和用户人设字段"
        },
        {
          "id": "chat-history--messages",
          "depth": 3,
          "title": "聊天记录和消息"
        },
        {
          "id": "time--date",
          "depth": 3,
          "title": "时间和日期"
        },
        {
          "id": "variables",
          "depth": 3,
          "title": "变量"
        },
        {
          "id": "randomization",
          "depth": 3,
          "title": "随机化"
        },
        {
          "id": "runtime-state",
          "depth": 3,
          "title": "运行时状态"
        },
        {
          "id": "prompt-templates",
          "depth": 3,
          "title": "提示词模板"
        },
        {
          "id": "utility",
          "depth": 3,
          "title": "实用性"
        }
      ],
      "content": "# 宏\n\n> **实验宏引擎**\n>\n> 实验宏引擎支持嵌套、稳定的替换顺序和其他改进。对于新安装，它默认启用。现有的安装可以启用它 **用户设置** > **聊天/消息处理** > **实验宏引擎**.\n\n宏是动态占位符，在处理文本时会替换为实际值。它们在提示词、角色卡、知识手册、快速回复等中的整个 SillyTavern 中使用。\n\n## 查找可用的宏\n\nSillyTavern 提供所有可用宏的内置文档：\n\n- **斜线命令**：类型 `/? macros` 在聊天输入中显示所有已注册宏及其描述的列表。\n- **自动完成**：参见 [宏自动完成](#macro-autocomplete) 有关在打字时获取建议的详细信息，请参阅下文。\n\n### 宏自动完成\n\n宏自动完成功能会在您键入时提供可用宏的建议。它适用于整个 SillyTavern 支持宏的所有文本字段。\n\n类型 `{{` 启动宏的自动完成，显示可用的宏及其参数，潜在的 [宏标志](#macro-flags), [变量简写](#variable-shorthands)，等等。\n\n**默认情况下出现自动完成的位置：**\n\n- 聊天用户输入框\n- 扩展编辑器（全屏文本编辑，通过文本字段旁边的“扩展”按钮打开）\n- 提示词经理编辑\n\n**在其他字段中触发自动完成：**\n\n- 新闻 **Ctrl+空格键** 在任何支持宏的文本字段中打开自动完成弹出窗口\n- 启用 **设置 → 自动完成设置 → 在所有宏字段中显示** 让自动完成功能自动出现在所有宏字段中\n\n## 基本语法\n\n宏包含在双花括号中：\n\n```txt\n{{macroName}}\n```\n\n宏名称是 **不区分大小写**. `{{User}}`, `{{USER}}`, 和 `{{user}}` 全部解析为同一个宏。\n\n示例：\n\n```txt\n{{user}}        // Returns the current user/persona name\n{{char}}        // Returns the current character name\n{{time}}        // Returns the current time\n{{date}}        // Returns the current date\n```\n\n## 论点\n\n许多宏接受参数来自定义其行为。\n\n### 空间分隔符\n\n对于具有单个参数的宏，可以使用空格将宏名称与其参数分隔开：\n\n```txt\n{{macroName argument}}\n```\n\n示例：\n\n```txt\n{{getvar myVariable}}\n{{roll 1d20}}\n{{reverse Hello World}}\n```\n\n### 双冒号分隔符\n\n使用 `::` 分隔多个参数：\n\n```txt\n{{macroName::arg1::arg2::arg3}}\n```\n\n示例：\n\n```txt\n{{setvar::myVariable::Hello World}}\n{{random::red::green::blue}}\n{{roll::2d6+3}}\n```\n\n无论是空间还是 `::` 是宏参数的推荐语法。\n\n### 单冒号分隔符（旧版）\n\n单个 `:` 也可以引入参数，但此语法被视为遗留语法，不建议用于新内容：\n\n```txt\n{{macroName:argument}}\n```\n\n示例：\n\n```txt\n{{roll:1d20}}\n```\n\n## 宏定义中的空格\n\n宏名称、分隔符和参数之间的空格将被忽略。这允许更易读的格式：\n\n```txt\n{{ macroName :: arg1 :: arg2 }}\n{{ setvar :: myVariable :: some value }}\n{{ if :: condition }}\n```\n\n以上所有内容都相当于它们的紧凑形式，没有额外的空格。\n\n## 嵌套宏\n\n宏可以嵌套在其他宏中。首先解析内部宏：\n\n```txt\n{{getvar::{{char}}_mood}}\n```\n\n这首先解决 `{{char}}` （例如，“Alice”），然后解析 `{{getvar::Alice_mood}}`.\n\n更多示例：\n\n```txt\n{{setvar::greeting::Hello, {{user}}!}}\n```\n\n设置一个变量，其内容包括用户名。\n\n```txt\n{{if {{getvar::showDetails}}}}Details here{{/if}}\n```\n\n条件本身是一个检索变量值的宏。\n\n## 作用域宏\n\n任何接受至少一个参数的宏都支持作用域语法。开始标签和结束标签之间的内容成为 **最后一个论点** 的宏。\n\n### 作用域语法\n\n可以将最后一个参数放在开始和结束标记之间，而不是内联编写：\n\n```txt\n{{macroName argument}}\n  scoped content here\n{{/macroName}}\n```\n\n结束标签使用 `/` 宏名称前的标志： `{{/macroName}}`.\n\n这相当于写：\n\n```txt\n{{macroName::argument::scoped content here}}\n```\n\n### 示例\n\n设置具有多行内容的变量：\n\n```txt\n{{ setvar backstory }}\n  This character was born in a small village\n  and grew up to become a renowned scholar.\n{{ /setvar }}\n```\n\n使用 `reverse` 具有范围内容：\n\n```txt\n{{ reverse }}\n  Hello World\n{{ /reverse }}\n```\n\n这将返回“dlroW olleH”。\n\n### 内容修剪\n\n默认情况下，范围内的内容会自动修剪：\n\n- 前导和尾随空格被删除\n- 一致的缩进被取消缩进（从所有行中删除第一个非空行的缩进）\n\n这允许干净的格式：\n\n```txt\n{{ if condition }}\n    # Heading\n    Some content here\n{{ /if }}\n```\n\n生产 `# Heading\\nSome content here` （没有前导空格）。\n\n要保留所有空白，包括前导/尾随换行符，请使用 `#` 标志。参见 [宏标志](#macro-flags) 了解详情。\n\n## 条件宏\n\n的 `{{if}}` 宏根据值是真还是假有条件地呈现内容。\n\n### 简单条件\n\n```txt\n{{ if description }}\n  # Character Description\n  {{ description }}\n{{ /if }}\n```\n\n仅当出现以下情况时，才会显示标题和说明： `description` 返回一个非空值。\n\n条件可以是：\n\n- 宏名称（如果不需要参数，则自动解析）\n- 来自嵌套宏的任何值，例如 `{{getvar::flag}}`\n- 变量简写如 `.myFlag` 或 `$globalFlag` （见 [变量简写](#variable-shorthands))\n- 您想要的任何文本（将根据其内容隐式解析为真或假）\n\n虚假值：空字符串， `false`, `0`, `off`, `no`.\n\n### 在条件中使用变量简写\n\n变量简写提供了一种检查条件中变量值的简洁方法：\n\n```txt\n{{ if .isEnabled }}\n  Feature is enabled.\n{{ /if }}\n\n{{ if !$globalDisabled }}\n  Not globally disabled.\n{{ /if }}\n```\n\n参见 [变量简写](#variable-shorthands) 有关速记符号的更多详细信息。\n\n### 倒置条件\n\n条件前缀为 `!` 反转它：\n\n```txt\n{{ if !personality }}\n  No personality defined for this character.\n{{ /if }}\n```\n\n### If/Else 分支\n\n使用 `{{else}}` 里面一个 `{{if}}` 块来定义替代分支：\n\n```txt\n{{ if personality }}\n  {{ personality }}\n{{ else }}\n  No personality defined.\n{{ /if }}\n```\n\n另一个例子：\n\n```txt\n{{ if {{getvar::details-block}} }}\n  # Details Block\n  {{ getvar::details-block }}\n{{ else }}\n  No details currently exist.\n{{ /if }}\n```\n\n## 宏标志\n\n标志是放置在左大括号和宏名称之间的特殊符号角色，用于修改宏行为。\n\n### 语法\n\n```txt\n{{!macroName}}\n{{#macroName}}\n```\n\n标志可以组合：\n\n```txt\n{{!?macroName}}\n```\n\n标志和宏名称之间允许有空格：\n\n```txt\n{{ / macroName }}\n{{ # macroName }}\n```\n\n### 实施的标志\n\n| 旗帜  | 名称   | 描述                        |\n| --- | ---- | ------------------------- |\n| `/` | 封闭块  | 标记作用域宏的结束标记。示例： `{{/if}}` |\n| `#` | 保留空白 | 防止自动修剪范围内的内容。             |\n\n### 计划中的标志（尚未实施）\n\n| 旗帜  | 名称   | 描述                |\n| --- | ---- | ----------------- |\n| `!` | 立即   | 在同一文本中的其他宏之前解析此宏。 |\n| `?` | 延误   | 在同一文本中的其他宏之后解析该宏。 |\n| `~` | 重新评估 | 标记此宏以进行重新评估。      |\n| `>` | 过滤器  | 为此宏启用基于管道的输出过滤器。  |\n\n### 类似标志的前缀运算符\n\n变量速记语法使用前缀运算符 (`.` 和 `$`）其行为与标志类似，但本身不是标志。\\\n请参阅 [变量简写](#variable-shorthands) 部分了解详细信息。\n\n### 保留空白标志\n\n使用 `#` 当您需要保留作用域内容中的所有空格（包括前导/尾随换行符和缩进）时进行标记：\n\n```txt\n{{ # setvar code }}\n    function hello() {\n        return \"world\";\n    }\n{{ /setvar }}\n```\n\n没有 `#`，内容将被修剪和缩进。与 `#`，所有空白都完全按照写入方式保留，包括开始标记之后和结束标记之前的换行符。\n\n## 评论\n\n使用注释宏添加不会出现在输出中的注释：\n\n```txt\n{{// This is a comment and will be removed}}\n```\n\n对于多行注释，请使用作用域语法：\n\n```txt\n{{ // }}\n  This entire block is a comment.\n  It can span multiple lines.\n{{ /// }}\n```\n\n## 转义宏\n\n要在没有宏分辨率的情况下显示文字大括号，请使用反斜杠对其进行转义：\n\n```txt\n\\{\\{notAMacro\\}\\}\n```\n\n这输出 `{{notAMacro}}` 作为纯文本。\n\n## 变量简写\n\n变量简写为常见变量操作提供了简洁的语法。使用 `.` 对于局部变量和 `$` 对于全局变量。\n\n### 可变速记前缀\n\n| 前缀  | 名称   | 描述                         |\n| --- | ---- | -------------------------- |\n| `.` | 局部变量 | 局部变量操作的简写。示例： `{{.myvar}}` |\n| `$` | 全局变量 | 全局变量操作的简写。示例： `{{$myvar}}` |\n\n必须放置这些前缀运算符 **就在之前** 变量名称，在任何可选出现之后 [宏标志](#macro-flags)。它们不被视为宏标志，而是更多指示正在插入变量速记，而不是按名称插入宏。前缀运算符不是变量名本身的一部分，而是更改变量访问方式的修饰符。\n\n### 变量名称\n\n变量名称遵循与宏标识符相同的规则：以字母开头，后跟字母、数字、下划线或连字符。最后一个角色不允许是下划线或连字符。\n\n```txt\n{{.my-var}}       // Valid\n{{.my_var}}       // Valid\n{{.myVar123}}     // Valid\n```\n\n如果您的变量具有不符合标准规则的标识符，则必须使用完整的变量宏语法（例如 `{{getvar::my§var----}}`），或重命名/移动您的变量值。\n\n### 值中的嵌套宏\n\n变量值可以包含嵌套宏：\n\n```txt\n{{.greeting = Hello, {{user}}!}}\n```\n\n解析为保存的变量 `Hello, User!` 里面。 （如果 `{{user}}` 被命名为“用户”）\n\n### 空白处理\n\n运算符周围允许有空格：\n\n```txt\n{{ .myvar = spaced value }}\n{{ .counter ++ }}\n```\n\n### 变量速记运算符\n\n以下运算符可与变量简写一起使用。每个操作员都遵循模式 `{{.varName operator value}}` 或 `{{$varName operator value}}`.\n\n| 操作员   | 名称                                  | 示例                      | 描述                          |         |   |          |                 |\n| ----- | ----------------------------------- | ----------------------- | --------------------------- | ------- | - | -------- | --------------- |\n| *（无）* | [获取](#get-variable)                 | `{{.myvar}}`            | 返回变量值                       |         |   |          |                 |\n| `=`   | [套装](#set-variable)                 | `{{.myvar = value}}`    | 将变量设置为一个值，不返回任何内容           |         |   |          |                 |\n| `++`  | [增量](#increment)                    | `{{.counter++}}`        | 加 1，返回新值                    |         |   |          |                 |\n| `--`  | [递减](#decrement)                    | `{{.counter--}}`        | 减 1，返回新值                    |         |   |          |                 |\n| `+=`  | [添加](#add)                          | `{{.score += 10}}`      | 添加到变量（数字或字符串连接），不返回任何内容     |         |   |          |                 |\n| `-=`  | [减去](#subtract)                     | `{{.health -= 5}}`      | 从变量中减去（仅限数字），不返回任何内容        |         |   |          |                 |\n| \\`    |                                     | \\`                      | [逻辑或](#logical-or)          | \\`{{.名称 |   | 来宾}}\\`   | 如果变量为假则返回回退     |\n| `??`  | [空值合并](#nullish-coalescing)         | `{{.name ?? Guest}}`    | 仅当变量未定义时返回后备                |         |   |          |                 |\n| \\`    |                                     | =\\`                     | [逻辑或赋值](#logical-or-assign) | \\`{{.名称 |   | = 客人}}\\` | 如果变量为假则设置值，返回新值 |\n| `??=` | [空合并赋值](#nullish-coalescing-assign) | `{{.name ??= Guest}}`   | 仅当变量未定义时设置值，返回新值            |         |   |          |                 |\n| `==`  | [等于](#equals)                       | `{{.status == active}}` | 比较值，返回 `\"true\"` 或 `\"false\"` |         |   |          |                 |\n| `!=`  | [不等于](#not-equals)                  | `{{.status != active}}` | 比较值，返回 `\"true\"` 如果不等于       |         |   |          |                 |\n| `>`   | [大于](#greater-than)                 | `{{.score > 50}}`       | 退货 `\"true\"` 如果变量大于值         |         |   |          |                 |\n| `>=`  | [大于或等于](#greater-than-or-equal)     | `{{.level >= 10}}`      | 退货 `\"true\"` 如果变量大于或等于值      |         |   |          |                 |\n| `<`   | [小于](#less-than)                    | `{{.health < 20}}`      | 退货 `\"true\"` 如果变量小于值         |         |   |          |                 |\n| `<=`  | [小于或等于](#less-than-or-equal)        | `{{.health <= 0}}`      | 退货 `\"true\"` 如果变量小于或等于值      |         |   |          |                 |\n\n#### 获取变量\n\n使用简单的前缀检索变量值：\n\n```txt\n{{.myvar}}       // Get local variable \"myvar\"\n{{$myvar}}       // Get global variable \"myvar\"\n```\n\n相当于 `{{getvar::myvar}}` 和 `{{getglobalvar::myvar}}`.\n\n#### 设置变量\n\n使用 `=` 运算符设置变量值：\n\n```txt\n{{ .myvar = Hello World }}     // Set local variable\n{{ $myvar = Some value }}      // Set global variable\n```\n\n相当于 `{{setvar::myvar::Hello World}}` 和 `{{setglobalvar::myvar::Hello World}}`。返回一个空字符串。\n\n#### 增量\n\n使用 `++` 将数值变量加 1：\n\n```txt\n{{.counter++}}    // Increment local variable, returns new value\n{{$counter++}}    // Increment global variable, returns new value\n```\n\n相当于 `{{incvar counter}}` 和 `{{incglobalvar counter}}`。返回递增后的新值。\n\n#### 递减\n\n使用 `--` 将数值变量减 1：\n\n```txt\n{{.counter--}}    // Decrement local variable, returns new value\n{{$counter--}}    // Decrement global variable, returns new value\n```\n\n相当于 `{{decvar counter}}` 和 `{{decglobalvar counter}}`。返回递减后的新值。\n\n#### 添加\n\n使用 `+=` 向变量添加数值：\n\n```txt\n{{.score += 10}}     // Add 10 to local variable\n{{$total += 5}}      // Add 5 to global variable\n```\n\n相当于 `{{addvar::score::10}}` 和 `{{addglobalvar::total::5}}`。返回一个空字符串。\n\nadd 运算符还支持将字符串附加到现有字符串变量（如果它们都不是数字）：\n\n```txt\n{{.myvar += {{noop}} | Second block}}   // Resolves to \"Content | Second block\" when the variable before was \"Content\".\n                                        // Use `{{noop}}` to be able to add whitespaces, that otherwise would be trimmed automatically.\n```\n\n#### 减去\n\n使用 `-=` 从变量中减去数值：\n\n```txt\n{{.health -= 10}}    // Subtract 10 from local variable\n{{$points -= 5}}     // Subtract 5 from global variable\n```\n\n相当于 `{{addvar::score::10}}` 和 `{{addglobalvar::total::5}}`，但带有负数/倒数。返回一个空字符串。\n如果该值不是有效数字，则会记录警告并且变量不会更改。\n\n#### 逻辑或\n\n使用 `||` 当变量为假时提供后备值（空字符串， `0`, `false`):\n\n```txt\n{{.name || Anonymous}}     // Returns \"Anonymous\" if .name is empty or falsy\n{{$setting || default}}    // Returns \"default\" if $setting is falsy\n```\n\n如果为真则返回变量值，否则返回后备值。后备方案是 **仅在需要时进行评估** （惰性评估）。\n\n#### 空值合并\n\n使用 `??` 仅当变量不存在时提供后备值：\n\n```txt\n{{.name ?? Guest}}         // Returns \"Guest\" only if .name is not defined\n{{$config ?? default}}     // Returns \"default\" only if $config doesn't exist\n```\n\n不像 `||`，这会返回变量值，即使它是假的（空字符串， `0`, `false`) — 只要变量存在。后备方案是 **仅在需要时进行评估** （惰性评估）。\n\n#### 逻辑或赋值\n\n使用 `||=` 仅当变量当前为假值时才将其设置为值：\n\n```txt\n{{.name ||= Anonymous}}    // Sets and returns \"Anonymous\" if .name is falsy\n{{$count ||= 0}}           // Sets and returns \"0\" if $count is falsy\n```\n\n如果变量已经为真，则返回当前值而不进行修改。返回最终值（现有值或新设置的值）。\n\n#### 空合并赋值\n\n使用 `??=` 仅当变量不存在时才将其设置为值：\n\n```txt\n{{.name ??= Guest}}        // Sets and returns \"Guest\" only if .name is undefined\n{{$config ??= default}}    // Sets and returns \"default\" only if $config doesn't exist\n```\n\n不像 `||=`，这保留了虚假值（空字符串， `0`, `false`) 如果变量已经存在。返回最终值（现有值或新设置的值）。\n\n#### 等于\n\n使用 `==` 将变量值与另一个值进行比较：\n\n```txt\n{{.status == active}}      // Returns \"true\" if .status equals \"active\", otherwise \"false\"\n{{$mode == dark}}          // Returns \"true\" if $mode equals \"dark\", otherwise \"false\"\n```\n\n执行字符串比较并返回文字字符串 `\"true\"` 或 `\"false\"`.\\\n将不存在的变量、空变量和空变量视为相同。\n\n有用于 `{{if}}` 条件：\n\n```txt\n{{if {{.status == active}} }}Active mode{{/if}}\n```\n\n#### 不等于\n\n使用 `!=` 将一个变量值与另一个值进行比较以确定是否不相等：\n\n```txt\n{{.status != inactive}}    // Returns \"true\" if .status is NOT \"inactive\", otherwise \"false\"\n{{$mode != light}}         // Returns \"true\" if $mode is NOT \"light\", otherwise \"false\"\n```\n\n执行字符串比较并返回 `\"true\"` 如果值不同， `\"false\"` 如果它们相等。\\\n将不存在的变量、空变量和空变量视为相同。\n\n有用于 `{{if}}` 条件：\n\n```txt\n{{if {{.status != disabled}} }}Feature enabled{{/if}}\n```\n\n#### 大于\n\n使用 `>` 检查变量的数值是否大于另一个值：\n\n```txt\n{{.score > 50}}        // Returns \"true\" if .score is greater than 50\n{{$level > 5}}         // Returns \"true\" if $level is greater than 5\n```\n\n执行数字比较并返回文字字符串 `\"true\"` 或 `\"false\"`.\n\n有用于 `{{if}}` 条件：\n\n```txt\n{{if {{.score > 100}} }}High score!{{/if}}\n```\n\n#### 大于或等于\n\n使用 `>=` 检查变量的数值是否大于或等于另一个值：\n\n```txt\n{{.level >= 10}}       // Returns \"true\" if .level is at least 10\n{{$points >= 100}}     // Returns \"true\" if $points is 100 or more\n```\n\n执行数字比较并返回文字字符串 `\"true\"` 或 `\"false\"`.\n\n有用于 `{{if}}` 条件：\n\n```txt\n{{if {{$level >= 10}} }}Unlocked advanced features{{/if}}\n```\n\n#### 小于\n\n使用 `<` 检查变量的数值是否小于另一个值：\n\n```txt\n{{.health < 20}}       // Returns \"true\" if .health is below 20\n{{$timer < 0}}         // Returns \"true\" if $timer is negative\n```\n\n执行数字比较并返回文字字符串 `\"true\"` 或 `\"false\"`.\n\n有用于 `{{if}}` 条件：\n\n```txt\n{{if {{.health < 20}} }}Low health warning!{{/if}}\n```\n\n#### 小于或等于\n\n使用 `<=` 检查变量的数值是否小于或等于另一个值：\n\n```txt\n{{.health <= 0}}       // Returns \"true\" if .health is 0 or below\n{{$attempts <= 3}}     // Returns \"true\" if $attempts is 3 or fewer\n```\n\n执行数字比较并返回文字字符串 `\"true\"` 或 `\"false\"`.\n\n有用于 `{{if}}` 条件：\n\n```txt\n{{if {{.health <= 0}} }}Game over{{/if}}\n```\n\n## 遗留语法\n\n为了向后兼容，仍然支持尖括号标记：\n\n| 遗产                 | 等效宏                  |\n| ------------------ | -------------------- |\n| `<USER>`           | `{{user}}`           |\n| `<BOT>`            | `{{char}}`           |\n| `<CHAR>`           | `{{char}}`           |\n| `<GROUP>`          | `{{group}}`          |\n| `<CHARIFNOTGROUP>` | `{{charIfNotGroup}}` |\n\n这些在处理过程中会自动转换为其宏等效项。\n\n> **注意：** 不建议使用旧语法。使用等效的 `{{macro}}` 语法代替新内容。\n\n## 常用宏（按类别）\n\n> 使用 `/? macros` 有关可用宏的完整列表及其详细说明。\n\n### 姓名及参与者\n\n| 宏                    | 描述                              |\n| -------------------- | ------------------------------- |\n| `{{user}}`           | 当前用户/用户人设名称                     |\n| `{{char}}`           | 当前角色名称                          |\n| `{{group}}`          | 以逗号分隔的群组成员姓名列表（包括静音）或单独聊天中的角色姓名 |\n| `{{groupNotMuted}}`  | 以逗号分隔的群组成员名称列表，不包括静音成员          |\n| `{{charIfNotGroup}}` | 角色名称（组内为空）                      |\n| `{{notChar}}`        | 除当前发言者外的所有参与者的逗号分隔列表            |\n\n### 角色卡和用户人设字段\n\n| 宏                      | 描述                                                      |\n| ---------------------- | ------------------------------------------------------- |\n| `{{description}}`      | 角色说明                                                    |\n| `{{personality}}`      | 角色个性                                                    |\n| `{{scenario}}`         | 角色场景                                                    |\n| `{{persona}}`          | 用户用户人设描述                                                |\n| `{{charPrompt}}`       | 角色的主提示词覆盖                                               |\n| `{{charInstruction}}`  | 角色的历史后指令覆盖                                              |\n| `{{charDepthPrompt}}`  | 角色的@深度笔记                                                |\n| `{{charCreatorNotes}}` | 角色卡的创作者笔记                                               |\n| `{{charVersion}}`      | 角色的版本号                                                  |\n| `{{mesExamples}}`      | 角色的对话示例，格式为指导模式                                         |\n| `{{mesExamplesRaw}}`   | 来自角色卡的未格式化对话示例                                          |\n| `{{charFirstMessage}}` | 角色的第一条消息（问候语）。接受备用问候语的可选索引，例如 `{{charFirstMessage::1}}` |\n| `{{original}}`         | 用于替换角色提示词中的原始消息内容覆盖                                     |\n\n### 聊天记录和消息\n\n| 宏                             | 描述                                                 |\n| ----------------------------- | -------------------------------------------------- |\n| `{{lastMessage}}`             | 聊天中的最后一条消息                                         |\n| `{{lastMessageId}}`           | 聊天中最后一条消息的索引                                       |\n| `{{lastUserMessage}}`         | 聊天中的最后一条用户消息                                       |\n| `{{lastCharMessage}}`         | 聊天中最后一条角色/bot 消息                                   |\n| `{{firstIncludedMessageId}}`  | 当前上下文中包含的第一条消息的索引                                  |\n| `{{firstDisplayedMessageId}}` | 聊天中第一条显示消息的索引                                      |\n| `{{lastSwipeId}}`             | 最后一条消息的最后一个滑动切换回复从 1 开始的索引                         |\n| `{{currentSwipeId}}`          | 当前滑动切换回复的从 1 开始的索引                                 |\n| `{{allChatRange}}`            | 提供整个聊天的范围（例如 `0-{{lastMessageId}}`)，对于接受消息范围的命令很有用 |\n| `{{summary}}`                 | 来自“Summarize”扩展的最新聊天摘要（如果可用）                       |\n\n### 时间和日期\n\n| 宏                            | 描述                                     |\n| ---------------------------- | -------------------------------------- |\n| `{{time}}`                   | 当前当地时间                                 |\n| `{{time::UTC±(offset)}}`     | 具有 UTC 偏移量的时间                          |\n| `{{date}}`                   | 当前本地日期（短格式）                            |\n| `{{weekday}}`                | 本周的当前日期                                |\n| `{{isotime}}`                | HH:mm 格式的当前时间                          |\n| `{{isodate}}`                | 当前日期（YYYY-MM-DD 格式）                    |\n| `{{datetimeformat::format}}` | 自定义格式的日期/时间（例如， `YYYY-MM-DD HH:mm:ss`) |\n| `{{idleDuration}}`           | 自上次用户消息以来人类可读的持续时间                     |\n| `{{timeDiff::left::right}}`  | 两个时间之间人类可读的差异                          |\n\n### 变量\n\n| 宏                               | 描述                           |\n| ------------------------------- | ---------------------------- |\n| `{{getvar::name}}`              | 获取局部变量值                      |\n| `{{setvar::name::value}}`       | 设置局部变量                       |\n| `{{addvar::name::value}}`       | 将值添加到局部变量（数字或字符串追加）          |\n| `{{incvar::name}}`              | 将局部变量加 1 并返回新值               |\n| `{{decvar::name}}`              | 将局部变量减 1 并返回新值               |\n| `{{hasvar::name}}`              | 检查局部变量是否存在（返回“true”或“false”） |\n| `{{deletevar::name}}`           | 删除局部变量                       |\n| `{{getglobalvar::name}}`        | 获取全局变量值                      |\n| `{{setglobalvar::name::value}}` | 设置全局变量                       |\n| `{{addglobalvar::name::value}}` | 向全局变量添加值（数值相加或字符串追加）         |\n| `{{incglobalvar::name}}`        | 将全局变量加 1 并返回新值               |\n| `{{decglobalvar::name}}`        | 将全局变量减 1 并返回新值               |\n| `{{hasglobalvar::name}}`        | 检查全局变量是否存在（返回“true”或“false”） |\n| `{{deleteglobalvar::name}}`     | 删除全局变量                       |\n\n### 随机化\n\n| 宏                     | 描述                                                       |\n| --------------------- | -------------------------------------------------------- |\n| `{{random::a::b::c}}` | 随机选择（每次重新滚动）                                             |\n| `{{pick::a::b::c}}`   | 稳定的随机选择（同一聊天、同一位置的结果保持一致）。可通过以下命令重新选择： `/reroll-pick` 命令 |\n| `{{roll::1d20}}`      | 使用 droll 语法掷骰子                                           |\n\n### 运行时状态\n\n| 宏                        | 描述                                                   |\n| ------------------------ | ---------------------------------------------------- |\n| `{{maxPrompt}}`          | 最大提示词上下文大小（提示词 token = 上下文 token - 响应 token）         |\n| `{{maxContextTokens}}`   | 当前生成设置的最大上下文数量token                                  |\n| `{{maxResponseTokens}}`  | 当前生成设置的最大响应数token                                    |\n| `{{model}}`              | 当前所选 API 的型号名称                                       |\n| `{{isMobile}}`           | 如果在移动环境中运行，则为“true”，否则为“false”                       |\n| `{{lastGenerationType}}` | 最后排队的生成请求的类型（例如，“正常”、“模拟”、“重新生成”、“安静”、“滑动切换回复”、“继续”） |\n| `{{hasExtension::name}}` | 检查扩展是否处于活动状态（返回“true”或“false”）。按扩展名匹配，不区分大小写         |\n\n### 提示词模板\n\n| 宏                                     | 描述                   |\n| ------------------------------------- | -------------------- |\n| `{{systemPrompt}}`                    | 活动系统提示词文本（可以选择被角色覆盖） |\n| `{{defaultSystemPrompt}}`             | 默认系统提示词              |\n| `{{authorsNote}}`                     | 作者注释的内容              |\n| `{{charAuthorsNote}}`                 | 角色作者注释的内容            |\n| `{{defaultAuthorsNote}}`              | 默认作者注释的内容            |\n| `{{instructStoryStringPrefix}}`       | 指示故事字符串前缀            |\n| `{{instructStoryStringSuffix}}`       | 指示故事字符串后缀            |\n| `{{instructUserPrefix}}`              | 指示输入/用户前缀顺序          |\n| `{{instructUserSuffix}}`              | 指示输入/用户后缀顺序          |\n| `{{instructAssistantPrefix}}`         | 指示输出/辅助前缀序列          |\n| `{{instructAssistantSuffix}}`         | 指示输出/辅助后缀顺序          |\n| `{{instructSeparator}}`               | 指示分隔符顺序              |\n| `{{instructSystemPrefix}}`            | 指示系统前缀顺序             |\n| `{{instructSystemSuffix}}`            | 指示系统后缀顺序             |\n| `{{instructFirstAssistantPrefix}}`    | 指示第一助手/输出前缀序列        |\n| `{{instructLastAssistantPrefix}}`     | 指示最后一个助手/输出前缀序列      |\n| `{{instructFirstUserPrefix}}`         | 指示第一个用户/输入前缀序列       |\n| `{{instructLastUserPrefix}}`          | 指示最后一个用户/输入前缀序列      |\n| `{{instructStop}}`                    | 指示停止顺序               |\n| `{{instructUserFiller}}`              | 指导用户对齐填充符            |\n| `{{instructSystemInstructionPrefix}}` | 指令系统指令前缀序列           |\n| `{{chatSeparator}}`                   | 文本补全提示词中示例聊天块之间的分隔符  |\n| `{{chatStart}}`                       | 文本完成中的聊天开始标记提示词      |\n| `{{reasoningPrefix}}`                 | 推理块之前使用的前缀字符串        |\n| `{{reasoningSuffix}}`                 | 推理块后使用的后缀字符串         |\n| `{{reasoningSeparator}}`              | 内容和响应之间的分隔符          |\n| `{{charPrefix}}`                      | 角色的图像生成正向提示词前缀       |\n| `{{charNegativePrefix}}`              | 角色的图像生成负向提示词前缀       |\n\n### 实用性\n\n| 宏                    | 描述                 |\n| -------------------- | ------------------ |\n| `{{newline}}`        | 插入换行符角色            |\n| `{{newline::count}}` | 插入多个换行符            |\n| `{{space}}`          | 插入空格角色             |\n| `{{space::count}}`   | 插入多个空格             |\n| `{{noop}}`           | 不执行任何操作，生成空字符串     |\n| `{{trim}}`           | 删除周围的换行符           |\n| `{{reverse::text}}`  | 反转字符串              |\n| `{{input}}`          | 当前聊天输入字段内容         |\n| `{{banned::word}}`   | 文本补全后端禁言           |\n| `{{outlet::key}}`    | 返回指定出口键对应的世界书出口提示词 |\n",
      "searchText": "宏 实验宏引擎 实验宏引擎支持嵌套、稳定的替换顺序和其他改进。对于新安装，它默认启用。现有的安装可以启用它 用户设置 > 聊天/消息处理 > 实验宏引擎. 宏是动态占位符，在处理文本时会替换为实际值。它们在提示词、角色卡、知识手册、快速回复等中的整个 SillyTavern 中使用。 查找可用的宏 SillyTavern 提供所有可用宏的内置文档： 斜线命令：类型 /? macros 在聊天输入中显示所有已注册宏及其描述的列表。 自动完成：参见 宏自动完成 有关在打字时获取建议的详细信息，请参阅下文。 宏自动完成 宏自动完成功能会在您键入时提供可用宏的建议。它适用于整个 SillyTavern 支持宏的所有文本字段。 类型 {{ 启动宏的自动完成，显示可用的宏及其参数，潜在的 宏标志, 变量简写，等等。 默认情况下出现自动完成的位置： 聊天用户输入框 扩展编辑器（全屏文本编辑，通过文本字段旁边的“扩展”按钮打开） 提示词经理编辑 在其他字段中触发自动完成： 新闻 Ctrl+空格键 在任何支持宏的文本字段中打开自动完成弹出窗口 启用 设置 → 自动完成设置 → 在所有宏字段中显示 让自动完成功能自动出现在所有宏字段中 基本语法 宏包含在双花括号中： {{macroName}} 宏名称是 不区分大小写. {{User}}, {{USER}}, 和 {{user}} 全部解析为同一个宏。 示例： {{user}} // Returns the current user/persona name {{char}} // Returns the current character name {{time}} // Returns the current time {{date}} // Returns the current date 论点 许多宏接受参数来自定义其行为。 空间分隔符 对于具有单个参数的宏，可以使用空格将宏名称与其参数分隔开： {{macroName argument}} 示例： {{getvar myVariable}} {{roll 1d20}} {{reverse Hello World}} 双冒号分隔符 使用 :: 分隔多个参数： {{macroName::arg1::arg2::arg3}} 示例： {{setvar::myVariable::Hello World}} {{random::red::green::blue}} {{roll::2d6+3}} 无论是空间还是 :: 是宏参数的推荐语法。 单冒号分隔符（旧版） 单个 : 也可以引入参数，但此语法被视为遗留语法，不建议用于新内容： {{macroName:argument}} 示例： {{roll:1d20}} 宏定义中的空格 宏名称、分隔符和参数之间的空格将被忽略。这允许更易读的格式： {{ macroName :: arg1 :: arg2 }} {{ setvar :: myVariable :: some value }} {{ if :: condition }} 以上所有内容都相当于它们的紧凑形式，没有额外的空格。 嵌套宏 宏可以嵌套在其他宏中。首先解析内部宏： {{getvar::{{char}}_mood}} 这首先解决 {{char}} （例如，“Alice”），然后解析 {{getvar::Alice_mood}}. 更多示例： {{setvar::greeting::Hello, {{user}}!}} 设置一个变量，其内容包括用户名。 {{if {{getvar::showDetails}}}}Details here{{/if}} 条件本身是一个检索变量值的宏。 作用域宏 任何接受至少一个参数的宏都支持作用域语法。开始标签和结束标签之间的内容成为 最后一个论点 的宏。 作用域语法 可以将最后一个参数放在开始和结束标记之间，而不是内联编写： {{macroName argument}} scoped content here {{/macroName}} 结束标签使用 / 宏名称前的标志： {{/macroName}}. 这相当于写： {{macroName::argument::scoped content here}} 示例 设置具有多行内容的变量： {{ setvar backstory }} This character was born in a small village and grew up to become a renowned scholar. {{ /setvar }} 使用 reverse 具有范围内容： {{ reverse }} Hello World {{ /reverse }} 这将返回“dlroW olleH”。 内容修剪 默认情况下，范围内的内容会自动修剪： 前导和尾随空格被删除 一致的缩进被取消缩进（从所有行中删除第一个非空行的缩进） 这允许干净的格式： {{ if condition }} # Heading Some content here {{ /if }} 生产 # Heading\\nSome content here （没有前导空格）。 要保留所有空白，包括前导/尾随换行符，请使用 # 标志。参见 宏标志 了解详情。 条件宏 的 {{if}} 宏根据值是真还是假有条件地呈现内容。 简单条件 {{ if description }} # Character Description {{ description }} {{ /if }} 仅当出现以下情况时，才会显示标题和说明： description 返回一个非空值。 条件可以是： 宏名称（如果不需要参数，则自动解析） 来自嵌套宏的任何值，例如 {{getvar::flag}} 变量简写如 .myFlag 或 $globalFlag （见 变量简写) 您想要的任何文本（将根据其内容隐式解析为真或假） 虚假值：空字符串， false, 0, off, no. 在条件中使用变量简写 变量简写提供了一种检查条件中变量值的简洁方法： {{ if .isEnabled }} Feature is enabled. {{ /if }} {{ if !$globalDisabled }} Not globally disabled. {{ /if }} 参见 变量简写 有关速记符号的更多详细信息。 倒置条件 条件前缀为 ! 反转它： {{ if !personality }} No personality defined for this character. {{ /if }} If/Else 分支 使用 {{else}} 里面一个 {{if}} 块来定义替代分支： {{ if personality }} {{ personality }} {{ else }} No personality defined. {{ /if }} 另一个例子： {{ if {{getvar::details-block}} }} # Details Block {{ getvar::details-block }} {{ else }} No details currently exist. {{ /if }} 宏标志 标志是放置在左大括号和宏名称之间的特殊符号角色，用于修改宏行为。 语法 {{!macroName}} {{#macroName}} 标志可以组合： {{!?macroName}} 标志和宏名称之间允许有空格： {{ / macroName }} {{ # macroName }} 实施的标志 旗帜 名称 描述 / 封闭块 标记作用域宏的结束标记。示例： {{/if}} # 保留空白 防止自动修剪范围内的内容。 计划中的标志（尚未实施） 旗帜 名称 描述 ! 立即 在同一文本中的其他宏之前解析此宏。 ? 延误 在同一文本中的其他宏之后解析该宏。 ~ 重新评估 标记此宏以进行重新评估。 > 过滤器 为此宏启用基于管道的输出过滤器。 类似标志的前缀运算符 变量速记语法使用前缀运算符 (. 和 $）其行为与标志类似，但本身不是标志。请参阅 变量简写 部分了解详细信息。 保留空白标志 使用 # 当您需要保留作用域内容中的所有空格（包括前导/尾随换行符和缩进）时进行标记： {{ # setvar code }} function hello() { return \"world\"; } {{ /setvar }} 没有 #，内容将被修剪和缩进。与 #，所有空白都完全按照写入方式保留，包括开始标记之后和结束标记之前的换行符。 评论 使用注释宏添加不会出现在输出中的注释： {{// This is a comment and will be removed}} 对于多行注释，请使用作用域语法： {{ // }} This entire block is a comment. It can span multiple lines. {{ /// }} 转义宏 要在没有宏分辨率的情况下显示文字大括号，请使用反斜杠对其进行转义： \\{\\{notAMacro\\}\\} 这输出 {{notAMacro}} 作为纯文本。 变量简写 变量简写为常见变量操作提供了简洁的语法。使用 . 对于局部变量和 $ 对于全局变量。 可变速记前缀 前缀 名称 描述 . 局部变量 局部变量操作的简写。示例： {{.myvar}} $ 全局变量 全局变量操作的简写。示例： {{$myvar}} 必须放置这些前缀运算符 就在之前 变量名称，在任何可选出现之后 宏标志。它们不被视为宏标志，而是更多指示正在插入变量速记，而不是按名称插入宏。前缀运算符不是变量名本身的一部分，而是更改变量访问方式的修饰符。 变量名称 变量名称遵循与宏标识符相同的规则：以字母开头，后跟字母、数字、下划线或连字符。最后一个角色不允许是下划线或连字符。 {{.my-var}} // Valid {{.my_var}} // Valid {{.myVar123}} // Valid 如果您的变量具有不符合标准规则的标识符，则必须使用完整的变量宏语法（例如 {{getvar::my§var----}}），或重命名/移动您的变量值。 值中的嵌套宏 变量值可以包含嵌套宏： {{.greeting = Hello, {{user}}!}} 解析为保存的变量 Hello, User! 里面。 （如果 {{user}} 被命名为“用户”） 空白处理 运算符周围允许有空格： {{ .myvar = spaced value }} {{ .counter ++ }} 变量速记运算符 以下运算符可与变量简写一起使用。每个操作员都遵循模式 {{.varName operator value}} 或 {{$varName operator value}}. 操作员 名称 示例 描述 （无） 获取 {{.myvar}} 返回变量值 = 套装 {{.myvar = value}} 将变量设置为一个值，不返回任何内容 ++ 增量 {{.counter++}} 加 1，返回新值 -- 递减 {{.counter--}} 减 1，返回新值 += 添加 {{.score += 10}} 添加到变量（数字或字符串连接），不返回任何内容 -= 减去 {{.health -= 5}} 从变量中减去（仅限数字），不返回任何内容 ` ` 逻辑或 `{{.名称 来宾}}` 如果变量为假则返回回退 ?? 空值合并 {{.name ?? Guest}} 仅当变量未定义时返回后备 ` =` 逻辑或赋值 `{{.名称 = 客人}}` 如果变量为假则设置值，返回新值 ??= 空合并赋值 {{.name ??= Guest}} 仅当变量未定义时设置值，返回新值 == 等于 {{.status == active}} 比较值，返回 \"true\" 或 \"false\" != 不等于 {{.status != active}} 比较值，返回 \"true\" 如果不等于 > 大于 {{.score > 50}} 退货 \"true\" 如果变量大于值 >= 大于或等于 {{.level >= 10}} 退货 \"true\" 如果变量大于或等于值 < 小于 {{.health < 20}} 退货 \"true\" 如果变量小于值 <= 小于或等于 {{.health <= 0}} 退货 \"true\" 如果变量小于或等于值 获取变量 使用简单的前缀检索变量值： {{.myvar}} // Get local variable \"myvar\" {{$myvar}} // Get global variable \"myvar\" 相当于 {{getvar::myvar}} 和 {{getglobalvar::myvar}}. 设置变量 使用 = 运算符设置变量值： {{ .myvar = Hello World }} // Set local variable {{ $myvar = Some value }} // Set global variable 相当于 {{setvar::myvar::Hello World}} 和 {{setglobalvar::myvar::Hello World}}。返回一个空字符串。 增量 使用 ++ 将数值变量加 1： {{.counter++}} // Increment local variable, returns new value {{$counter++}} // Increment global variable, returns new value 相当于 {{incvar counter}} 和 {{incglobalvar counter}}。返回递增后的新值。 递减 使用 -- 将数值变量减 1： {{.counter--}} // Decrement local variable, returns new value {{$counter--}} // Decrement global variable, returns new value 相当于 {{decvar counter}} 和 {{decglobalvar counter}}。返回递减后的新值。 添加 使用 += 向变量添加数值： {{.score += 10}} // Add 10 to local variable {{$total += 5}} // Add 5 to global variable 相当于 {{addvar::score::10}} 和 {{addglobalvar::total::5}}。返回一个空字符串。 add 运算符还支持将字符串附加到现有字符串变量（如果它们都不是数字）： {{.myvar += {{noop}} | Second block}} // Resolves to \"Content | Second block\" when the variable before was \"Content\". // Use `{{noop}}` to be able to add whitespaces, that otherwise would be trimmed automatically. 减去 使用 -= 从变量中减去数值： {{.health -= 10}} // Subtract 10 from local variable {{$points -= 5}} // Subtract 5 from global variable 相当于 {{addvar::score::10}} 和 {{addglobalvar::total::5}}，但带有负数/倒数。返回一个空字符串。 如果该值不是有效数字，则会记录警告并且变量不会更改。 逻辑或 使用 || 当变量为假时提供后备值（空字符串， 0, false): {{.name || Anonymous}} // Returns \"Anonymous\" if .name is empty or falsy {{$setting || default}} // Returns \"default\" if $setting is falsy 如果为真则返回变量值，否则返回后备值。后备方案是 仅在需要时进行评估 （惰性评估）。 空值合并 使用 ?? 仅当变量不存在时提供后备值： {{.name ?? Guest}} // Returns \"Guest\" only if .name is not defined {{$config ?? default}} // Returns \"default\" only if $config doesn't exist 不像 ||，这会返回变量值，即使它是假的（空字符串， 0, false) — 只要变量存在。后备方案是 仅在需要时进行评估 （惰性评估）。 逻辑或赋值 使用 ||= 仅当变量当前为假值时才将其设置为值： {{.name ||= Anonymous}} // Sets and returns \"Anonymous\" if .name is falsy {{$count ||= 0}} // Sets and returns \"0\" if $count is falsy 如果变量已经为真，则返回当前值而不进行修改。返回最终值（现有值或新设置的值）。 空合并赋值 使用 ??= 仅当变量不存在时才将其设置为值： {{.name ??= Guest}} // Sets and returns \"Guest\" only if .name is undefined {{$config ??= default}} // Sets and returns \"default\" only if $config doesn't exist 不像 ||=，这保留了虚假值（空字符串， 0, false) 如果变量已经存在。返回最终值（现有值或新设置的值）。 等于 使用 == 将变量值与另一个值进行比较： {{.status == active}} // Returns \"true\" if .status equals \"active\", otherwise \"false\" {{$mode == dark}} // Returns \"true\" if $mode equals \"dark\", otherwise \"false\" 执行字符串比较并返回文字字符串 \"true\" 或 \"false\".将不存在的变量、空变量和空变量视为相同。 有用于 {{if}} 条件： {{if {{.status == active}} }}Active mode{{/if}} 不等于 使用 != 将一个变量值与另一个值进行比较以确定是否不相等： {{.status != inactive}} // Returns \"true\" if .status is NOT \"inactive\", otherwise \"false\" {{$mode != light}} // Returns \"true\" if $mode is NOT \"light\", otherwise \"false\" 执行字符串比较并返回 \"true\" 如果值不同， \"false\" 如果它们相等。将不存在的变量、空变量和空变量视为相同。 有用于 {{if}} 条件： {{if {{.status != disabled}} }}Feature enabled{{/if}} 大于 使用 > 检查变量的数值是否大于另一个值： {{.score > 50}} // Returns \"true\" if .score is greater than 50 {{$level > 5}} // Returns \"true\" if $level is greater than 5 执行数字比较并返回文字字符串 \"true\" 或 \"false\". 有用于 {{if}} 条件： {{if {{.score > 100}} }}High score!{{/if}} 大于或等于 使用 >= 检查变量的数值是否大于或等于另一个值： {{.level >= 10}} // Returns \"true\" if .level is at least 10 {{$points >= 100}} // Returns \"true\" if $points is 100 or more 执行数字比较并返回文字字符串 \"true\" 或 \"false\". 有用于 {{if}} 条件： {{if {{$level >= 10}} }}Unlocked advanced features{{/if}} 小于 使用 < 检查变量的数值是否小于另一个值： {{.health < 20}} // Returns \"true\" if .health is below 20 {{$timer < 0}} // Returns \"true\" if $timer is negative 执行数字比较并返回文字字符串 \"true\" 或 \"false\". 有用于 {{if}} 条件： {{if {{.health < 20}} }}Low health warning!{{/if}} 小于或等于 使用 <= 检查变量的数值是否小于或等于另一个值： {{.health <= 0}} // Returns \"true\" if .health is 0 or below {{$attempts <= 3}} // Returns \"true\" if $attempts is 3 or fewer 执行数字比较并返回文字字符串 \"true\" 或 \"false\". 有用于 {{if}} 条件： {{if {{.health <= 0}} }}Game over{{/if}} 遗留语法 为了向后兼容，仍然支持尖括号标记： 遗产 等效宏 <USER> {{user}} <BOT> {{char}} <CHAR> {{char}} <GROUP> {{group}} <CHARIFNOTGROUP> {{charIfNotGroup}} 这些在处理过程中会自动转换为其宏等效项。 注意： 不建议使用旧语法。使用等效的 {{macro}} 语法代替新内容。 常用宏（按类别） 使用 /? macros 有关可用宏的完整列表及其详细说明。 姓名及参与者 宏 描述 {{user}} 当前用户/用户人设名称 {{char}} 当前角色名称 {{group}} 以逗号分隔的群组成员姓名列表（包括静音）或单独聊天中的角色姓名 {{groupNotMuted}} 以逗号分隔的群组成员名称列表，不包括静音成员 {{charIfNotGroup}} 角色名称（组内为空） {{notChar}} 除当前发言者外的所有参与者的逗号分隔列表 角色卡和用户人设字段 宏 描述 {{description}} 角色说明 {{personality}} 角色个性 {{scenario}} 角色场景 {{persona}} 用户用户人设描述 {{charPrompt}} 角色的主提示词覆盖 {{charInstruction}} 角色的历史后指令覆盖 {{charDepthPrompt}} 角色的@深度笔记 {{charCreatorNotes}} 角色卡的创作者笔记 {{charVersion}} 角色的版本号 {{mesExamples}} 角色的对话示例，格式为指导模式 {{mesExamplesRaw}} 来自角色卡的未格式化对话示例 {{charFirstMessage}} 角色的第一条消息（问候语）。接受备用问候语的可选索引，例如 {{charFirstMessage::1}} {{original}} 用于替换角色提示词中的原始消息内容覆盖 聊天记录和消息 宏 描述 {{lastMessage}} 聊天中的最后一条消息 {{lastMessageId}} 聊天中最后一条消息的索引 {{lastUserMessage}} 聊天中的最后一条用户消息 {{lastCharMessage}} 聊天中最后一条角色/bot 消息 {{firstIncludedMessageId}} 当前上下文中包含的第一条消息的索引 {{firstDisplayedMessageId}} 聊天中第一条显示消息的索引 {{lastSwipeId}} 最后一条消息的最后一个滑动切换回复从 1 开始的索引 {{currentSwipeId}} 当前滑动切换回复的从 1 开始的索引 {{allChatRange}} 提供整个聊天的范围（例如 0-{{lastMessageId}} )，对于接受消息范围的命令很有用 {{summary}} 来自“Summarize”扩展的最新聊天摘要（如果可用） 时间和日期 宏 描述 {{time}} 当前当地时间 {{time::UTC±(offset)}} 具有 UTC 偏移量的时间 {{date}} 当前本地日期（短格式） {{weekday}} 本周的当前日期 {{isotime}} HH:mm 格式的当前时间 {{isodate}} 当前日期（YYYY-MM-DD 格式） {{datetimeformat::format}} 自定义格式的日期/时间（例如， YYYY-MM-DD HH:mm:ss ) {{idleDuration}} 自上次用户消息以来人类可读的持续时间 {{timeDiff::left::right}} 两个时间之间人类可读的差异 变量 宏 描述 {{getvar::name}} 获取局部变量值 {{setvar::name::value}} 设置局部变量 {{addvar::name::value}} 将值添加到局部变量（数字或字符串追加） {{incvar::name}} 将局部变量加 1 并返回新值 {{decvar::name}} 将局部变量减 1 并返回新值 {{hasvar::name}} 检查局部变量是否存在（返回“true”或“false”） {{deletevar::name}} 删除局部变量 {{getglobalvar::name}} 获取全局变量值 {{setglobalvar::name::value}} 设置全局变量 {{addglobalvar::name::value}} 向全局变量添加值（数值相加或字符串追加） {{incglobalvar::name}} 将全局变量加 1 并返回新值 {{decglobalvar::name}} 将全局变量减 1 并返回新值 {{hasglobalvar::name}} 检查全局变量是否存在（返回“true”或“false”） {{deleteglobalvar::name}} 删除全局变量 随机化 宏 描述 {{random::a::b::c}} 随机选择（每次重新滚动） {{pick::a::b::c}} 稳定的随机选择（同一聊天、同一位置的结果保持一致）。可通过以下命令重新选择： /reroll-pick 命令 {{roll::1d20}} 使用 droll 语法掷骰子 运行时状态 宏 描述 {{maxPrompt}} 最大提示词上下文大小（提示词 token = 上下文 token - 响应 token） {{maxContextTokens}} 当前生成设置的最大上下文数量token {{maxResponseTokens}} 当前生成设置的最大响应数token {{model}} 当前所选 API 的型号名称 {{isMobile}} 如果在移动环境中运行，则为“true”，否则为“false” {{lastGenerationType}} 最后排队的生成请求的类型（例如，“正常”、“模拟”、“重新生成”、“安静”、“滑动切换回复”、“继续”） {{hasExtension::name}} 检查扩展是否处于活动状态（返回“true”或“false”）。按扩展名匹配，不区分大小写 提示词模板 宏 描述 {{systemPrompt}} 活动系统提示词文本（可以选择被角色覆盖） {{defaultSystemPrompt}} 默认系统提示词 {{authorsNote}} 作者注释的内容 {{charAuthorsNote}} 角色作者注释的内容 {{defaultAuthorsNote}} 默认作者注释的内容 {{instructStoryStringPrefix}} 指示故事字符串前缀 {{instructStoryStringSuffix}} 指示故事字符串后缀 {{instructUserPrefix}} 指示输入/用户前缀顺序 {{instructUserSuffix}} 指示输入/用户后缀顺序 {{instructAssistantPrefix}} 指示输出/辅助前缀序列 {{instructAssistantSuffix}} 指示输出/辅助后缀顺序 {{instructSeparator}} 指示分隔符顺序 {{instructSystemPrefix}} 指示系统前缀顺序 {{instructSystemSuffix}} 指示系统后缀顺序 {{instructFirstAssistantPrefix}} 指示第一助手/输出前缀序列 {{instructLastAssistantPrefix}} 指示最后一个助手/输出前缀序列 {{instructFirstUserPrefix}} 指示第一个用户/输入前缀序列 {{instructLastUserPrefix}} 指示最后一个用户/输入前缀序列 {{instructStop}} 指示停止顺序 {{instructUserFiller}} 指导用户对齐填充符 {{instructSystemInstructionPrefix}} 指令系统指令前缀序列 {{chatSeparator}} 文本补全提示词中示例聊天块之间的分隔符 {{chatStart}} 文本完成中的聊天开始标记提示词 {{reasoningPrefix}} 推理块之前使用的前缀字符串 {{reasoningSuffix}} 推理块后使用的后缀字符串 {{reasoningSeparator}} 内容和响应之间的分隔符 {{charPrefix}} 角色的图像生成正向提示词前缀 {{charNegativePrefix}} 角色的图像生成负向提示词前缀 实用性 宏 描述 {{newline}} 插入换行符角色 {{newline::count}} 插入多个换行符 {{space}} 插入空格角色 {{space::count}} 插入多个空格 {{noop}} 不执行任何操作，生成空字符串 {{trim}} 删除周围的换行符 {{reverse::text}} 反转字符串 {{input}} 当前聊天输入字段内容 {{banned::word}} 文本补全后端禁言 {{outlet::key}} 返回指定出口键对应的世界书出口提示词",
      "translationStatus": "machine-draft"
    },
    {
      "slug": "core-concepts/worldinfo",
      "title": "世界书",
      "group": "Usage",
      "order": 130,
      "source": "Usage/worldinfo.md",
      "sourceUrl": "https://docs.sillytavern.app/usage/core-concepts/worldinfo/",
      "sourceSha256": "edbecf10ae920985d759f996af9f5ea9df720770ce5ebbb1c10ecd06a5396282",
      "headings": [
        {
          "id": "world-info",
          "depth": 1,
          "title": "世界书"
        },
        {
          "id": "pro-tips",
          "depth": 2,
          "title": "专业提示"
        },
        {
          "id": "further-reading",
          "depth": 2,
          "title": "进一步阅读"
        },
        {
          "id": "context-specific-sources",
          "depth": 2,
          "title": "特定上下文的来源"
        },
        {
          "id": "character-lore",
          "depth": 3,
          "title": "角色传说"
        },
        {
          "id": "persona-lorebook",
          "depth": 3,
          "title": "用户人设世界书"
        },
        {
          "id": "chat-lorebook",
          "depth": 3,
          "title": "聊天世界书"
        },
        {
          "id": "lore-insertion-strategy",
          "depth": 3,
          "title": "知识插入策略"
        },
        {
          "id": "sorted-evenly-default",
          "depth": 4,
          "title": "均匀排序（默认）"
        },
        {
          "id": "character-lore-first",
          "depth": 4,
          "title": "角色绝杀第一"
        },
        {
          "id": "global-lore-first",
          "depth": 4,
          "title": "全球传说第一"
        },
        {
          "id": "world-info-entry",
          "depth": 2,
          "title": "世界书条目"
        },
        {
          "id": "key",
          "depth": 3,
          "title": "钥匙"
        },
        {
          "id": "regular-expression-regex-as-keys",
          "depth": 4,
          "title": "正则表达式 (Regex) 作为键"
        },
        {
          "id": "advanced-regex-per-message-matching",
          "depth": 5,
          "title": "高级正则表达式每条消息匹配"
        },
        {
          "id": "key-input",
          "depth": 4,
          "title": "按键输入"
        },
        {
          "id": "optional-filter",
          "depth": 3,
          "title": "可选过滤器"
        },
        {
          "id": "entry-content",
          "depth": 3,
          "title": "参赛内容"
        },
        {
          "id": "insertion-order",
          "depth": 3,
          "title": "广告订单"
        },
        {
          "id": "insertion-position",
          "depth": 3,
          "title": "插入位置"
        },
        {
          "id": "outlet-name",
          "depth": 3,
          "title": "店铺名称"
        },
        {
          "id": "limitations-and-caveats",
          "depth": 4,
          "title": "限制和注意事项"
        },
        {
          "id": "entry-title--memo",
          "depth": 3,
          "title": "参赛作品标题/备注"
        },
        {
          "id": "strategy",
          "depth": 3,
          "title": "策略"
        },
        {
          "id": "probability-trigger-",
          "depth": 3,
          "title": "概率（触发%）"
        },
        {
          "id": "inclusion-group",
          "depth": 3,
          "title": "共融集团"
        },
        {
          "id": "prioritize-inclusion",
          "depth": 3,
          "title": "优先考虑包容性"
        },
        {
          "id": "use-group-scoring",
          "depth": 3,
          "title": "使用小组评分"
        },
        {
          "id": "automation-id",
          "depth": 3,
          "title": "自动化ID"
        },
        {
          "id": "character-filter",
          "depth": 3,
          "title": "角色过滤器"
        },
        {
          "id": "triggers",
          "depth": 3,
          "title": "触发器"
        },
        {
          "id": "additional-matching-sources",
          "depth": 3,
          "title": "其他匹配来源"
        },
        {
          "id": "vector-storage-matching",
          "depth": 2,
          "title": "矢量存储匹配"
        },
        {
          "id": "timed-effects",
          "depth": 2,
          "title": "定时效果"
        },
        {
          "id": "timed-effects-rules",
          "depth": 3,
          "title": "定时效果规则"
        },
        {
          "id": "types-of-timed-effects",
          "depth": 3,
          "title": "定时效果的类型"
        },
        {
          "id": "timed-effects-example",
          "depth": 3,
          "title": "定时效果示例"
        },
        {
          "id": "activation-settings",
          "depth": 2,
          "title": "激活设置"
        },
        {
          "id": "scan-depth",
          "depth": 3,
          "title": "扫描深度"
        },
        {
          "id": "include-names",
          "depth": 3,
          "title": "包括姓名"
        },
        {
          "id": "context---budget",
          "depth": 3,
          "title": "背景 % / 预算"
        },
        {
          "id": "min-activations",
          "depth": 3,
          "title": "最少激活次数"
        },
        {
          "id": "max-depth",
          "depth": 3,
          "title": "最大深度"
        },
        {
          "id": "recursive-scanning",
          "depth": 3,
          "title": "递归扫描"
        },
        {
          "id": "max-recursion-steps",
          "depth": 3,
          "title": "最大递归步数"
        },
        {
          "id": "case-sensitive-keys",
          "depth": 3,
          "title": "区分大小写的按键"
        },
        {
          "id": "match-whole-words",
          "depth": 3,
          "title": "匹配整个单词"
        },
        {
          "id": "alert-on-overflow",
          "depth": 3,
          "title": "溢出警报"
        }
      ],
      "content": "# 世界书\n\n**世界书（也称为 Lorebooks 或 Memory Books）是 ST 中提供的强大工具，可将提示词动态插入您的聊天中，以帮助指导 AI 回复。**\n\n通常，世界书（简称WI）用于增强AI对虚构世界中细节的理解，但是您可以使用世界书条目插入您想要插入到提示词中的任何内容。\n\n它的功能类似于动态字典，仅当消息文本中存在与条目关联的关键字时，才从世界书条目插入相关信息。\n\nSillyTavern 引擎激活适当的知识并将其无缝集成到提示词中，为 AI 提供背景信息。\n\n*值得注意的是，虽然世界书有助于引导 AI 找到所需的内容，但它不能保证其出现在生成的输出消息中。这取决于您的模型在利用附加信息方面的能力！*\n\n## 专业提示\n\n- 世界书引擎是一个非常强大的提示词管理工具。不要只专注于添加角色传说，请随意尝试。\n- 激活关键字、标题和其他不在其中的信息 **内容** 字段不会插入到上下文中，因此每个世界书条目都应该有一个全面的、独立的描述。\n- 为了创建丰富而详细的世界传说，条目可以通过使用递归激活相互链接和引用。查看更多内容 [递归](#recursive-scanning) 下面。\n- SillyTavern 为插入的背景信息提供灵活的上下文预算。为了节省提示词 token，建议保持条目内容简洁。\n\n## 进一步阅读\n\n- [世界书百科](https://rentry.co/world-info-encyclopedia)：世界书和 Lorebooks 的详尽深入指南。作者：kingbri、Alicat、Trappu。\n\n## 特定上下文的来源\n\n除了全局世界书选择器之外，知识手册还可以分配给特定的上下文 - 角色、用户人设或个人聊天。当相关的角色、用户人设或聊天处于活动状态时，这些特定于上下文的源会自动激活。\n\n### 角色传说\n\n或者，可以将世界书文件分配给角色，以充当与该角色（包括群组）的所有聊天中的专用知识源。\n\n一个角色可以绑定一本主要世界书。打开角色管理面板，点击地球按钮，从下拉列表中选择世界书，再点击“确定（Ok）”。导出角色时，这份文件也会嵌入到角色卡数据中。\n\n要取消绑定、更改或分配其他世界书文件作为角色 lore，请按住 Shift 键并单击地球按钮或单击“更多...”，然后单击“链接世界书”。请注意，只有主世界书文件会随角色一起导出。\n\n重命名世界书文件时，系统会询问是否为所有引用它的角色重新关联该世界书。这样可以在重命名后保留现有的角色世界书绑定关系。\n\n### 用户人设世界书\n\n可以将世界书文件分配给当前活动的 [用户人设](/guides/sillytavern/core-concepts/personas/)。只要选择用户人设，无论打开哪个角色或聊天，都会激活此世界书中的条目。\n\n要将世界书分配给用户人设，请打开 **用户人设管理** 面板并单击 <i class=\"fa-solid fa-globe\"></i> **用户人设传说** 按钮。从下拉列表中选择一个世界书文件。如果已经绑定了世界书，则单击按钮直接打开世界书编辑器。\n\n> 要在世界书已绑定时重新打开分配弹出窗口，请使用 **长按** （在移动设备上）或 **Shift+单击 / Alt+单击** （在桌面上）用户人设 Lore 按钮上。\n\n### 聊天世界书\n\n世界书文件也可以分配给个人聊天。来自聊天绑定世界书的条目仅在该特定对话中有效，不会转移到具有相同角色的其他聊天中。\n\n要将世界书分配给聊天，请单击 <i class=\"fa-solid fa-passport\"></i> **聊天传说** 角色管理面板中的按钮。从下拉列表中选择世界书文件。如果已经绑定了世界书，则单击按钮直接打开世界书编辑器。\n\n> 要在世界书已绑定时重新打开分配弹出窗口，请使用 **长按** （在移动设备上）或 **Shift+单击 / Alt+单击** （在桌面上）“聊天传说”按钮上。\n\n### 知识插入策略\n\n生成 AI 回复时，来自角色、世界书和其他辅助源的条目将与来自全局世界书选择器的条目合并。默认情况下，条目将按以下顺序插入：\n\n- [聊天传说](#chat-lorebook)\n- [用户人设传说](#persona-lorebook)\n- 使用以下策略之一的角色传说或全球传说：\n\n#### 均匀排序（默认）\n\n所有条目将根据其插入顺序进行排序，就好像它们是一个大文件的一部分一样，忽略源。\n\n#### 角色绝杀第一\n\n来自角色世界书的条目将首先包含在其插入订单中，然后包含来自全局世界书的条目。\n\n#### 全球传说第一\n\n来自全局世界书的条目将首先包含在其插入订单中，然后包含来自角色世界书的条目。\n\n## 世界书条目\n\n### 钥匙\n\n触发世界书条目激活的关键字列表。默认情况下，按键不区分大小写（这是 [可配置](#case-sensitive-keys)).\n\n#### 正则表达式 (Regex) 作为键\n\n键通过支持正则表达式提供更灵活的匹配方法。这使得可以将更多动态内容与可选单词或角色、间距以及正则表达式提供的所有其他实用程序相匹配。\\\n如果定义的键是有效的正则表达式（Javascript 正则表达式样式，带有 `/` 作为分隔符。所有标志都是允许的），在检查是否应该触发条目时将如此对待。多个正则表达式可以作为单独的键输入，并且可以彼此协同工作。在正则表达式中，可以使用逗号。明文键不支持逗号，因为它们被视为键分隔符。\n\n高级正则表达式匹配的用例示例：\\\n当 char 正在执行与天气相关的操作时应插入的条目/指令\n\n```js\n/(?:{{char}}|he|she) (?:is talking about|is noticing|is checking whether|observes) (?:the )?(rainy weather|heavy wind|it is going to rain|cloudy sky)/i\n```\n\n关于正则表达式语法与用途的更多信息： [正则表达式- JavaScript | MDN](https://developer.mozilla.org/en-US/docs/Web/JavaScript/Guide/Regular_expressions)\n\n##### 高级正则表达式每条消息匹配\n\nST 在 WI 扫描缓冲区中为每条聊天消息添加前缀 `character name:` 在 v1.12.6 之后，使用角色值 1 将它们添加到前面（`\\x01`).\\\n这意味着您可以使用与该分隔角色相关的正则表达式来匹配来自某个角色的特定输入或输出。\n\n例如，要仅匹配说“hello”的用户，您可以使用以下正则表达式：\n\n```js\n/\\x01{{user}}:[^\\x01]*?hello/\n```\n\n#### 按键输入\n\n有两种输入关键字的模式，每种模式的用户界面略有不同。在⌨️ *明文模式* （默认），可以在单个文本字段中以逗号分隔的列表形式输入密钥。也可以包含正则表达式，但它们没有任何特殊的突出显示。在✨ *奇特模式*，键显示为单独的元素，并且正则表达式将如此突出显示。该控件支持编辑和删除按键。可以通过输入控件内的内联按钮切换模式。\n\n### 可选过滤器\n\n与主键结合的附加关键字的逗号分隔列表。\n如果未提供参数，则忽略此标志。\n支持 AND ANY、NOT ANY 或 NOT ALL 逻辑\n\n1. AND ANY = 仅当主键和任何一个可选过滤器键位于扫描上下文中时才激活条目。\n2. AND ALL = 仅当主键和所有可选过滤器键都存在时才激活条目。\n3. NOT ANY = 仅当主键和可选过滤器键均不在扫描上下文中时才激活条目。\n4. NOT ALL = 如果所有可选过滤器都在扫描上下文中，则尽管有主键触发，仍会阻止激活条目。\n\n这些键还支持 [正则表达式](#regular-expression-regex-as-keys).\n\n### 参赛内容\n\n输入激活后插入提示词的文本。\n\n### 广告订单\n\n数值。如果同时激活多个条目，则定义条目的优先级。具有较大订单号的条目将被插入到靠近上下文末尾的位置，因为它们将对输出产生更大的影响。例如，订单号为 100 的条目将出现在上下文中订单号为 250 的条目之前。\n\n### 插入位置\n\n- **在字符定义之前：** 世界书条目插入在角色的描述和场景之前。对谈话有中等影响。\n- **字符定义后：** 世界书条目插入在角色的描述和场景之后。对谈话的影响较大。\n- **示例消息之前：** 世界书条目被解析为示例对话块并插入到角色卡提供的示例之前。\n- **示例消息之后：** 世界书条目被解析为示例对话块并插入到角色卡提供的示例之后。\n- **AN 顶部：** 世界书条目插入到作者注释内容的顶部。根据作者注释位置的不同，影响也不同。\n- **AN 底部：** 世界书条目插入到作者注释内容的底部。根据作者注释位置的不同，影响也不同。\n- **@D：** 世界书条目插入到聊天中的特定深度（深度 0 是提示词的底部）。\n  - ⚙️ - 作为系统角色消息\n  - 👤 - 作为用户角色消息\n  - 🤖 - 作为助理角色消息\n- **出口：** 世界书条目不会自动注入。相反，它的内容存储在一个命名的插座下，因此您可以通过使用以下命令调用它来准确决定它在提示词中出现的位置： [`{{outlet::Name}}` 宏](#outlet-name).\n\n示例消息条目将根据提示词构建设置进行格式化：指令模式或聊天补全提示词管理器。它们还遵循示例消息行为规则：在完整上下文中逐渐推出、始终保留或完全禁用。\n\n如果您的作者注释被禁用（插入频率 = 0），则 A/N 位置中的世界书条目将被忽略！\n\n### 店铺名称\n\n当 **出口** 选择插入位置后，附加 **店铺名称** 字段可供输入。您在此处提供的名称将条目分组在一起，并定义 token，您将使用该名称将它们手动拉入提示词。\n\n使用 `{{outlet::YourName}}` 宏中的 [提示词管理器](/guides/sillytavern/prompts/prompt-manager/) 或 [高级格式设置](/guides/sillytavern/core-concepts/advancedformatting/) 提示词字段。构建提示词时，宏将替换为共享相同插座名称的每个世界书条目的组合内容，以换行符分隔，按其排序 [广告订单](#insertion-order) 值。\n\n如果出口条目缺少名称，它将在生成过程中被跳过，因此请务必填写该字段。插座名称支持根据您已使用的名称自动完成，以便轻松重复使用一致的标签。\n\n#### 限制和注意事项\n\n- 不支持将插座宏放置在世界书条目内，并且不会起作用。这与世界书的求值顺序冲突，可能导致无限循环。\n- 不支持嵌套插座。您不能将插座宏放置在另一个插座的内容中。与上面相同，这可能会导致无限循环。\n- 角色卡字段（描述、个性、场景等）无法扩展网点。这些字段会被尽早解析，因此它们可以充当 [额外的匹配源](#additional-matching-sources) 对于世界书触发器，这意味着处理文本时插座不可用。如果您需要将插座内容放置在提示词主体中，请使用另一个宏感知字段。\n- 作者注释编辑器也无法解析插座。要将插座内容放置在作者注释周围，请将条目分配给 **AN 顶部** 或 **AN 底部** 插入位置而不是依赖宏。\n- 插座名称区分大小写。的 `{{outlet::}}` 宏必须使用与条目完全相同的大小写 **店铺名称**，否则不返回任何内容。\n- 当您调用宏时，插座名称中的前导或尾随空格将被忽略，因此使用额外空格保存的名称将不匹配。避免填充名称，以便正确解析它们。\n- 没有分配内容的插座宏将被替换为空字符串。\n\n### 参赛作品标题/备注\n\n一个文本字段，方便您标记您的条目，AI 或任何触发逻辑都不会使用该文本字段。\n\n如果为空，可以通过单击“填充空备忘录”按钮，使用条目的第一个键进行回填。\n\n### 策略\n\n1. 🔵（蓝色圆圈）=该条目不需要任何关键字，无论内容如何都会触发。\n2. 🟢（绿色圆圈）= 仅当存在关键字时才会触发输入。\n3. 🔗（链链接）=允许通过嵌入相似性来插入条目。\n\n每个条目还有一个切换开关，允许您启用或禁用该条目。\n\n### 概率（触发%）\n\n该值的作用就像一个附加过滤器，当通过任何方式（常量、主键、递归）激活条目时，该过滤器增加了条目不被插入的机会。\n\n1. 概率 = 100 表示该条目将在每次激活时插入。\n2. 概率 = 50 表示该条目将以 1:1 的机会插入。\n3. 概率 = 0 意味着该条目不会被插入（本质上是禁用它）。\n\n使用它可以在聊天中创建随机事件。例如，如果消息中提到了古神的名字，则每条消息都有 1% 的机会唤醒古神的名字。\n\n### 共融集团\n\n包含组控制同时触发具有相同组标签的多个条目时如何选择条目。如果激活了具有相同组标签的多个条目，则只有一个条目将被插入到提示词中。\n\n默认情况下，所选条目是根据其组权重（默认为 100 分）随机选择的 - 数字越大，选择的概率越高。这允许在触发的条目中进行随机选择，为交互添加惊喜和多样性的元素。\n\n如果将多个包含组定义为以逗号分隔的列表，则单个条目可以是多个包含组的一部分。将适用与上面解释的相同的逻辑。如果该条目被触发，它将 *禁用* 属于其任何组的所有其他条目。因此，如果任何组被激活，则该条目将不会被激活。\n\n### 优先考虑包容性\n\n为了更好地控制哪些条目被激活 [共融集团](/guides/sillytavern/core-concepts/worldinfo/#inclusion-group)，您可以使用“优先包含”设置。此选项允许您确定性地指定选择哪个条目，而不是随机滚动组权重机会。\n\n如果激活了具有相同组标签且打开此设置的多个条目，则将选择“顺序”值最高的条目。这对于通过包含组创建后备序列非常有用。例如，更加重视低深度条目的优先级，或者如果两者都有效，则选择关于设置场景的特定指令而不是另一个指令。\n\n### 使用小组评分\n\n当全局或每个条目启用此设置时，激活的条目键的数量决定了组获胜者的选择。只有关键匹配数量最多的组子集才会被组权重或包含优先级激活 - 其余的将被停用并从组中删除。\n\n使用它可以为大组中的单个条目提供更多特异性。例如，它们可以具有公共密钥和特定密钥。当未提供特定密钥时，将插入随机条目，反之亦然。\n\n主键的得分计算逻辑是1个匹配=1分。\n\n对于辅助键，交互取决于所选的选择性逻辑：\n\n1. 和任意：1 次次要比赛 = 1 分。\n2. AND ALL：如果所有辅助键都匹配，则每个辅助键得 1 分。\n3. 不是任何也不是全部：没有变化。\n\n示例：\n\n- 条目 1. 调：歌曲、歌唱、黑猫。组： 歌曲\n- 条目 2. 调：歌曲、歌唱、鬼魂。组： 歌曲\n\n输入 `sing me a song` 可以激活任一条目（均激活 2 个键），但是 `sing me a song about Ghosts` 将仅激活条目 2（激活 3 个键）。\n\n### 自动化ID\n\n允许将世界书条目与 [ST脚本](https://docs.sillytavern.app/usage/st-script/) 来自快速回复扩展。如果快速回复命令和WI条目具有相同的Automation ID，则当激活具有匹配ID的条目时，将自动执行该命令。\n\n自动化按照触发的顺序执行，遵循您指定的排序策略，结合 [角色知识插入策略](#lore-insertion-strategy) 通过“优先级”排序。这导致 [蓝色圆圈](#strategy) 首先处理条目，然后按照指定的“顺序”处理其他条目。递归触发的条目将按照相同的顺序进行处理。\n\n如果激活具有相同自动化 ID 的多个条目，则脚本命令将仅运行一次。\n\n### 角色过滤器\n\n可以激活此条目的角色名称列表。如果此列表不为空，则仅对名称在列表中的角色激活该条目。选择标签后，只有具有该特定标签的角色才会激活该条目。\n\n“排除”模式反转过滤器，这意味着将为所有角色激活条目，但添加到列表中或具有选定标签的条目除外。\n\n### 触发器\n\n可以激活此世界书条目的生成类型。如果未选择任何内容，则可为所有生成类型激活该条目。如果选择一项或多项，则仅针对这些特定生成类型激活该条目：\n\n- **正常：** 定期消息生成请求。\n- **继续：** 当按下继续按钮时。\n- **冒充：** 当按下模拟按钮时。\n- **滑动：** 当通过滑动触发生成时。\n- **再生：** 在单人聊天中按下“重新生成”按钮时。\n- **安静：** 后台生成请求，通常由 [扩展](https://docs.sillytavern.app/extensions/) 或 [ST脚本](https://docs.sillytavern.app/usage/st-script/) 命令。\n\n> “重新生成”触发器在群聊中不可用，因为它使用不同的重新生成逻辑：最后回复的所有消息都将被删除，并且根据所选的“正常”生成类型对消息进行排队 [群组回复策略](/guides/sillytavern/core-concepts/groupchats/#reply-order-strategies).\n\n### 其他匹配来源\n\n默认情况下，世界书条目仅与当前对话中的内容进行匹配。这些选项允许您将条目与聊天中未显示的不同角色信息甚至用户人设信息进行匹配。当您想要在多个角色之间使用多种条目，但又不想管理大型标签列表，或者不想每次创建新过滤器列表时都更新角色过滤器列表时，这非常有用。这还允许您根据您拥有的活动用户人设来匹配条目。\n\n- **角色说明**：与角色描述匹配。\n- **角色个性**：与角色个性摘要匹配，可在高级定义下找到。\n- **场景**：与角色指定场景匹配，可在高级定义下找到。\n- **用户人设说明**：与当前选定的用户人设的描述匹配。\n- **角色的备注**：与角色的注释匹配，可以在“高级定义”下找到该注释。\n- **创作者笔记**：与角色创建者的注释匹配，可以在“高级定义”下找到该注释。 提示词中通常不包含创建者的注释。\n\n## 矢量存储匹配\n\n矢量存储扩展通过利用最近的聊天消息和世界书条目内容之间的相似性，提供了关键字匹配的替代方法。\n\n要启用和使用此功能，需要满足以下先决条件：\n\n1. 矢量存储扩展已启用并配置为使用可用的嵌入源之一。\n2. 在矢量存储扩展设置中勾选了“启用世界书”复选框。\n3. 允许无密钥匹配的世界书条目具有“矢量化”(🔗) 状态，或者在矢量存储设置中选中“对所有条目启用”选项。\n\n扩展中矢量化模型的选择以及术语“嵌入”背后的理论含义将不在这里讨论。查看 [资料库](/guides/sillytavern/core-concepts/data-bank/#vector-storage) 如果您需要有关此主题的更多信息，请指导。\n\n矢量存储匹配遵循这组规则：\n\n- 允许与矢量存储匹配的最大条目数可以通过“最大条目”设置进行调整。该数字仅设置限制，不会影响世界书激活设置中设置的 token 预算。所有预算规则仍然适用。\n- 此功能仅取代关键字检查。要插入的条目必须满足所有附加检查：trigger%、角色过滤器、包含组等。\n- 不使用激活设置或条目覆盖中的“扫描深度”设置。相反，使用矢量存储“查询消息”值来获取要匹配的文本。这允许将“扫描深度”等配置设置为 0，因此不会进行常规关键字匹配，但条目仍然可以由向量激活。\n- “矢量化”状态只是一个附加标记。该条目的行为仍然类似于正常的、启用的、非常量的记录，如果设置了关键字，则该记录将被关键字激活。如果您希望它们仅由向量激活，请删除关键字。\n\n> **注意事项**\n>\n> 由于检索质量完全取决于嵌入模型的输出，因此不可能准确预测将插入哪些条目。如果您想要确定性和可预测的结果，请坚持关键字匹配。\n\n## 定时效果\n\n通常，世界书评估是无状态的，这意味着评估的结果是相同的，仅取决于当前的聊天上下文。但是，随着定时效果的引入，您可以创建具有激活延迟​​、触发后保持活动状态或激活后无法触发的条目。\n\n### 定时效果规则\n\n1. 影响的时间范围以消息（而不是成对的消息/交换）来衡量，0 表示没有影响。\n2. 效果仅适用于激活该条目的聊天。分支继承父聊天的状态。\n3. 如果聊天没有进展，则活动的定时效果将被删除，例如如果最后一条消息被刷或删除。\n4. 对当前处于定时效果的条目进行任何更改都会导致该效果被强制删除。\n5. 如果关键字已经处于活动状态，则后续触发关键字不会刷新效果持续时间。\n\n### 定时效果的类型\n\n1. 粘性 - 该条目在激活后将保持活动状态 N 条消息。粘性条目会忽略后续扫描的概率检查，直到它们过期。\n2. 冷却-该条目激活后N条消息无法激活。可以与粘滞一起使用：当粘滞持续时间结束时，条目会进入冷却状态。\n3. 延迟 - 除非评估时聊天中至少有 N 条消息，否则条目无法激活。\n   - 延迟 = 0 -> 该条目可以随时激活。\n   - Delay = 1 -> 如果聊天为空（无问候语），则无法激活该条目。\n   - Delay = 2 -> 如果聊天中只有零条消息或只有一条消息等，则无法激活该条目。\n\n### 定时效果示例\n\n进入配置：粘滞= 3，冷却时间= 2，延迟= 2。\n\n```txt\nMessage 0: delay\nMessage 1: entry activated\nMessage 2: sticky\nMessage 3: sticky\nMessage 4: sticky\nMessage 5: cooldown\nMessage 6: cooldown\nMessage 7: entry can be activated again\n```\n\n## 激活设置\n\n世界书屏幕顶部的可折叠菜单。\n\n### 扫描深度\n\n> 可以在入门级别覆盖。\n\n定义应扫描聊天历史记录中的多少条消息来查找世界书密钥。\n\n- 如果设置为 0，则仅评估递归条目和作者注释。\n- 如果设置为 1，则 SillyTavern 仅扫描最后一条消息。\n- 2 = 最后两条消息等。\n\n### 包括姓名\n\n定义聊天参与者的姓名是否应作为消息前缀包含在扫描的文本缓冲区中。这允许激活使用名称作为关键字的条目，而无需在消息中直接提及名称。\n\n请参阅下面要扫描的文本示例，假设聊天参与者名为 Alice 和 Bob。\n\n启用（默认）：\n\n```txt\nAlice: Hello! Good to see you.\nBob: How is the weather today?\n```\n\n禁用：\n\n```txt\nHello! Good to see you.\nHow is the weather today?\n```\n\n### 背景 % / 预算\n\n**定义世界书条目一次可以使用多少个 token。**\n您可以定义相对于 API 的最大上下文设置（上下文百分比）的阈值或目标 token 阈值（预算）\n\n如果预算用尽，则即使提示词中存在密钥，也不会激活更多条目。\n\n将首先插入常量条目。然后是订单号较大的条目。\n\n通过直接提及其键插入的条目比其他条目内容中提及的条目具有更高的优先级。\n\n### 最少激活次数\n\n**此设置与最大递归步骤互斥。**\n\n最小激活数：如果设置为非零值，则将忽略“扫描深度”的限制，从最新消息向后查找所有聊天日志中的关键字，直到触发了最小激活数中指定的条目。这仍然会受到最大深度设置或总体预算上限的限制。\n\n*由最小激活触发的额外扫描不会检查先前步骤中递归添加的条目。只有聊天消息和分机提示词可以触发这些额外的激活。然而，由“最小激活”激活的条目可以照常触发其他条目。*\n\n### 最大深度\n\n使用“最小激活”设置时要扫描的最大深度。\n\n### 递归扫描\n\n递归扫描允许条目激活其他条目或被其他条目激活，从而实现不同世界书条目之间的复杂交互和依赖关系。此功能可以显着增强创意场景的动态特性。\\\n是否启用递归扫描可以通过全局设置来控制 **递归扫描**.\\\n可以使用三个选项来控制每个条目的递归：\n\n8 **不可递归**：选中此复选框后，该条目将不会被其他条目激活。这对于不应更改或受其他世界书条目影响的静态信息很有用。\n\n- **防止进一步递归**：选择此选项可确保一旦激活此条目，就不会触发任何其他条目。这有助于避免意外的激活链。\n\n- **延迟直到递归**：此条目仅在递归检查期间被激活，这意味着它不会在初始阶段被触发，但可以被其他启用了递归的条目激活。现在，随着添加 **递归级别** 对于这些延迟，条目按级别分组。最初，只有第一级（最小的数字）会匹配。一旦找不到匹配项，下一个级别就有资格进行匹配，重复该过程直到检查完所有级别。这样可以更好地控制在递归过程中如何以及何时显示更深层次的信息，特别是与“不是任何”或“不是全部”键匹配组合等标准结合使用。\n\n**条目可以通过在内容文本中提及其他条目的关键字来激活其他条目。**\n\n例如，如果您的世界书包含两个条目：\n\n```txt\nEntry #1\nKeyword: Bessie\nContent: Bessie is a cow and is friends with Rufus.\n```\n\n```txt\nEntry #2\nKeyword: Rufus\nContent: Rufus is a dog.\n```\n\n**两者都** 如果消息文本提到，其中的一些将被拉入上下文 **只是贝西**.\n\n### 最大递归步数\n\n**此设置与最小激活数互斥。**\n\n当设置为零时，递归嵌套仅受提示词预算的限制。当设置为非零值时，将扫描总数限制为所需的最大“嵌套级别”。\n\n示例值：\n\n- 1 有效地禁用递归，因为检查在第一步后停止。\n- 2 只能激活递归条目一次。\n- 3 可以触发递归两次...\n\n### 区分大小写的按键\n\n> 可以在入门级别覆盖。\n\n**要进入上下文，输入键需要与世界书条目中定义的大小写匹配。**\n\n当您的关键字是常用单词或常用单词的一部分时，这非常有用。\n\n例如，当此设置处于活动状态时，按键“rose”和“Rose”将根据输入进行不同的处理。\n\n### 匹配整个单词\n\n> 可以在入门级别覆盖。\n\n仅当搜索文本中存在整个单词时，才会匹配键仅包含一个单词的条目。默认启用。\n\n例如，启用该设置且条目关键词为“king”时，“long live the king”会匹配，而“it's not to my liking”不会匹配。\n\n**重要：** 当与不使用空格分隔单词的语言（例如日语或中文）一起使用时，此设置可能会产生不利影响。如果您用这些语言撰写条目，建议不要使用。\n\n### 溢出警报\n\n如果激活的世界书超出分配的 token 预算，则显示警报。\n",
      "searchText": "世界书 世界书（也称为 Lorebooks 或 Memory Books）是 ST 中提供的强大工具，可将提示词动态插入您的聊天中，以帮助指导 AI 回复。 通常，世界书（简称WI）用于增强AI对虚构世界中细节的理解，但是您可以使用世界书条目插入您想要插入到提示词中的任何内容。 它的功能类似于动态字典，仅当消息文本中存在与条目关联的关键字时，才从世界书条目插入相关信息。 SillyTavern 引擎激活适当的知识并将其无缝集成到提示词中，为 AI 提供背景信息。 值得注意的是，虽然世界书有助于引导 AI 找到所需的内容，但它不能保证其出现在生成的输出消息中。这取决于您的模型在利用附加信息方面的能力！ 专业提示 世界书引擎是一个非常强大的提示词管理工具。不要只专注于添加角色传说，请随意尝试。 激活关键字、标题和其他不在其中的信息 内容 字段不会插入到上下文中，因此每个世界书条目都应该有一个全面的、独立的描述。 为了创建丰富而详细的世界传说，条目可以通过使用递归激活相互链接和引用。查看更多内容 递归 下面。 SillyTavern 为插入的背景信息提供灵活的上下文预算。为了节省提示词 token，建议保持条目内容简洁。 进一步阅读 世界书百科：世界书和 Lorebooks 的详尽深入指南。作者：kingbri、Alicat、Trappu。 特定上下文的来源 除了全局世界书选择器之外，知识手册还可以分配给特定的上下文 - 角色、用户人设或个人聊天。当相关的角色、用户人设或聊天处于活动状态时，这些特定于上下文的源会自动激活。 角色传说 或者，可以将世界书文件分配给角色，以充当与该角色（包括群组）的所有聊天中的专用知识源。 一个角色可以绑定一本主要世界书。打开角色管理面板，点击地球按钮，从下拉列表中选择世界书，再点击“确定（Ok）”。导出角色时，这份文件也会嵌入到角色卡数据中。 要取消绑定、更改或分配其他世界书文件作为角色 lore，请按住 Shift 键并单击地球按钮或单击“更多...”，然后单击“链接世界书”。请注意，只有主世界书文件会随角色一起导出。 重命名世界书文件时，系统会询问是否为所有引用它的角色重新关联该世界书。这样可以在重命名后保留现有的角色世界书绑定关系。 用户人设世界书 可以将世界书文件分配给当前活动的 用户人设。只要选择用户人设，无论打开哪个角色或聊天，都会激活此世界书中的条目。 要将世界书分配给用户人设，请打开 用户人设管理 面板并单击 用户人设传说 按钮。从下拉列表中选择一个世界书文件。如果已经绑定了世界书，则单击按钮直接打开世界书编辑器。 要在世界书已绑定时重新打开分配弹出窗口，请使用 长按 （在移动设备上）或 Shift+单击 / Alt+单击 （在桌面上）用户人设 Lore 按钮上。 聊天世界书 世界书文件也可以分配给个人聊天。来自聊天绑定世界书的条目仅在该特定对话中有效，不会转移到具有相同角色的其他聊天中。 要将世界书分配给聊天，请单击 聊天传说 角色管理面板中的按钮。从下拉列表中选择世界书文件。如果已经绑定了世界书，则单击按钮直接打开世界书编辑器。 要在世界书已绑定时重新打开分配弹出窗口，请使用 长按 （在移动设备上）或 Shift+单击 / Alt+单击 （在桌面上）“聊天传说”按钮上。 知识插入策略 生成 AI 回复时，来自角色、世界书和其他辅助源的条目将与来自全局世界书选择器的条目合并。默认情况下，条目将按以下顺序插入： 聊天传说 用户人设传说 使用以下策略之一的角色传说或全球传说： 均匀排序（默认） 所有条目将根据其插入顺序进行排序，就好像它们是一个大文件的一部分一样，忽略源。 角色绝杀第一 来自角色世界书的条目将首先包含在其插入订单中，然后包含来自全局世界书的条目。 全球传说第一 来自全局世界书的条目将首先包含在其插入订单中，然后包含来自角色世界书的条目。 世界书条目 钥匙 触发世界书条目激活的关键字列表。默认情况下，按键不区分大小写（这是 可配置). 正则表达式 (Regex) 作为键 键通过支持正则表达式提供更灵活的匹配方法。这使得可以将更多动态内容与可选单词或角色、间距以及正则表达式提供的所有其他实用程序相匹配。如果定义的键是有效的正则表达式（Javascript 正则表达式样式，带有 / 作为分隔符。所有标志都是允许的），在检查是否应该触发条目时将如此对待。多个正则表达式可以作为单独的键输入，并且可以彼此协同工作。在正则表达式中，可以使用逗号。明文键不支持逗号，因为它们被视为键分隔符。 高级正则表达式匹配的用例示例：当 char 正在执行与天气相关的操作时应插入的条目/指令 /(?:{{char}}|he|she) (?:is talking about|is noticing|is checking whether|observes) (?:the )?(rainy weather|heavy wind|it is going to rain|cloudy sky)/i 关于正则表达式语法与用途的更多信息： 正则表达式- JavaScript | MDN 高级正则表达式每条消息匹配 ST 在 WI 扫描缓冲区中为每条聊天消息添加前缀 character name: 在 v1.12.6 之后，使用角色值 1 将它们添加到前面（\\x01).这意味着您可以使用与该分隔角色相关的正则表达式来匹配来自某个角色的特定输入或输出。 例如，要仅匹配说“hello”的用户，您可以使用以下正则表达式： /\\x01{{user}}:[^\\x01]*?hello/ 按键输入 有两种输入关键字的模式，每种模式的用户界面略有不同。在⌨️ 明文模式 （默认），可以在单个文本字段中以逗号分隔的列表形式输入密钥。也可以包含正则表达式，但它们没有任何特殊的突出显示。在✨ 奇特模式，键显示为单独的元素，并且正则表达式将如此突出显示。该控件支持编辑和删除按键。可以通过输入控件内的内联按钮切换模式。 可选过滤器 与主键结合的附加关键字的逗号分隔列表。 如果未提供参数，则忽略此标志。 支持 AND ANY、NOT ANY 或 NOT ALL 逻辑 AND ANY = 仅当主键和任何一个可选过滤器键位于扫描上下文中时才激活条目。 AND ALL = 仅当主键和所有可选过滤器键都存在时才激活条目。 NOT ANY = 仅当主键和可选过滤器键均不在扫描上下文中时才激活条目。 NOT ALL = 如果所有可选过滤器都在扫描上下文中，则尽管有主键触发，仍会阻止激活条目。 这些键还支持 正则表达式. 参赛内容 输入激活后插入提示词的文本。 广告订单 数值。如果同时激活多个条目，则定义条目的优先级。具有较大订单号的条目将被插入到靠近上下文末尾的位置，因为它们将对输出产生更大的影响。例如，订单号为 100 的条目将出现在上下文中订单号为 250 的条目之前。 插入位置 在字符定义之前： 世界书条目插入在角色的描述和场景之前。对谈话有中等影响。 字符定义后： 世界书条目插入在角色的描述和场景之后。对谈话的影响较大。 示例消息之前： 世界书条目被解析为示例对话块并插入到角色卡提供的示例之前。 示例消息之后： 世界书条目被解析为示例对话块并插入到角色卡提供的示例之后。 AN 顶部： 世界书条目插入到作者注释内容的顶部。根据作者注释位置的不同，影响也不同。 AN 底部： 世界书条目插入到作者注释内容的底部。根据作者注释位置的不同，影响也不同。 @D： 世界书条目插入到聊天中的特定深度（深度 0 是提示词的底部）。 ⚙️ - 作为系统角色消息 👤 - 作为用户角色消息 🤖 - 作为助理角色消息 出口： 世界书条目不会自动注入。相反，它的内容存储在一个命名的插座下，因此您可以通过使用以下命令调用它来准确决定它在提示词中出现的位置： {{outlet::Name}} 宏. 示例消息条目将根据提示词构建设置进行格式化：指令模式或聊天补全提示词管理器。它们还遵循示例消息行为规则：在完整上下文中逐渐推出、始终保留或完全禁用。 如果您的作者注释被禁用（插入频率 = 0），则 A/N 位置中的世界书条目将被忽略！ 店铺名称 当 出口 选择插入位置后，附加 店铺名称 字段可供输入。您在此处提供的名称将条目分组在一起，并定义 token，您将使用该名称将它们手动拉入提示词。 使用 {{outlet::YourName}} 宏中的 提示词管理器 或 高级格式设置 提示词字段。构建提示词时，宏将替换为共享相同插座名称的每个世界书条目的组合内容，以换行符分隔，按其排序 广告订单 值。 如果出口条目缺少名称，它将在生成过程中被跳过，因此请务必填写该字段。插座名称支持根据您已使用的名称自动完成，以便轻松重复使用一致的标签。 限制和注意事项 不支持将插座宏放置在世界书条目内，并且不会起作用。这与世界书的求值顺序冲突，可能导致无限循环。 不支持嵌套插座。您不能将插座宏放置在另一个插座的内容中。与上面相同，这可能会导致无限循环。 角色卡字段（描述、个性、场景等）无法扩展网点。这些字段会被尽早解析，因此它们可以充当 额外的匹配源 对于世界书触发器，这意味着处理文本时插座不可用。如果您需要将插座内容放置在提示词主体中，请使用另一个宏感知字段。 作者注释编辑器也无法解析插座。要将插座内容放置在作者注释周围，请将条目分配给 AN 顶部 或 AN 底部 插入位置而不是依赖宏。 插座名称区分大小写。的 {{outlet::}} 宏必须使用与条目完全相同的大小写 店铺名称，否则不返回任何内容。 当您调用宏时，插座名称中的前导或尾随空格将被忽略，因此使用额外空格保存的名称将不匹配。避免填充名称，以便正确解析它们。 没有分配内容的插座宏将被替换为空字符串。 参赛作品标题/备注 一个文本字段，方便您标记您的条目，AI 或任何触发逻辑都不会使用该文本字段。 如果为空，可以通过单击“填充空备忘录”按钮，使用条目的第一个键进行回填。 策略 🔵（蓝色圆圈）=该条目不需要任何关键字，无论内容如何都会触发。 🟢（绿色圆圈）= 仅当存在关键字时才会触发输入。 🔗（链链接）=允许通过嵌入相似性来插入条目。 每个条目还有一个切换开关，允许您启用或禁用该条目。 概率（触发%） 该值的作用就像一个附加过滤器，当通过任何方式（常量、主键、递归）激活条目时，该过滤器增加了条目不被插入的机会。 概率 = 100 表示该条目将在每次激活时插入。 概率 = 50 表示该条目将以 1:1 的机会插入。 概率 = 0 意味着该条目不会被插入（本质上是禁用它）。 使用它可以在聊天中创建随机事件。例如，如果消息中提到了古神的名字，则每条消息都有 1% 的机会唤醒古神的名字。 共融集团 包含组控制同时触发具有相同组标签的多个条目时如何选择条目。如果激活了具有相同组标签的多个条目，则只有一个条目将被插入到提示词中。 默认情况下，所选条目是根据其组权重（默认为 100 分）随机选择的 - 数字越大，选择的概率越高。这允许在触发的条目中进行随机选择，为交互添加惊喜和多样性的元素。 如果将多个包含组定义为以逗号分隔的列表，则单个条目可以是多个包含组的一部分。将适用与上面解释的相同的逻辑。如果该条目被触发，它将 禁用 属于其任何组的所有其他条目。因此，如果任何组被激活，则该条目将不会被激活。 优先考虑包容性 为了更好地控制哪些条目被激活 共融集团，您可以使用“优先包含”设置。此选项允许您确定性地指定选择哪个条目，而不是随机滚动组权重机会。 如果激活了具有相同组标签且打开此设置的多个条目，则将选择“顺序”值最高的条目。这对于通过包含组创建后备序列非常有用。例如，更加重视低深度条目的优先级，或者如果两者都有效，则选择关于设置场景的特定指令而不是另一个指令。 使用小组评分 当全局或每个条目启用此设置时，激活的条目键的数量决定了组获胜者的选择。只有关键匹配数量最多的组子集才会被组权重或包含优先级激活 - 其余的将被停用并从组中删除。 使用它可以为大组中的单个条目提供更多特异性。例如，它们可以具有公共密钥和特定密钥。当未提供特定密钥时，将插入随机条目，反之亦然。 主键的得分计算逻辑是1个匹配=1分。 对于辅助键，交互取决于所选的选择性逻辑： 和任意：1 次次要比赛 = 1 分。 AND ALL：如果所有辅助键都匹配，则每个辅助键得 1 分。 不是任何也不是全部：没有变化。 示例： 条目 1. 调：歌曲、歌唱、黑猫。组： 歌曲 条目 2. 调：歌曲、歌唱、鬼魂。组： 歌曲 输入 sing me a song 可以激活任一条目（均激活 2 个键），但是 sing me a song about Ghosts 将仅激活条目 2（激活 3 个键）。 自动化ID 允许将世界书条目与 ST脚本 来自快速回复扩展。如果快速回复命令和WI条目具有相同的Automation ID，则当激活具有匹配ID的条目时，将自动执行该命令。 自动化按照触发的顺序执行，遵循您指定的排序策略，结合 角色知识插入策略 通过“优先级”排序。这导致 蓝色圆圈 首先处理条目，然后按照指定的“顺序”处理其他条目。递归触发的条目将按照相同的顺序进行处理。 如果激活具有相同自动化 ID 的多个条目，则脚本命令将仅运行一次。 角色过滤器 可以激活此条目的角色名称列表。如果此列表不为空，则仅对名称在列表中的角色激活该条目。选择标签后，只有具有该特定标签的角色才会激活该条目。 “排除”模式反转过滤器，这意味着将为所有角色激活条目，但添加到列表中或具有选定标签的条目除外。 触发器 可以激活此世界书条目的生成类型。如果未选择任何内容，则可为所有生成类型激活该条目。如果选择一项或多项，则仅针对这些特定生成类型激活该条目： 正常： 定期消息生成请求。 继续： 当按下继续按钮时。 冒充： 当按下模拟按钮时。 滑动： 当通过滑动触发生成时。 再生： 在单人聊天中按下“重新生成”按钮时。 安静： 后台生成请求，通常由 扩展 或 ST脚本 命令。 “重新生成”触发器在群聊中不可用，因为它使用不同的重新生成逻辑：最后回复的所有消息都将被删除，并且根据所选的“正常”生成类型对消息进行排队 群组回复策略. 其他匹配来源 默认情况下，世界书条目仅与当前对话中的内容进行匹配。这些选项允许您将条目与聊天中未显示的不同角色信息甚至用户人设信息进行匹配。当您想要在多个角色之间使用多种条目，但又不想管理大型标签列表，或者不想每次创建新过滤器列表时都更新角色过滤器列表时，这非常有用。这还允许您根据您拥有的活动用户人设来匹配条目。 角色说明：与角色描述匹配。 角色个性：与角色个性摘要匹配，可在高级定义下找到。 场景：与角色指定场景匹配，可在高级定义下找到。 用户人设说明：与当前选定的用户人设的描述匹配。 角色的备注：与角色的注释匹配，可以在“高级定义”下找到该注释。 创作者笔记：与角色创建者的注释匹配，可以在“高级定义”下找到该注释。 提示词中通常不包含创建者的注释。 矢量存储匹配 矢量存储扩展通过利用最近的聊天消息和世界书条目内容之间的相似性，提供了关键字匹配的替代方法。 要启用和使用此功能，需要满足以下先决条件： 矢量存储扩展已启用并配置为使用可用的嵌入源之一。 在矢量存储扩展设置中勾选了“启用世界书”复选框。 允许无密钥匹配的世界书条目具有“矢量化”(🔗) 状态，或者在矢量存储设置中选中“对所有条目启用”选项。 扩展中矢量化模型的选择以及术语“嵌入”背后的理论含义将不在这里讨论。查看 资料库 如果您需要有关此主题的更多信息，请指导。 矢量存储匹配遵循这组规则： 允许与矢量存储匹配的最大条目数可以通过“最大条目”设置进行调整。该数字仅设置限制，不会影响世界书激活设置中设置的 token 预算。所有预算规则仍然适用。 此功能仅取代关键字检查。要插入的条目必须满足所有附加检查：trigger%、角色过滤器、包含组等。 不使用激活设置或条目覆盖中的“扫描深度”设置。相反，使用矢量存储“查询消息”值来获取要匹配的文本。这允许将“扫描深度”等配置设置为 0，因此不会进行常规关键字匹配，但条目仍然可以由向量激活。 “矢量化”状态只是一个附加标记。该条目的行为仍然类似于正常的、启用的、非常量的记录，如果设置了关键字，则该记录将被关键字激活。如果您希望它们仅由向量激活，请删除关键字。 注意事项 由于检索质量完全取决于嵌入模型的输出，因此不可能准确预测将插入哪些条目。如果您想要确定性和可预测的结果，请坚持关键字匹配。 定时效果 通常，世界书评估是无状态的，这意味着评估的结果是相同的，仅取决于当前的聊天上下文。但是，随着定时效果的引入，您可以创建具有激活延迟​​、触发后保持活动状态或激活后无法触发的条目。 定时效果规则 影响的时间范围以消息（而不是成对的消息/交换）来衡量，0 表示没有影响。 效果仅适用于激活该条目的聊天。分支继承父聊天的状态。 如果聊天没有进展，则活动的定时效果将被删除，例如如果最后一条消息被刷或删除。 对当前处于定时效果的条目进行任何更改都会导致该效果被强制删除。 如果关键字已经处于活动状态，则后续触发关键字不会刷新效果持续时间。 定时效果的类型 粘性 - 该条目在激活后将保持活动状态 N 条消息。粘性条目会忽略后续扫描的概率检查，直到它们过期。 冷却-该条目激活后N条消息无法激活。可以与粘滞一起使用：当粘滞持续时间结束时，条目会进入冷却状态。 延迟 - 除非评估时聊天中至少有 N 条消息，否则条目无法激活。 延迟 = 0 -> 该条目可以随时激活。 Delay = 1 -> 如果聊天为空（无问候语），则无法激活该条目。 Delay = 2 -> 如果聊天中只有零条消息或只有一条消息等，则无法激活该条目。 定时效果示例 进入配置：粘滞= 3，冷却时间= 2，延迟= 2。 Message 0: delay Message 1: entry activated Message 2: sticky Message 3: sticky Message 4: sticky Message 5: cooldown Message 6: cooldown Message 7: entry can be activated again 激活设置 世界书屏幕顶部的可折叠菜单。 扫描深度 可以在入门级别覆盖。 定义应扫描聊天历史记录中的多少条消息来查找世界书密钥。 如果设置为 0，则仅评估递归条目和作者注释。 如果设置为 1，则 SillyTavern 仅扫描最后一条消息。 2 = 最后两条消息等。 包括姓名 定义聊天参与者的姓名是否应作为消息前缀包含在扫描的文本缓冲区中。这允许激活使用名称作为关键字的条目，而无需在消息中直接提及名称。 请参阅下面要扫描的文本示例，假设聊天参与者名为 Alice 和 Bob。 启用（默认）： Alice: Hello! Good to see you. Bob: How is the weather today? 禁用： Hello! Good to see you. How is the weather today? 背景 % / 预算 定义世界书条目一次可以使用多少个 token。 您可以定义相对于 API 的最大上下文设置（上下文百分比）的阈值或目标 token 阈值（预算） 如果预算用尽，则即使提示词中存在密钥，也不会激活更多条目。 将首先插入常量条目。然后是订单号较大的条目。 通过直接提及其键插入的条目比其他条目内容中提及的条目具有更高的优先级。 最少激活次数 此设置与最大递归步骤互斥。 最小激活数：如果设置为非零值，则将忽略“扫描深度”的限制，从最新消息向后查找所有聊天日志中的关键字，直到触发了最小激活数中指定的条目。这仍然会受到最大深度设置或总体预算上限的限制。 由最小激活触发的额外扫描不会检查先前步骤中递归添加的条目。只有聊天消息和分机提示词可以触发这些额外的激活。然而，由“最小激活”激活的条目可以照常触发其他条目。 最大深度 使用“最小激活”设置时要扫描的最大深度。 递归扫描 递归扫描允许条目激活其他条目或被其他条目激活，从而实现不同世界书条目之间的复杂交互和依赖关系。此功能可以显着增强创意场景的动态特性。是否启用递归扫描可以通过全局设置来控制 递归扫描.可以使用三个选项来控制每个条目的递归： 8 不可递归：选中此复选框后，该条目将不会被其他条目激活。这对于不应更改或受其他世界书条目影响的静态信息很有用。 防止进一步递归：选择此选项可确保一旦激活此条目，就不会触发任何其他条目。这有助于避免意外的激活链。 延迟直到递归：此条目仅在递归检查期间被激活，这意味着它不会在初始阶段被触发，但可以被其他启用了递归的条目激活。现在，随着添加 递归级别 对于这些延迟，条目按级别分组。最初，只有第一级（最小的数字）会匹配。一旦找不到匹配项，下一个级别就有资格进行匹配，重复该过程直到检查完所有级别。这样可以更好地控制在递归过程中如何以及何时显示更深层次的信息，特别是与“不是任何”或“不是全部”键匹配组合等标准结合使用。 条目可以通过在内容文本中提及其他条目的关键字来激活其他条目。 例如，如果您的世界书包含两个条目： Entry #1 Keyword: Bessie Content: Bessie is a cow and is friends with Rufus. Entry #2 Keyword: Rufus Content: Rufus is a dog. 两者都 如果消息文本提到，其中的一些将被拉入上下文 只是贝西. 最大递归步数 此设置与最小激活数互斥。 当设置为零时，递归嵌套仅受提示词预算的限制。当设置为非零值时，将扫描总数限制为所需的最大“嵌套级别”。 示例值： 1 有效地禁用递归，因为检查在第一步后停止。 2 只能激活递归条目一次。 3 可以触发递归两次... 区分大小写的按键 可以在入门级别覆盖。 要进入上下文，输入键需要与世界书条目中定义的大小写匹配。 当您的关键字是常用单词或常用单词的一部分时，这非常有用。 例如，当此设置处于活动状态时，按键“rose”和“Rose”将根据输入进行不同的处理。 匹配整个单词 可以在入门级别覆盖。 仅当搜索文本中存在整个单词时，才会匹配键仅包含一个单词的条目。默认启用。 例如，启用该设置且条目关键词为“king”时，“long live the king”会匹配，而“it's not to my liking”不会匹配。 重要： 当与不使用空格分隔单词的语言（例如日语或中文）一起使用时，此设置可能会产生不利影响。如果您用这些语言撰写条目，建议不要使用。 溢出警报 如果激活的世界书超出分配的 token 预算，则显示警报。",
      "translationStatus": "machine-draft"
    },
    {
      "slug": "core-concepts/personas",
      "title": "用户人设",
      "group": "Usage",
      "order": 110,
      "source": "Usage/personas.md",
      "sourceUrl": "https://docs.sillytavern.app/usage/core-concepts/personas/",
      "sourceSha256": "e8ffbbe608d68c41f62b9ca2d1c82f24c96733cbc6b4360830dd1cb1862dea31",
      "headings": [
        {
          "id": "personas",
          "depth": 1,
          "title": "用户人设"
        },
        {
          "id": "what-is-a-persona",
          "depth": 2,
          "title": "用户人设是什么？"
        },
        {
          "id": "how-to-create-a-persona",
          "depth": 2,
          "title": "如何创建用户人设？"
        },
        {
          "id": "convert-character-to-persona",
          "depth": 3,
          "title": "将角色转换为用户人设"
        },
        {
          "id": "persona-description",
          "depth": 2,
          "title": "用户人设说明"
        },
        {
          "id": "persona-title",
          "depth": 2,
          "title": "用户人设标题"
        },
        {
          "id": "persona-connections--locking",
          "depth": 2,
          "title": "用户人设连接/锁定"
        },
        {
          "id": "1-lock-to-a-chat",
          "depth": 3,
          "title": "1. 锁定聊天"
        },
        {
          "id": "2-lock-to-a-character",
          "depth": 3,
          "title": "2. 锁定到角色"
        },
        {
          "id": "locking-multiple-personas-to-the-same-character",
          "depth": 4,
          "title": "将多个用户人设锁定到同一角色"
        },
        {
          "id": "3-default-persona",
          "depth": 3,
          "title": "3.默认用户人设"
        },
        {
          "id": "temporary-persona",
          "depth": 3,
          "title": "临时用户人设"
        },
        {
          "id": "global-persona-settings",
          "depth": 2,
          "title": "全局用户人设设置"
        },
        {
          "id": "slash-commands-for-personas",
          "depth": 2,
          "title": "用户人设的斜杠命令"
        },
        {
          "id": "persona-lock-typetype",
          "depth": 3,
          "title": "/persona-lock type=<type?>"
        },
        {
          "id": "persona-name",
          "depth": 3,
          "title": "/persona <name>"
        },
        {
          "id": "persona-sync",
          "depth": 3,
          "title": "/persona-sync"
        },
        {
          "id": "pro-tips",
          "depth": 2,
          "title": "专业提示"
        }
      ],
      "content": "# 用户人设\n\n## 用户人设是什么？\n\nSillyTavern 中的用户人设是你参与聊天时使用的身份，由显示名称、头像和可选的描述文字组成。用户人设让你可以轻松切换说话时扮演的身份或“角色”，而不必每次都手动修改用户名和头像。\n\n> **注意：** 未绑定到用户人设的旧版用户头像和名称已被移除。现有数据将迁移为用户人设。如果未指定名称，该人设将命名为“\\[Unnamed Persona]”。\n\n## 如何创建用户人设？\n\n1. 打开 **用户人设管理** 面板（<i class=\"fa-solid fa-face-smile\"></i> 顶部菜单中的按钮）。\n2. 创建一个空白的用户人设 **创建** 按钮并为其命名。\n3. 在用户人设列表中，选择刚创建的人设。\n4. 在右侧填写描述，并通过“更改人设图片（Change Persona Image）”按钮设置头像。这两项均为可选。\n5. 现在您的用户人设就可以在聊天中使用了。\n\n### 将角色转换为用户人设\n\n你也可以将已有角色转换为用户人设。打开角色，选择“更多（More...）”，然后点击“转换为用户人设（Convert to Persona）”，即可创建名称和描述相同的人设。场景、性格等其他角色卡字段不会被使用，原角色也不会被删除。\n\n> **注意事项**\n>\n> 自从 `{{user}}` 和 `{{char}}` 宏在用户人设和角色描述中使用时具有相反的含义，如果转换后的描述包含其中任何一个，系统将提示您交换它们。\n\n## 用户人设说明\n\n每个人设都能保存自定义文字描述，例如心理和外貌特征、年龄、职业或其他个人信息。描述也可以包含模板宏，例如 `{{char}}` 或 `{{user}}` （见 [宏](/guides/sillytavern/core-concepts/macros/)).\n\n用户人设描述在 AI 提示词中的注入位置取决于 **职位** 用户人设管理面板中的设置：\n\n- **无（禁用）**\n- **故事串中 / 提示词管理器** （默认）\n- **作者注释顶部** / **作者注释底部** （只有当存在作者注释时才会添加）\n- **在聊天@深度** （这会显示用于设置深度和消息角色的配置选项）\n\n位置已保存 **每用户人设**.\n\n## 用户人设标题\n\n标题是可选文本字段，可用于存储有关用户人设的附加信息，在提示词中不使用，但显示在用户人设管理面板中。\n\n要设置标题，请单击 **<i class=\"fa-solid fa-pencil\"></i> 重命名用户人设**按钮在用户人设管理面板并在“标题”中输入用户人设标题”字段，或在用户人设创建。当标题已存在时设置空值会将其删除。\n\n## 用户人设连接/锁定\n\n用户人设连接确保在某些情况下自动选择给定的用户人设。如果没有连接用户人设，则当前选择的用户人设将保持选中状态。\n\n锁定有以下三种类型：\n\n1. **<i class=\"fa-solid fa-unlock\"></i> 聊天锁** – 用户人设已锁定当前聊天。\n2. **<i class=\"fa-solid fa-unlock\"></i> 角色锁** – 用户人设被锁定到特定的角色。\n3. **<i class=\"fa-solid fa-crown\"></i> 默认用户人设** – 当没有其他锁适用时使用一个用户人设。\n\n### 1. 锁定聊天\n\n如果用户人设被锁定到某个聊天，以后打开该聊天将自动将您的活动用户人设切换到锁定的聊天。\n\n- **锁定**：选择需要的用户人设，然后点击 **<i class=\"fa-solid fa-unlock\"></i> 聊天** “连接”部分下的按钮（或使用 `/persona-lock type=chat on`).\n- **解锁**：再次单击该按钮（或使用 `/persona-lock type=chat off`).\n\n### 2. 锁定到角色\n\n您还可以将用户人设链接到特定的角色。打开与该角色的任何聊天都会自动选择您锁定的用户人设。\n\n- **锁定**：选择需要的用户人设，然后点击 **<i class=\"fa-solid fa-unlock\"></i> 角色** “连接”部分下的按钮（或使用 `/persona-lock type=character on`).\n- **解锁**：再次单击该按钮（或使用 `/persona-lock type=character off`).\n\n用户人设管理面板还显示哪个角色链接到该用户人设（显示为小头像）。单击它们可直接导航至角色的聊天室。\n\n#### 将多个用户人设锁定到同一角色\n\n如果另一个用户人设已经与该角色链接，则默认情况下它将自动取消链接。\n\n要同时链接多个用户人设，全局设置 **每个角色允许多个用户人设连接** 可以使用。\\\n如果多个用户人设链接到同一个角色，您将看到一个弹出窗口，询问您每次打开或开始与该角色的新聊天时使用哪个用户人设（除非用户人设绑定到聊天）。\n\n### 3.默认用户人设\n\n你的 **默认用户人设** 当没有其他相关锁时使用。默认的用户人设可以通过其头像周围的黄色边框来识别。\n\n- **设置/取消设置默认值**：选择需要的用户人设，然后点击 **<i class=\"fa-solid fa-crown\"></i> 默认** “连接”部分下的按钮（或使用 `/persona-lock type=default`).\n\n只能选择一个用户人设作为默认用户人设。\n\n### 临时用户人设\n\n如果三个连接选项中的任何一个将用户人设连接到当前角色/聊天，您仍然可以选择使用不同的用户人设。此用户人设将在用户人设面板中标记为“临时用户人设”。浏览器窗口的任何重新加载或切换到不同的聊天并返回都会将其再次重置为链接的用户人设。\n\n您可以手动 *转换* 临时用户人设通过将其链接到聊天来保持连接。\n\n## 全局用户人设设置\n\n下的所有设置 **当前用户人设** 按用户人设保存。也存在一些全局设置，这些可以在下面找到 **全局用户人设设置** 在用户人设管理面板中。\n\n1. **显示切换通知用户人设**\n   - 启用与用户人设相关的 toast 消息（例如，“用户人设自动选择”、“临时用户人设”）。\n\n2. **每个角色允许多个用户人设连接**\n   - 当 **已启用**，您可以将多个用户人设链接到单个角色。打开角色的聊天将提示词您选择使用哪个用户人设。如果禁用，则一次只能将一个用户人设连接到角色。\n\n3. **自动将选定的用户人设锁定到聊天中**\n   - 当 **已启用**，任何时候您选择用户人设（手动或自动选择）或创建新聊天时，都会将该用户人设锁定到聊天。\\\n     与“允许多个”相结合，可以选择每个角色选择一个用户人设，但一旦选择用于聊天，就保持其绑定。\n\n## 用户人设的斜杠命令\n\n### `/persona-lock type=<type?>`\n\n- `chat` 将当前用户人设锁定到您的活动聊天。\n- `character` 将当前用户人设锁定到正在使用的角色。\n- `none` （或无参数）解锁/清除当前上下文的用户人设锁。\n- 如果不带参数使用，它将返回当前的锁定状态（如果未设置，则返回错误）。\n- 可以通过以下方式选择锁定状态 `on`, `off` 或 `toggle`。默认为切换。\n\n### `/persona <name>`\n\n- 通过名称快速切换活动的用户人设，无需打开用户人设管理面板。\n- 示例： `/persona Blaze`.\n- 使用 `mode=temp` 允许临时设置您的姓名 **当前** 用户人设，即使可能已经存在同名的用户人设（保留您当前的头像和描述）。\n\n### `/persona-sync`\n\n- 将活动聊天中的所有用户消息重新归因于 **当前** 用户人设及其名称。\n\n> **注意：** 年龄较大的 `/lock` 和 `/unlock` 命令保留是为了向后兼容，但将来可能会被删除。使用 `/persona-lock` 相反。\n\n## 专业提示\n\n1. **聊天中切换用户人设** 不会将您过去的用户消息重新归因于新的用户人设；这些仍然归因于您当时使用的用户人设。\n2. **批量重新归因**：如果您需要所有先前的消息来匹配新的用户人设，请点击 **同步** 按钮或使用 `/persona-sync`.\n3. **替换用户人设图像** 通过选择您的用户人设并单击 **<i class=\"fa-solid fa-images\"></i> 更改用户人设图像** 按钮。\n4. **角色链接弹出窗口**：如果多个用户人设链接到同一个角色，您每次打开聊天时都会弹出一个窗口来选择哪个用户人设。这是一种方便的方法，可以为特定的角色选择一小部分用户人设。\n5. **备份**：您可以使用以下命令备份整个用户人设列表（名称、角色连接、描述） **备份** 用户人设管理中的按钮，并在以后需要时恢复。\n\n> **备份备注**\n>\n> - 图像和聊天连接不会与用户人设一起保存，也不会通过此备份。\n> - 这些备份不适合共享，因为它们包含内部链接。\n",
      "searchText": "用户人设 用户人设是什么？ SillyTavern 中的用户人设是你参与聊天时使用的身份，由显示名称、头像和可选的描述文字组成。用户人设让你可以轻松切换说话时扮演的身份或“角色”，而不必每次都手动修改用户名和头像。 注意： 未绑定到用户人设的旧版用户头像和名称已被移除。现有数据将迁移为用户人设。如果未指定名称，该人设将命名为“[Unnamed Persona]”。 如何创建用户人设？ 打开 用户人设管理 面板（ 顶部菜单中的按钮）。 创建一个空白的用户人设 创建 按钮并为其命名。 在用户人设列表中，选择刚创建的人设。 在右侧填写描述，并通过“更改人设图片（Change Persona Image）”按钮设置头像。这两项均为可选。 现在您的用户人设就可以在聊天中使用了。 将角色转换为用户人设 你也可以将已有角色转换为用户人设。打开角色，选择“更多（More...）”，然后点击“转换为用户人设（Convert to Persona）”，即可创建名称和描述相同的人设。场景、性格等其他角色卡字段不会被使用，原角色也不会被删除。 注意事项 自从 {{user}} 和 {{char}} 宏在用户人设和角色描述中使用时具有相反的含义，如果转换后的描述包含其中任何一个，系统将提示您交换它们。 用户人设说明 每个人设都能保存自定义文字描述，例如心理和外貌特征、年龄、职业或其他个人信息。描述也可以包含模板宏，例如 {{char}} 或 {{user}} （见 宏). 用户人设描述在 AI 提示词中的注入位置取决于 职位 用户人设管理面板中的设置： 无（禁用） 故事串中 / 提示词管理器 （默认） 作者注释顶部 / 作者注释底部 （只有当存在作者注释时才会添加） 在聊天@深度 （这会显示用于设置深度和消息角色的配置选项） 位置已保存 每用户人设. 用户人设标题 标题是可选文本字段，可用于存储有关用户人设的附加信息，在提示词中不使用，但显示在用户人设管理面板中。 要设置标题，请单击 重命名用户人设按钮在用户人设管理面板并在“标题”中输入用户人设标题”字段，或在用户人设创建。当标题已存在时设置空值会将其删除。 用户人设连接/锁定 用户人设连接确保在某些情况下自动选择给定的用户人设。如果没有连接用户人设，则当前选择的用户人设将保持选中状态。 锁定有以下三种类型： 聊天锁 – 用户人设已锁定当前聊天。 角色锁 – 用户人设被锁定到特定的角色。 默认用户人设 – 当没有其他锁适用时使用一个用户人设。 1. 锁定聊天 如果用户人设被锁定到某个聊天，以后打开该聊天将自动将您的活动用户人设切换到锁定的聊天。 锁定：选择需要的用户人设，然后点击 聊天 “连接”部分下的按钮（或使用 /persona-lock type=chat on). 解锁：再次单击该按钮（或使用 /persona-lock type=chat off). 2. 锁定到角色 您还可以将用户人设链接到特定的角色。打开与该角色的任何聊天都会自动选择您锁定的用户人设。 锁定：选择需要的用户人设，然后点击 角色 “连接”部分下的按钮（或使用 /persona-lock type=character on). 解锁：再次单击该按钮（或使用 /persona-lock type=character off). 用户人设管理面板还显示哪个角色链接到该用户人设（显示为小头像）。单击它们可直接导航至角色的聊天室。 将多个用户人设锁定到同一角色 如果另一个用户人设已经与该角色链接，则默认情况下它将自动取消链接。 要同时链接多个用户人设，全局设置 每个角色允许多个用户人设连接 可以使用。如果多个用户人设链接到同一个角色，您将看到一个弹出窗口，询问您每次打开或开始与该角色的新聊天时使用哪个用户人设（除非用户人设绑定到聊天）。 3.默认用户人设 你的 默认用户人设 当没有其他相关锁时使用。默认的用户人设可以通过其头像周围的黄色边框来识别。 设置/取消设置默认值：选择需要的用户人设，然后点击 默认 “连接”部分下的按钮（或使用 /persona-lock type=default). 只能选择一个用户人设作为默认用户人设。 临时用户人设 如果三个连接选项中的任何一个将用户人设连接到当前角色/聊天，您仍然可以选择使用不同的用户人设。此用户人设将在用户人设面板中标记为“临时用户人设”。浏览器窗口的任何重新加载或切换到不同的聊天并返回都会将其再次重置为链接的用户人设。 您可以手动 转换 临时用户人设通过将其链接到聊天来保持连接。 全局用户人设设置 下的所有设置 当前用户人设 按用户人设保存。也存在一些全局设置，这些可以在下面找到 全局用户人设设置 在用户人设管理面板中。 显示切换通知用户人设 启用与用户人设相关的 toast 消息（例如，“用户人设自动选择”、“临时用户人设”）。 每个角色允许多个用户人设连接 当 已启用，您可以将多个用户人设链接到单个角色。打开角色的聊天将提示词您选择使用哪个用户人设。如果禁用，则一次只能将一个用户人设连接到角色。 自动将选定的用户人设锁定到聊天中 当 已启用，任何时候您选择用户人设（手动或自动选择）或创建新聊天时，都会将该用户人设锁定到聊天。与“允许多个”相结合，可以选择每个角色选择一个用户人设，但一旦选择用于聊天，就保持其绑定。 用户人设的斜杠命令 /persona-lock type=<type?> chat 将当前用户人设锁定到您的活动聊天。 character 将当前用户人设锁定到正在使用的角色。 none （或无参数）解锁/清除当前上下文的用户人设锁。 如果不带参数使用，它将返回当前的锁定状态（如果未设置，则返回错误）。 可以通过以下方式选择锁定状态 on, off 或 toggle。默认为切换。 /persona <name> 通过名称快速切换活动的用户人设，无需打开用户人设管理面板。 示例： /persona Blaze. 使用 mode=temp 允许临时设置您的姓名 当前 用户人设，即使可能已经存在同名的用户人设（保留您当前的头像和描述）。 /persona-sync 将活动聊天中的所有用户消息重新归因于 当前 用户人设及其名称。 注意： 年龄较大的 /lock 和 /unlock 命令保留是为了向后兼容，但将来可能会被删除。使用 /persona-lock 相反。 专业提示 聊天中切换用户人设 不会将您过去的用户消息重新归因于新的用户人设；这些仍然归因于您当时使用的用户人设。 批量重新归因：如果您需要所有先前的消息来匹配新的用户人设，请点击 同步 按钮或使用 /persona-sync. 替换用户人设图像 通过选择您的用户人设并单击 更改用户人设图像 按钮。 角色链接弹出窗口：如果多个用户人设链接到同一个角色，您每次打开聊天时都会弹出一个窗口来选择哪个用户人设。这是一种方便的方法，可以为特定的角色选择一小部分用户人设。 备份：您可以使用以下命令备份整个用户人设列表（名称、角色连接、描述） 备份 用户人设管理中的按钮，并在以后需要时恢复。 备份备注 图像和聊天连接不会与用户人设一起保存，也不会通过此备份。 这些备份不适合共享，因为它们包含内部链接。",
      "translationStatus": "machine-draft"
    },
    {
      "slug": "welcome-assistants",
      "title": "欢迎页助手",
      "group": "Usage",
      "order": 0,
      "source": "Usage/welcome-assistants.md",
      "sourceUrl": "https://docs.sillytavern.app/usage/welcome-assistants/",
      "sourceSha256": "60670bcbbd97084adb6bf5fee6c3b34effab631e8624f37a23e0fa4296239d3a",
      "headings": [
        {
          "id": "welcome-page-assistants",
          "depth": 1,
          "title": "欢迎页助手"
        },
        {
          "id": "the-welcome-screen",
          "depth": 2,
          "title": "欢迎屏幕"
        },
        {
          "id": "temporary-chat",
          "depth": 2,
          "title": "临时聊天"
        },
        {
          "id": "what-is-a-welcome-page-assistant",
          "depth": 2,
          "title": "什么是欢迎页面助手？"
        },
        {
          "id": "setting-and-unsetting-an-assistant",
          "depth": 3,
          "title": "设置和取消设置助手"
        },
        {
          "id": "interacting-with-the-assistant",
          "depth": 3,
          "title": "与助理互动"
        },
        {
          "id": "default-assistant",
          "depth": 2,
          "title": "默认助手"
        }
      ],
      "content": "# 欢迎页助手\n\nSillyTavern 具有欢迎屏幕，可以用指定的“助理”角色来迎接您。当您在没有活动聊天的情况下启动 SillyTavern 或关闭上次聊天会话后，会出现此屏幕。\n\n> **注意事项**\n>\n> 如果您在应用程序启动时没有看到欢迎屏幕，请确保在“聊天/消息处理”部分中禁用“自动加载上次聊天”选项。 **<i class=\"fa-solid fa-user-cog\"></i> 用户设置** 面板。如果启用此选项，SillyTavern 将自动加载您的最后一次聊天，而不是显示欢迎屏幕。\n\n## 欢迎屏幕\n\n当没有聊天处于活动状态时，欢迎屏幕提供了几个有用的元素：\n\n- **SillyTavern 版本：** 显示应用程序的徽标和当前版本。\n- **快速链接：** 轻松访问：\n  - **文件：** 打开官方 SillyTavern 文档（您已经在这里了！）。\n  - **GitHub：** 带您前往 SillyTavern GitHub 存储库 (<https://github.com/SillyTavern/SillyTavern>).\n  - **不和谐：** 提供官方 SillyTavern Discord 服务器的链接 (<https://discord.gg/sillytavern>).\n- **临时聊天按钮：** 允许您与默认的中立助手快速启动新的临时聊天会话，除非您明确保存，否则该会话不会保存到您的聊天历史记录中。\n- **最近聊天区域：** 列出您最近的对话以便快速访问。您可以：\n  - 显示或隐藏此部分。\n  - 如果有超过 3 个聊天可用（最多 15 个最近聊天），请展开列表。\n\n## 临时聊天\n\n> **注意事项**\n>\n> 由于技术限制，临时聊天功能不会使用您自定义的欢迎页面助手。它总是会开始一个空聊天，没有任何附加的提示词或角色信息。\n\n临时聊天按钮可以快速开始新的聊天会话，而不将其保存到聊天历史中。这适合测试或随意聊天，不会让保存的聊天列表变得杂乱。一旦关闭该聊天或切换到其他聊天，这段临时聊天就会被删除。\n\n- **保存** 按钮可将临时聊天导出为 JSONL 文件，以便之后重新导入。\n- **负载** 按钮可恢复此前保存的临时聊天文件。\n\n## 什么是欢迎页面助手？\n\n欢迎页助手是你选择在欢迎页面上展示的角色。它可以提供个性化问候，让你一打开应用就能快速与熟悉的角色开始聊天。\n\n### 设置和取消设置助手\n\n您可以选择任何一个角色作为您的欢迎页面助手。\n\n**设置助手：**\n\n1. 导航至 **角色管理** 面板（通常通过右侧边栏中的 <i class=\"fa-solid fa-address-card\"></i> 图标）。\n2. 在列表中找到您想要设置为助手的角色。\n3. 单击“更多...”并选择 **“设置/取消设置为欢迎页面助手”** 从下拉菜单中选择。\n4. 一个小图标（<i class=\"fa-solid fa-user-graduate\"></i>) 将出现在角色名称旁边，表明他们现在是您活动的欢迎页面助理。\n\n**取消助手设置：**\n\n1. 进入角色管理面板。\n2. 找到您当前的欢迎页面助理（他们将拥有 <i class=\"fa-solid fa-user-graduate\"></i> 图标）。\n3. 单击“更多...”并选择 **“设置/取消设置为欢迎页面助手”** 再次。\n4. 角色将不再是你的助手， <i class=\"fa-solid fa-user-graduate\"></i> 图标会消失。\n5. SillyTavern 将恢复使用默认助手（见下文）。\n\n### 与助理互动\n\n当欢迎屏幕与您选择的助手一起显示后，只需在屏幕底部的聊天输入栏中输入您的消息，然后按 Enter 或单击发送按钮即可。这将与您的欢迎页面助理启动新的聊天会话。\n\n要打开之前与助手的聊天，请使用“最近聊天”部分或在 **管理聊天文件** 对话框（可通过 **<i class=\"fa-solid fa-bars\"></i> 选项** 菜单）。\n\n## 默认助手\n\n当您第一次与欢迎屏幕交互时，SillyTavern 会自动创建一个名为“助手”的默认角色。如果您尚未将特定的角色设置为欢迎页面助手，则此角色可用作后备选项。\n\n默认助手没有附加任何特定的提示词，您可以根据需要自由定制它（例如重命名、添加图片或设置个性）。\n\n- 如果您尚未明确将角色设置为欢迎页面助手，则将使用此默认助手。\n- 如果您取消设置所选的助手，系统将恢复为该默认助手。\n- 如果您设置为助手的角色被删除，系统也会恢复为默认助手。\n\n**注意：** 您无法像取消设置您选择的角色一样“取消设置”默认系统助手。要更改默认助手，您必须将另一台角色设置为助手。\n",
      "searchText": "欢迎页助手 SillyTavern 具有欢迎屏幕，可以用指定的“助理”角色来迎接您。当您在没有活动聊天的情况下启动 SillyTavern 或关闭上次聊天会话后，会出现此屏幕。 注意事项 如果您在应用程序启动时没有看到欢迎屏幕，请确保在“聊天/消息处理”部分中禁用“自动加载上次聊天”选项。 用户设置 面板。如果启用此选项，SillyTavern 将自动加载您的最后一次聊天，而不是显示欢迎屏幕。 欢迎屏幕 当没有聊天处于活动状态时，欢迎屏幕提供了几个有用的元素： SillyTavern 版本： 显示应用程序的徽标和当前版本。 快速链接： 轻松访问： 文件： 打开官方 SillyTavern 文档（您已经在这里了！）。 GitHub： 带您前往 SillyTavern GitHub 存储库 (https://github.com/SillyTavern/SillyTavern). 不和谐： 提供官方 SillyTavern Discord 服务器的链接 (https://discord.gg/sillytavern). 临时聊天按钮： 允许您与默认的中立助手快速启动新的临时聊天会话，除非您明确保存，否则该会话不会保存到您的聊天历史记录中。 最近聊天区域： 列出您最近的对话以便快速访问。您可以： 显示或隐藏此部分。 如果有超过 3 个聊天可用（最多 15 个最近聊天），请展开列表。 临时聊天 注意事项 由于技术限制，临时聊天功能不会使用您自定义的欢迎页面助手。它总是会开始一个空聊天，没有任何附加的提示词或角色信息。 临时聊天按钮可以快速开始新的聊天会话，而不将其保存到聊天历史中。这适合测试或随意聊天，不会让保存的聊天列表变得杂乱。一旦关闭该聊天或切换到其他聊天，这段临时聊天就会被删除。 保存 按钮可将临时聊天导出为 JSONL 文件，以便之后重新导入。 负载 按钮可恢复此前保存的临时聊天文件。 什么是欢迎页面助手？ 欢迎页助手是你选择在欢迎页面上展示的角色。它可以提供个性化问候，让你一打开应用就能快速与熟悉的角色开始聊天。 设置和取消设置助手 您可以选择任何一个角色作为您的欢迎页面助手。 设置助手： 导航至 角色管理 面板（通常通过右侧边栏中的 图标）。 在列表中找到您想要设置为助手的角色。 单击“更多...”并选择 “设置/取消设置为欢迎页面助手” 从下拉菜单中选择。 一个小图标（) 将出现在角色名称旁边，表明他们现在是您活动的欢迎页面助理。 取消助手设置： 进入角色管理面板。 找到您当前的欢迎页面助理（他们将拥有 图标）。 单击“更多...”并选择 “设置/取消设置为欢迎页面助手” 再次。 角色将不再是你的助手， 图标会消失。 SillyTavern 将恢复使用默认助手（见下文）。 与助理互动 当欢迎屏幕与您选择的助手一起显示后，只需在屏幕底部的聊天输入栏中输入您的消息，然后按 Enter 或单击发送按钮即可。这将与您的欢迎页面助理启动新的聊天会话。 要打开之前与助手的聊天，请使用“最近聊天”部分或在 管理聊天文件 对话框（可通过 选项 菜单）。 默认助手 当您第一次与欢迎屏幕交互时，SillyTavern 会自动创建一个名为“助手”的默认角色。如果您尚未将特定的角色设置为欢迎页面助手，则此角色可用作后备选项。 默认助手没有附加任何特定的提示词，您可以根据需要自由定制它（例如重命名、添加图片或设置个性）。 如果您尚未明确将角色设置为欢迎页面助手，则将使用此默认助手。 如果您取消设置所选的助手，系统将恢复为该默认助手。 如果您设置为助手的角色被删除，系统也会恢复为默认助手。 注意： 您无法像取消设置您选择的角色一样“取消设置”默认系统助手。要更改默认助手，您必须将另一台角色设置为助手。",
      "translationStatus": "machine-draft"
    },
    {
      "slug": "chatting",
      "title": "聊天",
      "group": "Chatting",
      "order": 170,
      "source": "Usage/Chatting/index.md",
      "sourceUrl": "https://docs.sillytavern.app/usage/chatting/",
      "sourceSha256": "364341923fdc5bec860edc6ec2c25bc660c5d07aad22ab8e247a98d24288a2d0",
      "headings": [
        {
          "id": "chatting",
          "depth": 1,
          "title": "聊天"
        },
        {
          "id": "message-actions-panel",
          "depth": 2,
          "title": "消息操作面板"
        },
        {
          "id": "core-functions",
          "depth": 3,
          "title": "核心功能"
        },
        {
          "id": "message-visibility",
          "depth": 3,
          "title": "消息可见性"
        },
        {
          "id": "content-management",
          "depth": 3,
          "title": "内容管理"
        },
        {
          "id": "edit-message-content",
          "depth": 2,
          "title": "编辑消息内容"
        },
        {
          "id": "core-actions",
          "depth": 3,
          "title": "核心行动"
        },
        {
          "id": "message-operations",
          "depth": 3,
          "title": "消息操作"
        },
        {
          "id": "message-position",
          "depth": 3,
          "title": "留言位置"
        },
        {
          "id": "chat-options-panel",
          "depth": 2,
          "title": "聊天选项面板"
        },
        {
          "id": "display-controls",
          "depth": 3,
          "title": "显示控制"
        },
        {
          "id": "generation-settings",
          "depth": 3,
          "title": "生成设置"
        },
        {
          "id": "chat-navigation",
          "depth": 3,
          "title": "聊天导航"
        },
        {
          "id": "chat-management",
          "depth": 3,
          "title": "聊天管理"
        },
        {
          "id": "message-controls",
          "depth": 3,
          "title": "消息控制"
        },
        {
          "id": "token-probabilities-panel",
          "depth": 2,
          "title": "代币概率面板"
        },
        {
          "id": "rerolling",
          "depth": 3,
          "title": "重新滚动"
        },
        {
          "id": "controls",
          "depth": 3,
          "title": "控制"
        },
        {
          "id": "availability",
          "depth": 3,
          "title": "可用性"
        },
        {
          "id": "text-completion",
          "depth": 4,
          "title": "文本补全"
        },
        {
          "id": "chat-completion",
          "depth": 4,
          "title": "聊天补全"
        }
      ],
      "content": "# 聊天\n\n当你是 [连接到 API](/guides/sillytavern/api-connections/)，通过在屏幕底部的聊天栏中键入内容向 AI 发送消息。然后点击 <i class=\"fa-solid fa-paper-plane\"></i> **发送** 或按 Enter 键。\n![聊天栏](/docs/sillytavern/static/chatbox.png)\n\n人工智能将回复一条消息，继续对话。\n\n![聊天消息](/docs/sillytavern/static/chatmessage.png)\n\n您现在可以：\n\n- **发送另一条消息**\n- **滑动回复**：单击 <i class=\"fa-solid fa-chevron-right\"></i> **滑动切换回复** 消息上的按钮以生成不同的响应。\n- **编辑消息**：单击 <i class=\"fa-solid fa-pencil\"></i> **编辑** 任何消息上的按钮 [编辑消息内容](#edit-message-content).\n- **消息操作**：单击 <i class=\"fa-solid fa-ellipsis\"></i> **消息操作** 消息上的按钮了解更多信息 [消息选项](#message-actions-panel) 喜欢 [翻译](https://docs.sillytavern.app/extensions/translation/)、图像生成和故事分支。\n- **聊天选项**：单击 <i class=\"fa-solid fa-bars\"></i> **选项** 聊天栏旁边的按钮了解更多信息 [聊天选项](#chat-options-panel) 比如作者笔记和聊天文件管理。\n\n> **编辑和滑动切换回复**\n>\n> 如果您希望说不同的话，您可以编辑您的消息，然后滑动切换回复 AI 的响应以获得新的消息。\n\n> **键盘快捷键**\n>\n> 您还可以使用 **右** 方向键指向滑动切换回复，然后 **向上** 箭头键可编辑聊天中的最后一条消息。如需更多热键，请使用 `/help hotkeys` [斜线命令](/guides/sillytavern/core-concepts/slashcommands/) 在聊天中或查看 [热键](/guides/sillytavern/hotkeys/) 页。\n\n## 消息操作面板\n\n通过消息上的省略号 (•••) 按钮管理各个聊天消息。\n\n要为聊天中的所有消息显示这些选项，请启用 [展开消息操作](/guides/sillytavern/core-concepts/uicustomization/#theme-toggles) 在您的用户设置中进行设置。\n\n### 核心功能\n\n- <i class=\"fa-solid fa-language\"></i> **翻译**：将消息转换为不同的语言\n- <i class=\"fa-solid fa-paintbrush\"></i> **生成图像**: [创建图像](https://docs.sillytavern.app/extensions/stable-diffusion/) 从消息内容来看\n- <i class=\"fa-solid fa-bullhorn\"></i> **叙述**: [文字转语音](https://docs.sillytavern.app/extensions/tts/) 转换\n- <i class=\"fa-solid fa-square-poll-horizontal\"></i> **提示词**：查看生成提示词和token的使用情况\n\n### 消息可见性\n\n- <i class=\"fa-solid fa-eye\"></i> **包含**：AI看到这条消息；单击以排除它\n- <i class=\"fa-solid fa-eye-slash\"></i> **排除**：AI看不到这条消息；单击以包含它\n\n### 内容管理\n\n- <i class=\"fa-solid fa-paperclip\"></i> **嵌入**: [附加文件或图像](/guides/sillytavern/core-concepts/data-bank/#about-documents)\n- <i class=\"fa-solid fa-flag-checkered\"></i> **检查站**：创建故事检查点\n- <i class=\"fa-solid fa-flag\"></i> **检查站导航**：点击打开检查点聊天，Shift+点击更新\n  现有检查点\n- <i class=\"fa-solid fa-code-branch\"></i> **分公司**：开始替代故事路径\n- <i class=\"fa-solid fa-copy\"></i> **复制**：复制消息文本\n- <i class=\"fa-solid fa-pencil\"></i> **编辑**：编辑消息内容\n\n## 编辑消息内容\n\n一个紧凑的消息处理工具面板，当您 <i class=\"fa-solid fa-pencil\"></i> **编辑** 聊天\n消息。\n\n### 核心行动\n\n- <i class=\"fa-solid fa-check\"></i> **确认**：保存消息更改\n- <i class=\"fa-solid fa-xmark\"></i> **取消**：放弃消息更改\n\n### 消息操作\n\n- <i class=\"fa-solid fa-copy\"></i> **复制**：消息内容重复\n- <i class=\"fa-solid fa-trash-can\"></i> **删除**：删除消息\n\n### 留言位置\n\n- <i class=\"fa-solid fa-chevron-up\"></i> **向上移动**：在聊天中将消息移至更高位置\n- <i class=\"fa-solid fa-chevron-down\"></i> **下移**：在聊天中将消息移至下方\n\n注意：根据聊天历史记录中的消息位置，移动控制可能会被禁用。\n\n## 聊天选项面板\n\n通过以下方式管理聊天设置和操作 <i class=\"fa-solid fa-bars\"></i> **选项** 左下角的按钮\n聊天界面。\n\n### 显示控制\n\n- <i class=\"fa-lg fa-solid fa-times\"></i> **关闭聊天**：退出当前聊天会话\n- <i class=\"fa-lg fa-solid fa-cog\"></i> **切换面板**：显示/隐藏 [接口面板](/guides/sillytavern/#control-panels)\n\n### 生成设置\n\n- <i class=\"fa-lg fa-solid fa-note-sticky\"></i> **[作者注释](/guides/sillytavern/core-concepts/authors-note/)**：自定义上下文说明\n- <i class=\"fa-lg fa-solid fa-scale-balanced\"></i> **[CFG规模](/guides/sillytavern/prompts/cfg/)**：调整反应创意\n- <i class=\"fa-lg fa-solid fa-pie-chart\"></i> **[代币概率](#token-probabilities-panel)**：查看token生成统计\n\n### 聊天导航\n\n- <i class=\"fa-lg fa-solid fa-left-long\"></i> **返回家长聊天**: 返回主对话\n- <i class=\"fa-lg fa-solid fa-flag\"></i> **保存检查点**：创建故事检查点\n- <i class=\"fa-lg fa-solid fa-people-arrows\"></i> **转换为组**: 转变为 [群聊](/guides/sillytavern/core-concepts/groupchats/)\n\n### 聊天管理\n\n- <i class=\"fa-lg fa-solid fa-comments\"></i> **开始新的聊天**：开始新的对话\n- <i class=\"fa-lg fa-solid fa-address-book\"></i> **管理聊天文件**: [聊天文件操作](/guides/sillytavern/core-concepts/chatfilemanagement/) 例如导入、导出和重命名\n\n### 消息控制\n\n- <i class=\"fa-lg fa-solid fa-trash-can\"></i> **删除消息**：选择并删除多条消息\n- <i class=\"fa-lg fa-solid fa-repeat\"></i> **再生**：创建新响应\n- <i class=\"fa-lg fa-solid fa-user-secret\"></i> **代写**：AI以用户身份写入消息\n- <i class=\"fa-lg fa-solid fa-arrow-right\"></i> **继续生成**：延长最后一条消息\n\n注意：根据上下文和聊天状态，某些选项可能会隐藏。\n\n## 代币概率面板\n\n令牌概率面板可让您查看 AI 文本生成的采样过程。它不仅向你展示人工智能写了什么，还向你展示它在文本中的每一点考虑的其他选项。\n\n要打开它，请单击 <i class=\"fa-solid fa-pie-chart\"></i> **代币概率** 按钮在 <i class=\"fa-solid fa-bars\" title=\"Burger Menu icon\"></i> **聊天选项** 面板。\n\n![消息示例](/docs/sillytavern/static/token-probs/fling-msg.png){宽度=500}\n\n![令牌概率显示示例消息](/docs/sillytavern/static/token-probs/fling-probs.png){宽度=500}\n\n当您单击生成文本中的任何 token（单词、标点符号或格式角色）时，面板会显示 AI 在该位置考虑的替代 token 及其概率分数。这可以让您深入了解人工智能的“思维过程”，并显示响应可能采取的其他方向。查看这些替代方案可以帮助您了解是否有多个可能的选项或一个明确的选择。\n\n![替代 token 和概率](/docs/sillytavern/static/token-probs/fling-probs-logprob.png){宽度=500}\n\n如果您看到 token，您认为 AI 应该做出不同的选择，请选择一个替代方案，该消息将从该点开始重新生成，可能会给您一个不同的响应。\n\n### 重新滚动\n\n如果更改特定的 token 并重新生成响应，则新响应中更改的 token 之前的部分将与原始响应相同。这部分显示为灰色。由于没有生成，因此没有这部分的概率信息。\n\n您可能希望查看基于您的替代 token 生成的其他响应。\n\n您可以单击灰色部分来“重新滚动”生成，从而为您提供文本的新变体。单击灰色部分的任何部分将保留整个灰色部分并重新生成整个白色/有色部分。\n\n按住 Ctrl 键的同时单击灰色部分中的 token 将保留灰色部分直至单击的 token 并重新生成文本的其余部分。在这种情况下，您选择的替代 token 不能保留。\n\n### 控制\n\n**代币展示**:\n\n- 生成的文本被分割成单独的 token\n- 每个 token 都是交互式的，单击 token 查看 AI 考虑的替代方案\n- Token 被着色作为视觉辅助，但这并不表示概率\n- 特殊的角色（空格、换行符）有明显标记\n\n**代币选择**:\n\n- 单击 token 查看替代方案\n- 单击替代项替换 token 并重新生成响应\n- 将鼠标悬停在 token 上即可查看其原始对数概率得分\n\n**窗口控制**:\n\n- <i class=\"fa-solid fa-grip\"></i> 拖动手柄以重新定位面板（仅限MovingUI）\n- <i class=\"fa-solid fa-window-maximize\"></i> 最大化/恢复面板尺寸\n- <i class=\"fa-solid fa-circle-chevron-up\"></i> 展开/折叠面板内容\n- <i class=\"fa-solid fa-circle-xmark\"></i> 关闭面板\n\n### 可用性\n\n您必须选择 **请求 token 概率** 在 [用户设置](/guides/sillytavern/user-settings/#chatmessage-handling) 启用此功能。\n\n令牌概率仅适用于最近的消息，并且不会保存到聊天中。如果 token 概率信息不再可用于消息，面板将显示一条消息来指示这一点。\n\n使用平滑流时，令牌概率不可用。\n\n并非所有 API 都提供令牌概率。如果您使用的 API 不支持 token 概率，面板将打开，但不会显示任何信息。\n\n#### 文本补全\n\n- **骆驼CPP**：可用\n- **文本生成 WebUI** (oobaboga)：可用\n- **虎斑API**：可用\n- **小说人工智能**：可用\n- **狗头人CPP**：可用\n- **奥拉马**: 貌似无法使用\n- **开放路由器文本**: 貌似无法使用\n\n#### 聊天补全\n\n- **开放人工智能** 或 **定制**：可用，但不支持重新滚动\n- **人择**: 貌似无法使用\n- **谷歌人工智能工作室**: 貌似无法使用\n- **开放路由器聊天**: 貌似无法使用\n",
      "searchText": "聊天 当你是 连接到 API，通过在屏幕底部的聊天栏中键入内容向 AI 发送消息。然后点击 发送 或按 Enter 键。 人工智能将回复一条消息，继续对话。 您现在可以： 发送另一条消息 滑动回复：单击 滑动切换回复 消息上的按钮以生成不同的响应。 编辑消息：单击 编辑 任何消息上的按钮 编辑消息内容. 消息操作：单击 消息操作 消息上的按钮了解更多信息 消息选项 喜欢 翻译、图像生成和故事分支。 聊天选项：单击 选项 聊天栏旁边的按钮了解更多信息 聊天选项 比如作者笔记和聊天文件管理。 编辑和滑动切换回复 如果您希望说不同的话，您可以编辑您的消息，然后滑动切换回复 AI 的响应以获得新的消息。 键盘快捷键 您还可以使用 右 方向键指向滑动切换回复，然后 向上 箭头键可编辑聊天中的最后一条消息。如需更多热键，请使用 /help hotkeys 斜线命令 在聊天中或查看 热键 页。 消息操作面板 通过消息上的省略号 (•••) 按钮管理各个聊天消息。 要为聊天中的所有消息显示这些选项，请启用 展开消息操作 在您的用户设置中进行设置。 核心功能 翻译：将消息转换为不同的语言 生成图像: 创建图像 从消息内容来看 叙述: 文字转语音 转换 提示词：查看生成提示词和token的使用情况 消息可见性 包含：AI看到这条消息；单击以排除它 排除：AI看不到这条消息；单击以包含它 内容管理 嵌入: 附加文件或图像 检查站：创建故事检查点 检查站导航：点击打开检查点聊天，Shift+点击更新 现有检查点 分公司：开始替代故事路径 复制：复制消息文本 编辑：编辑消息内容 编辑消息内容 一个紧凑的消息处理工具面板，当您 编辑 聊天 消息。 核心行动 确认：保存消息更改 取消：放弃消息更改 消息操作 复制：消息内容重复 删除：删除消息 留言位置 向上移动：在聊天中将消息移至更高位置 下移：在聊天中将消息移至下方 注意：根据聊天历史记录中的消息位置，移动控制可能会被禁用。 聊天选项面板 通过以下方式管理聊天设置和操作 选项 左下角的按钮 聊天界面。 显示控制 关闭聊天：退出当前聊天会话 切换面板：显示/隐藏 接口面板 生成设置 作者注释：自定义上下文说明 CFG规模：调整反应创意 代币概率：查看token生成统计 聊天导航 返回家长聊天: 返回主对话 保存检查点：创建故事检查点 转换为组: 转变为 群聊 聊天管理 开始新的聊天：开始新的对话 管理聊天文件: 聊天文件操作 例如导入、导出和重命名 消息控制 删除消息：选择并删除多条消息 再生：创建新响应 代写：AI以用户身份写入消息 继续生成：延长最后一条消息 注意：根据上下文和聊天状态，某些选项可能会隐藏。 代币概率面板 令牌概率面板可让您查看 AI 文本生成的采样过程。它不仅向你展示人工智能写了什么，还向你展示它在文本中的每一点考虑的其他选项。 要打开它，请单击 代币概率 按钮在 聊天选项 面板。 {宽度=500} {宽度=500} 当您单击生成文本中的任何 token（单词、标点符号或格式角色）时，面板会显示 AI 在该位置考虑的替代 token 及其概率分数。这可以让您深入了解人工智能的“思维过程”，并显示响应可能采取的其他方向。查看这些替代方案可以帮助您了解是否有多个可能的选项或一个明确的选择。 {宽度=500} 如果您看到 token，您认为 AI 应该做出不同的选择，请选择一个替代方案，该消息将从该点开始重新生成，可能会给您一个不同的响应。 重新滚动 如果更改特定的 token 并重新生成响应，则新响应中更改的 token 之前的部分将与原始响应相同。这部分显示为灰色。由于没有生成，因此没有这部分的概率信息。 您可能希望查看基于您的替代 token 生成的其他响应。 您可以单击灰色部分来“重新滚动”生成，从而为您提供文本的新变体。单击灰色部分的任何部分将保留整个灰色部分并重新生成整个白色/有色部分。 按住 Ctrl 键的同时单击灰色部分中的 token 将保留灰色部分直至单击的 token 并重新生成文本的其余部分。在这种情况下，您选择的替代 token 不能保留。 控制 代币展示: 生成的文本被分割成单独的 token 每个 token 都是交互式的，单击 token 查看 AI 考虑的替代方案 Token 被着色作为视觉辅助，但这并不表示概率 特殊的角色（空格、换行符）有明显标记 代币选择: 单击 token 查看替代方案 单击替代项替换 token 并重新生成响应 将鼠标悬停在 token 上即可查看其原始对数概率得分 窗口控制: 拖动手柄以重新定位面板（仅限MovingUI） 最大化/恢复面板尺寸 展开/折叠面板内容 关闭面板 可用性 您必须选择 请求 token 概率 在 用户设置 启用此功能。 令牌概率仅适用于最近的消息，并且不会保存到聊天中。如果 token 概率信息不再可用于消息，面板将显示一条消息来指示这一点。 使用平滑流时，令牌概率不可用。 并非所有 API 都提供令牌概率。如果您使用的 API 不支持 token 概率，面板将打开，但不会显示任何信息。 文本补全 骆驼CPP：可用 文本生成 WebUI (oobaboga)：可用 虎斑API：可用 小说人工智能：可用 狗头人CPP：可用 奥拉马: 貌似无法使用 开放路由器文本: 貌似无法使用 聊天补全 开放人工智能 或 定制：可用，但不支持重新滚动 人择: 貌似无法使用 谷歌人工智能工作室: 貌似无法使用 开放路由器聊天: 貌似无法使用",
      "translationStatus": "machine-draft"
    },
    {
      "slug": "core-concepts/slashcommands",
      "title": "斜杠命令",
      "group": "Chatting",
      "order": 0,
      "source": "Usage/Chatting/slashcommands.md",
      "sourceUrl": "https://docs.sillytavern.app/usage/core-concepts/slashcommands/",
      "sourceSha256": "6d118635ad1a0a76ce62d8fb324784333d875f712c445be103cf443c8b566c14",
      "headings": [
        {
          "id": "slash-commands",
          "depth": 1,
          "title": "斜杠命令"
        }
      ],
      "content": "# 斜杠命令\n\n> **这不是一个详尽的列表，因为它很少更新。**\n>\n> 有关可在您的实例中使用的最新命令列表，请使用 `/help slash` 任何 SillyTavern 聊天中的聊天命令。\n\n- `/help` – 显示帮助消息\n- `/api` - 切换到不同的API\n- `/sys` - 作为系统叙述者发送中立消息\n- `/send` - 作为用户发送消息而不触发生成\n- `/sendas` – 以特定的角色形式发送消息\n- `/comment` - 在聊天中添加人工智能看不到的评论\n- `/impersonate` - 使用可选的提示词让人工智能像你一样写作\n- `/persona` - 设置您的用户用户人设\n- `/imagine` - 从文本提示词生成图像\n- `/bg` - 按文件名设置背景图像\n",
      "searchText": "斜杠命令 这不是一个详尽的列表，因为它很少更新。 有关可在您的实例中使用的最新命令列表，请使用 /help slash 任何 SillyTavern 聊天中的聊天命令。 /help – 显示帮助消息 /api - 切换到不同的API /sys - 作为系统叙述者发送中立消息 /send - 作为用户发送消息而不触发生成 /sendas – 以特定的角色形式发送消息 /comment - 在聊天中添加人工智能看不到的评论 /impersonate - 使用可选的提示词让人工智能像你一样写作 /persona - 设置您的用户用户人设 /imagine - 从文本提示词生成图像 /bg - 按文件名设置背景图像",
      "translationStatus": "machine-draft"
    },
    {
      "slug": "hotkeys",
      "title": "快捷键",
      "group": "Chatting",
      "order": -60,
      "source": "Usage/Chatting/hotkeys.md",
      "sourceUrl": "https://docs.sillytavern.app/usage/hotkeys/",
      "sourceSha256": "52538a7e20679790f0027edeb5e7c603b0de8fc48df6b61b699549e271a47f81",
      "headings": [
        {
          "id": "hotkeys",
          "depth": 1,
          "title": "快捷键"
        },
        {
          "id": "chat-hotkeys",
          "depth": 2,
          "title": "聊天热键"
        },
        {
          "id": "markdown-hotkeys",
          "depth": 2,
          "title": "Markdown 热键"
        }
      ],
      "content": "# 快捷键\n\n**有关可在 SillyTavern 实例中使用的最新热键列表，请使用 `/help hotkeys` 任何聊天中的斜杠命令。**\n\n**移动设备禁用热键。**\n\n## 聊天热键\n\n- 向上 = 编辑聊天中的最后一条消息\n- Ctrl+Up = 编辑聊天中的最后一条用户消息\n- 左 = 滑动切换回复左\n- 右 = 滑动切换回复右（注意：当聊天栏中输入内容时，滑动切换回复热键将被禁用）\n- 输入（选择聊天栏）= 将您的消息发送给 AI\n- Ctrl+Enter = 重新生成最后的 AI 响应\n- Alt+Enter = 继续上次 AI 响应\n- 逃亡\n  - *（编辑消息且启用消息编辑自动保存时）* = 关闭编辑框。\n  - *（当人工智能消息正在生成或流式传输时）* = 立即停止生成。\n\n## Markdown 热键\n\n需要在“用户设置”选项卡下启用。适用于标有“M↓”图标的聊天栏和文本区域：\n\n- Ctrl+B = \\*\\*粗体\\*\\*\n- Ctrl+I = \\*斜体\\*\n- Ctrl+U = \\_\\_下划线\\_\\_\n- Ctrl+K = \\`内联代码\\`\n- Ctrl+Shift+\\~ = \\~\\~删除线\\~\\~\n",
      "searchText": "快捷键 有关可在 SillyTavern 实例中使用的最新热键列表，请使用 /help hotkeys 任何聊天中的斜杠命令。 移动设备禁用热键。 聊天热键 向上 = 编辑聊天中的最后一条消息 Ctrl+Up = 编辑聊天中的最后一条用户消息 左 = 滑动切换回复左 右 = 滑动切换回复右（注意：当聊天栏中输入内容时，滑动切换回复热键将被禁用） 输入（选择聊天栏）= 将您的消息发送给 AI Ctrl+Enter = 重新生成最后的 AI 响应 Alt+Enter = 继续上次 AI 响应 逃亡 （编辑消息且启用消息编辑自动保存时） = 关闭编辑框。 （当人工智能消息正在生成或流式传输时） = 立即停止生成。 Markdown 热键 需要在“用户设置”选项卡下启用。适用于标有“M↓”图标的聊天栏和文本区域： Ctrl+B = **粗体** Ctrl+I = *斜体* Ctrl+U = __下划线__ Ctrl+K = `内联代码` Ctrl+Shift+~ = ~~删除线~~",
      "translationStatus": "machine-draft"
    },
    {
      "slug": "api-connections",
      "title": "API 连接",
      "group": "API_Connections",
      "order": 150,
      "source": "Usage/API_Connections/index.md",
      "sourceUrl": "https://docs.sillytavern.app/usage/api-connections/",
      "sourceSha256": "340efcbf7a0a9d901b0fb3648240a5002195006f4b1025021700a33d14cac0f6",
      "headings": [
        {
          "id": "api-connections",
          "depth": 1,
          "title": "API 连接"
        },
        {
          "id": "eli5-chat-completions-vs-text-completions",
          "depth": 2,
          "title": "ELI5：聊天完成与文本完成"
        },
        {
          "id": "chat-completions",
          "depth": 3,
          "title": "聊天完成"
        },
        {
          "id": "text-completions-aka-just-completions",
          "depth": 3,
          "title": "文本完成（又名“完成”）"
        },
        {
          "id": "local-apis",
          "depth": 2,
          "title": "本地API"
        },
        {
          "id": "koboldcpp",
          "depth": 3,
          "title": "狗头人Cpp"
        },
        {
          "id": "llamacpp",
          "depth": 3,
          "title": "骆驼.cpp"
        },
        {
          "id": "ollama",
          "depth": 3,
          "title": "奥拉马"
        },
        {
          "id": "oobabooga-textgeneration-webui",
          "depth": 3,
          "title": "Oobabooga TextGeneration WebUI"
        },
        {
          "id": "tabbyapi",
          "depth": 3,
          "title": "虎斑API"
        },
        {
          "id": "koboldai-classic-deprecated-abandoned",
          "depth": 3,
          "title": "KoboldAI Classic（已弃用、废弃）"
        },
        {
          "id": "cloud-llm-apis",
          "depth": 2,
          "title": "云 LLM API"
        },
        {
          "id": "ai-horde",
          "depth": 3,
          "title": "AI Horde"
        },
        {
          "id": "openai-chatgpt",
          "depth": 3,
          "title": "OpenAI (ChatGPT)"
        },
        {
          "id": "claude-by-anthropic",
          "depth": 3,
          "title": "克劳德（人类）"
        },
        {
          "id": "google-ai-studio-and-vertex-ai",
          "depth": 3,
          "title": "Google AI Studio 和 Vertex AI"
        },
        {
          "id": "mistral-by-mistral-ai",
          "depth": 3,
          "title": "米斯特拉尔（由米斯特拉尔 AI 提供）"
        },
        {
          "id": "openrouter",
          "depth": 3,
          "title": "开放路由器"
        },
        {
          "id": "deepseek",
          "depth": 3,
          "title": "深度搜索"
        },
        {
          "id": "ai21",
          "depth": 3,
          "title": "人工智能21"
        },
        {
          "id": "cohere",
          "depth": 3,
          "title": "连贯"
        },
        {
          "id": "perplexity",
          "depth": 3,
          "title": "困惑"
        },
        {
          "id": "mancer-ai",
          "depth": 3,
          "title": "曼瑟人工智能"
        },
        {
          "id": "dreamgen",
          "depth": 3,
          "title": "梦创"
        },
        {
          "id": "pollinations",
          "depth": 3,
          "title": "授粉"
        },
        {
          "id": "novelai",
          "depth": 3,
          "title": "小说人工智能"
        },
        {
          "id": "electron-hub",
          "depth": 3,
          "title": "电子集线器"
        },
        {
          "id": "aiml-api",
          "depth": 3,
          "title": "人工智能/机器学习API"
        }
      ],
      "content": "# API 连接\n\nSillyTavern可以连接到广泛的LLM API。\n以下是它们各自的优点、缺点和用例的描述。\n\n## ELI5：聊天完成与文本完成\n\n当您第一次导航到 ST 中的“API 连接”页面时，您会注意到一个下拉选项，可在使用术语（例如“聊天补全”和“文本补全”）的选项之间进行选择。理解这意味着什么是有帮助的。\n\n事实并非如此：人们很容易将“文本补全”视为本地模型，将“聊天补全”视为基于云的法学硕士，但事实并非如此。也不是例如“NovelAI”或“Kobold”实际上是一种单独的模型类型，尽管它们是 ST 中 API 下拉列表中的单独选项。您可以使用适当的后端将模型强制转换为不同的 API 结构，但这不是本节的重点。\n\n当您使用 ST 发送消息时，您的聊天、角色描述和其他提示词（例如传说或作者笔记）将被构造成单个“提示词”以发送到模型。您正在使用的模型的 API“类型”决定了这个提示词的构建方式（ST 在后台自动为您处理的事情 - 您可以打开 ST 终端并准确查看发送到 AI 的提示词的样子）。\n\n### 聊天完成\n\n顾名思义，聊天补全模型会将您的提示词构建为用户（您）和助手（AI）或系统（中立）之间的一系列消息。针对聊天补全训练的模型有助于营造“聊天”的感觉，人工智能“响应”最后一条消息。当您使用 ChatGPT 网站时，您正在后台处理聊天完成 API。\n\n### 文本完成（又名“完成”）\n\n另一方面，文本补全，正如其名称所暗示的，会将您的提示词转换为一个长字符串，并且模型将简单地尝试继续此操作（就像，从字面上想象您的所有文本、数百条消息、所有格式、换行符等都被压缩成一个很长的句子）。\n\n如果 ST 中的消息碰巧被格式化为 YourPersona: 和角色: 之间的一系列消息，则文本补全模型将尝试继续此模式，ST 会将其呈现为新的聊天消息，但实际上该模型只是尝试继续文本。如果您输入“太阳升起”，文本完成模型可能会用“东方”为您完成该消息。\n\n大多数文本补全模型都有一个推荐的“指令模板”（通常在模型的文档或下载页面中提到），可以帮助它们“响应”消息和指令，就像聊天补全模型一样。 ST 通常在“高级格式”页面中提供大多数（如果不是全部）教学模板供您选择。\n\n## 本地API\n\n- 这些 LLM API 可以在您的 PC 上运行。\n- 它们可以免费使用并且没有内容过滤器。\n- 安装过程可能很复杂（**SillyTavern 开发团队不提供对此的支持**).\n- 需要单独下载 LLM 模型 [抱脸](https://huggingface.co/models?other=LLM) 每个可以是 5-50GB。\n- 大多数模型不如云 LLM API 强大。\n\n### 狗头人Cpp\n\n- 易于使用的 API，具有 CPU 卸载（对低 VRAM 用户有帮助）和流媒体\n- 在 Windows、Mac 和 Linux 上从单个二进制文件运行\n- 支持GGUF模型\n- 比仅使用 GPU 的加载器（例如 AutoGPTQ 和 Exllama/v2）慢\n- [GitHub](https://github.com/LostRuins/koboldcpp), [设置说明](/guides/sillytavern/api-connections/koboldcpp/)\n\n### 骆驼.cpp\n\n- KoboldCpp 和 Ollama 分叉的原始来源\n- 提供预编译的二进制文件和从源代码编译的选项\n- 支持GGUF模型\n- llama-server 的轻量级 CLI 界面\n- [GitHub](https://github.com/ggml-org/llama.cpp)\n\n### 奥拉马\n\n- 最容易设置和使用所有基于 llama.cpp 的 API\n- 一个俏皮的 [目录](https://ollama.com/library) 可供一键下载的模型\n- 支持以 Ollama 自己的格式包装的 GGUF 模型\n- [GitHub](https://github.com/ollama/ollama), [网站](https://ollama.com/)\n\n### Oobabooga TextGeneration WebUI\n\n- 带流媒体功能的一体化 Gradio UI\n- 对量化（AWQ、Exl2、GGML、GGUF、GPTQ）和 FP16 模型的最广泛支持\n- 提供一键安装程序\n- 定期更新，有时会破坏与 SillyTavern 的兼容性\n- [GitHub](https://github.com/oobabooga/text-generation-webui#one-click-installers)\n\n**将 SillyTavern 连接到 Ooba 新 OpenAI API 的正确方法：**\n\n1. 确保您使用的是 Oobabooga TextGen 的最新更新（截至 2023 年 11 月 14 日）。\n2. 编辑 CMD_FLAGS.txt 文件，并添加 `--api` 那里有旗帜。然后重新启动 Ooba 的服务器。\n3. 将 ST 连接至 `http://localhost:5000/` （默认情况下），无需选中“旧版 API”框。您可以删除 `/v1` postfix 来自 Ooba 控制台为您提供的 URL。\n\n*您可以使用以下命令更改 API 托管端口 `--api-port 5001` flag，其中 5001 是您的自定义端口。*\n\n### 虎斑API\n\n- 轻量级 [埃拉马夫2](https://github.com/turboderp/exllamav2)基于 API 的流式传输\n- 支持 Exl2、GPTQ 和 FP16 型号\n- [官方延期](https://github.com/theroyallab/ST-tabbyAPI-loader) 允许直接从 SillyTavern 加载/卸载模型\n- 不建议 VRAM 较低的用户使用（无 CPU 卸载）\n- [GitHub](https://github.com/theroyallab/tabbyAPI), [设置说明](/guides/sillytavern/api-connections/tabbyapi/)\n\n### KoboldAI Classic（已弃用、废弃）\n\n- 在您的 PC 上运行，100% 私有，提供多种型号\n- 提供对 AI 生成设置的最直接控制\n- GPU 中需要大量 VRAM（6-24GB，取决于 LLM 模型）\n- 模型仅限于 2k 上下文\n- 没有流媒体\n- 流行的 KoboldAI 版本：\n  - [亨基联队](https://github.com/henk717/KoboldAI)\n  - [0cc4m 的 4bit 支持 United](https://github.com/0cc4m/KoboldAI)\n\n## 云 LLM API\n\n- 这些 LLM API 作为云服务运行，不需要您的 PC 上的资源\n- 他们比大多数本地法学硕士更强大/更聪明\n- 不过，它们都有不同程度的内容过滤，而且大多需要付费\n\n### AI Horde\n\n- SillyTavern 可以直接访问此 API，无需额外设置\n- 使用个体志愿者（部落工人）的 GPU 来处理您的聊天输入的响应\n- 在生成等待时间、AI 设置和可用模型方面受 Worker 支配\n- [网站](https://aihorde.net/), [设置说明](/guides/sillytavern/api-connections/horde/)\n\n### OpenAI (ChatGPT)\n\n- 易于设置和获取 API 密钥\n- 需要按提示词预付学分和费用\n- 非常合乎逻辑。创意风格可以重复且可预测\n- 大多数较新的型号（gpt-4-turbo、gpt-4o）支持多模态\n- [网站](https://platform.openai.com/), [设置说明](/guides/sillytavern/api-connections/openai/#openai)\n\n### 克劳德（人类）\n\n- 推荐给希望 AI 聊天具有创意、独特写作风格的用户\n- 需要按提示词预付学分和费用\n- 最新型号（Claude 3）支持多模态\n- 需要特定的提示风格和利用 [预填充物](https://docs.anthropic.com/en/docs/build-with-claude/prompt-engineering/prefill-claudes-response) 用于回复引导\n- [网站](https://console.anthropic.com/), [设置说明](/guides/sillytavern/api-connections/openai/#claude)\n\n### Google AI Studio 和 Vertex AI\n\n- 具有具有速率限制的免费套餐（Gemini Flash），可能需要账单信息\n- [人工智能工作室](https://aistudio.google.com/) 通常具有最新的型号和功能\n- [顶点人工智能](https://console.cloud.google.com/vertex-ai/studio) 设置起来比较棘手，但更稳定\n- [设置说明](/guides/sillytavern/api-connections/google/)\n\n### 米斯特拉尔（由米斯特拉尔 AI 提供）\n\n- 各种尺寸和用例的高效模型。您可以在以下位置创建帐户和 API 密钥 [他们的平台](https://console.mistral.ai/api-keys/).\n- 一般用途的上下文大小为 32k 到 128k，编码的上下文大小为 32k 到 256k。\n- 有速率限制的免费套餐。\n- 合理节制，米斯特拉尔的主要原则是保持中立并赋予用户权力，更多信息 [这里](https://mistral.ai/terms/).\n- [网站](https://console.mistral.ai/), [设置说明](/guides/sillytavern/api-connections/openai/#mistral-ai)\n\n### 开放路由器\n\n- 提供统一的API来访问市场上所有主要的法学硕士\n- 按 token 信用系统付费，以及每日请求有限的免费模型\n- 除非 LLM 供应商要求，否则不强制审核\n- [网站](https://openrouter.ai), [设置说明](/guides/sillytavern/api-connections/openrouter/)\n\n### 深度搜索\n\n- 提供对非常流行的 DeepSeek V3 最新版本的访问（`deepseek-chat`）和 DeepSeek R1（`deepseek-reasoner`) 型号\n- 需要支付积分（最低 2 美元），但这些模型的质量相当便宜\n- 对 API 没有审核，但模型可能会拒绝某些提示词\n- [网站](https://platform.deepseek.com/), [设置说明](/guides/sillytavern/api-connections/openai/#deepseek)\n\n### 人工智能21\n\n- 提供对 Jamba 系列开放模型的访问\n- 免费试用（三个月 10 美元），然后需要按 token 每月付费\n- [网站](https://ai21.com/), [设置说明](/guides/sillytavern/api-connections/openai/#ai21)\n\n### 连贯\n\n- 提供对 Cohere 最新模型的访问（command-r、command-a、c4ai-aya 等）\n- 有免费套餐（试用密钥），具有足够的速率限制供休闲使用\n- [网站](https://cohere.com/), [设置说明](/guides/sillytavern/api-connections/openai/#cohere)\n\n### 困惑\n\n- 通过 API 提供对独特的 Perplexity Sonar 在线模型的访问\n- 需要配置计费并购买积分\n- [网站](https://perplexity.ai/), [设置说明](/guides/sillytavern/api-connections/openai/#perplexity)\n\n### 曼瑟人工智能\n\n- 承载各种家庭无约束模型的服务\n- 使用“积分”支付各种型号的 token\n- 默认情况下不记录提示词，但您可以启用它以获得 token 的信用折扣。\n- 使用类似于以下的 API `Oobabooga TextGeneration WebUI`，参见 [曼瑟文档](https://mancer.tech/docs/clients/#sampling-parameters) 了解详情。\n- [网站](https://mancer.tech/), [设置说明](/guides/sillytavern/api-connections/mancer/)\n\n### 梦创\n\n- 未经审查的模型针对可引导的创意写作进行了调整\n- 每月免费积分以及付费订阅\n- 型号范围从7B到70B\n- [设置说明](/guides/sillytavern/api-connections/dreamgen/)\n\n### 授粉\n\n- 无需设置，开箱即可使用\n- 免费提供多种模型的访问\n- 输出有时可能包含带有第三方服务链接的广告\n\n### 小说人工智能\n\n- 无内容过滤器，最新型号基于Llama 3\n- 需要付费订阅，层级决定最大上下文长度\n- [网站](https://novelai.net/), [设置说明](/guides/sillytavern/api-connections/novelai/)\n\n### 电子集线器\n\n- 一个 API 密钥可解锁多个供应商（OpenAI、Anthropic、DeepSeek 等）的模型，用于生成文本和图像\n- 每天 0.25 美元的免费积分，提供付费计划\n- [网站](https://www.electronhub.ai/), [设置说明](/guides/sillytavern/api-connections/openai/#electron-hub)\n\n### 人工智能/机器学习API\n\n- 适用于 300 多个模型的统一 API，包括 Claude、GPT-4o、Gemini、LLaMA 3、Mistral 等\n- 拥有带有费率限制、订阅计划和即用即付选项的免费套餐\n- [网站](https://aimlapi.com), [文档](https://docs.aimlapi.com), [型号](https://aimlapi.com/models)\n",
      "searchText": "API 连接 SillyTavern可以连接到广泛的LLM API。 以下是它们各自的优点、缺点和用例的描述。 ELI5：聊天完成与文本完成 当您第一次导航到 ST 中的“API 连接”页面时，您会注意到一个下拉选项，可在使用术语（例如“聊天补全”和“文本补全”）的选项之间进行选择。理解这意味着什么是有帮助的。 事实并非如此：人们很容易将“文本补全”视为本地模型，将“聊天补全”视为基于云的法学硕士，但事实并非如此。也不是例如“NovelAI”或“Kobold”实际上是一种单独的模型类型，尽管它们是 ST 中 API 下拉列表中的单独选项。您可以使用适当的后端将模型强制转换为不同的 API 结构，但这不是本节的重点。 当您使用 ST 发送消息时，您的聊天、角色描述和其他提示词（例如传说或作者笔记）将被构造成单个“提示词”以发送到模型。您正在使用的模型的 API“类型”决定了这个提示词的构建方式（ST 在后台自动为您处理的事情 - 您可以打开 ST 终端并准确查看发送到 AI 的提示词的样子）。 聊天完成 顾名思义，聊天补全模型会将您的提示词构建为用户（您）和助手（AI）或系统（中立）之间的一系列消息。针对聊天补全训练的模型有助于营造“聊天”的感觉，人工智能“响应”最后一条消息。当您使用 ChatGPT 网站时，您正在后台处理聊天完成 API。 文本完成（又名“完成”） 另一方面，文本补全，正如其名称所暗示的，会将您的提示词转换为一个长字符串，并且模型将简单地尝试继续此操作（就像，从字面上想象您的所有文本、数百条消息、所有格式、换行符等都被压缩成一个很长的句子）。 如果 ST 中的消息碰巧被格式化为 YourPersona: 和角色: 之间的一系列消息，则文本补全模型将尝试继续此模式，ST 会将其呈现为新的聊天消息，但实际上该模型只是尝试继续文本。如果您输入“太阳升起”，文本完成模型可能会用“东方”为您完成该消息。 大多数文本补全模型都有一个推荐的“指令模板”（通常在模型的文档或下载页面中提到），可以帮助它们“响应”消息和指令，就像聊天补全模型一样。 ST 通常在“高级格式”页面中提供大多数（如果不是全部）教学模板供您选择。 本地API 这些 LLM API 可以在您的 PC 上运行。 它们可以免费使用并且没有内容过滤器。 安装过程可能很复杂（SillyTavern 开发团队不提供对此的支持). 需要单独下载 LLM 模型 抱脸 每个可以是 5-50GB。 大多数模型不如云 LLM API 强大。 狗头人Cpp 易于使用的 API，具有 CPU 卸载（对低 VRAM 用户有帮助）和流媒体 在 Windows、Mac 和 Linux 上从单个二进制文件运行 支持GGUF模型 比仅使用 GPU 的加载器（例如 AutoGPTQ 和 Exllama/v2）慢 GitHub, 设置说明 骆驼.cpp KoboldCpp 和 Ollama 分叉的原始来源 提供预编译的二进制文件和从源代码编译的选项 支持GGUF模型 llama-server 的轻量级 CLI 界面 GitHub 奥拉马 最容易设置和使用所有基于 llama.cpp 的 API 一个俏皮的 目录 可供一键下载的模型 支持以 Ollama 自己的格式包装的 GGUF 模型 GitHub, 网站 Oobabooga TextGeneration WebUI 带流媒体功能的一体化 Gradio UI 对量化（AWQ、Exl2、GGML、GGUF、GPTQ）和 FP16 模型的最广泛支持 提供一键安装程序 定期更新，有时会破坏与 SillyTavern 的兼容性 GitHub 将 SillyTavern 连接到 Ooba 新 OpenAI API 的正确方法： 确保您使用的是 Oobabooga TextGen 的最新更新（截至 2023 年 11 月 14 日）。 编辑 CMD_FLAGS.txt 文件，并添加 --api 那里有旗帜。然后重新启动 Ooba 的服务器。 将 ST 连接至 http://localhost:5000/ （默认情况下），无需选中“旧版 API”框。您可以删除 /v1 postfix 来自 Ooba 控制台为您提供的 URL。 您可以使用以下命令更改 API 托管端口 --api-port 5001 flag，其中 5001 是您的自定义端口。 虎斑API 轻量级 埃拉马夫2基于 API 的流式传输 支持 Exl2、GPTQ 和 FP16 型号 官方延期 允许直接从 SillyTavern 加载/卸载模型 不建议 VRAM 较低的用户使用（无 CPU 卸载） GitHub, 设置说明 KoboldAI Classic（已弃用、废弃） 在您的 PC 上运行，100% 私有，提供多种型号 提供对 AI 生成设置的最直接控制 GPU 中需要大量 VRAM（6-24GB，取决于 LLM 模型） 模型仅限于 2k 上下文 没有流媒体 流行的 KoboldAI 版本： 亨基联队 0cc4m 的 4bit 支持 United 云 LLM API 这些 LLM API 作为云服务运行，不需要您的 PC 上的资源 他们比大多数本地法学硕士更强大/更聪明 不过，它们都有不同程度的内容过滤，而且大多需要付费 AI Horde SillyTavern 可以直接访问此 API，无需额外设置 使用个体志愿者（部落工人）的 GPU 来处理您的聊天输入的响应 在生成等待时间、AI 设置和可用模型方面受 Worker 支配 网站, 设置说明 OpenAI (ChatGPT) 易于设置和获取 API 密钥 需要按提示词预付学分和费用 非常合乎逻辑。创意风格可以重复且可预测 大多数较新的型号（gpt-4-turbo、gpt-4o）支持多模态 网站, 设置说明 克劳德（人类） 推荐给希望 AI 聊天具有创意、独特写作风格的用户 需要按提示词预付学分和费用 最新型号（Claude 3）支持多模态 需要特定的提示风格和利用 预填充物 用于回复引导 网站, 设置说明 Google AI Studio 和 Vertex AI 具有具有速率限制的免费套餐（Gemini Flash），可能需要账单信息 人工智能工作室 通常具有最新的型号和功能 顶点人工智能 设置起来比较棘手，但更稳定 设置说明 米斯特拉尔（由米斯特拉尔 AI 提供） 各种尺寸和用例的高效模型。您可以在以下位置创建帐户和 API 密钥 他们的平台. 一般用途的上下文大小为 32k 到 128k，编码的上下文大小为 32k 到 256k。 有速率限制的免费套餐。 合理节制，米斯特拉尔的主要原则是保持中立并赋予用户权力，更多信息 这里. 网站, 设置说明 开放路由器 提供统一的API来访问市场上所有主要的法学硕士 按 token 信用系统付费，以及每日请求有限的免费模型 除非 LLM 供应商要求，否则不强制审核 网站, 设置说明 深度搜索 提供对非常流行的 DeepSeek V3 最新版本的访问（deepseek-chat）和 DeepSeek R1（deepseek-reasoner) 型号 需要支付积分（最低 2 美元），但这些模型的质量相当便宜 对 API 没有审核，但模型可能会拒绝某些提示词 网站, 设置说明 人工智能21 提供对 Jamba 系列开放模型的访问 免费试用（三个月 10 美元），然后需要按 token 每月付费 网站, 设置说明 连贯 提供对 Cohere 最新模型的访问（command-r、command-a、c4ai-aya 等） 有免费套餐（试用密钥），具有足够的速率限制供休闲使用 网站, 设置说明 困惑 通过 API 提供对独特的 Perplexity Sonar 在线模型的访问 需要配置计费并购买积分 网站, 设置说明 曼瑟人工智能 承载各种家庭无约束模型的服务 使用“积分”支付各种型号的 token 默认情况下不记录提示词，但您可以启用它以获得 token 的信用折扣。 使用类似于以下的 API Oobabooga TextGeneration WebUI，参见 曼瑟文档 了解详情。 网站, 设置说明 梦创 未经审查的模型针对可引导的创意写作进行了调整 每月免费积分以及付费订阅 型号范围从7B到70B 设置说明 授粉 无需设置，开箱即可使用 免费提供多种模型的访问 输出有时可能包含带有第三方服务链接的广告 小说人工智能 无内容过滤器，最新型号基于Llama 3 需要付费订阅，层级决定最大上下文长度 网站, 设置说明 电子集线器 一个 API 密钥可解锁多个供应商（OpenAI、Anthropic、DeepSeek 等）的模型，用于生成文本和图像 每天 0.25 美元的免费积分，提供付费计划 网站, 设置说明 人工智能/机器学习API 适用于 300 多个模型的统一 API，包括 Claude、GPT-4o、Gemini、LLaMA 3、Mistral 等 拥有带有费率限制、订阅计划和即用即付选项的免费套餐 网站, 文档, 型号",
      "translationStatus": "machine-draft"
    },
    {
      "slug": "core-concepts/connection-profiles",
      "title": "连接配置档案",
      "group": "API_Connections",
      "order": 100,
      "source": "Usage/API_Connections/Connection-Profiles.md",
      "sourceUrl": "https://docs.sillytavern.app/usage/core-concepts/connection-profiles/",
      "sourceSha256": "786a2217dde9239c4bc68e7abeb72642cfd824a7321c72207ccff1fa6d82071f",
      "headings": [
        {
          "id": "connection-profiles",
          "depth": 1,
          "title": "连接配置档案"
        },
        {
          "id": "accessing-connection-profiles",
          "depth": 2,
          "title": "访问连接配置文件"
        },
        {
          "id": "what-is-saved",
          "depth": 2,
          "title": "保存了什么"
        },
        {
          "id": "common",
          "depth": 3,
          "title": "常见"
        },
        {
          "id": "text-completion-apis",
          "depth": 3,
          "title": "文本补全 API"
        },
        {
          "id": "chat-completion-apis",
          "depth": 3,
          "title": "聊天补全 API"
        },
        {
          "id": "managing-connection-profiles",
          "depth": 2,
          "title": "管理连接配置文件"
        },
        {
          "id": "slash-commands",
          "depth": 2,
          "title": "斜线命令"
        }
      ],
      "content": "# 连接配置档案\n\n保存连接配置文件以在不同的 API、模型和格式模板之间快速切换。当您主动使用多个 API 连接或需要在不同配置之间切换而无需浏览菜单时，这非常有用。\n\n## 访问连接配置文件\n\n从 SillyTavern 1.12.6 或更高版本开始，此功能作为内置扩展默认启用，并可在 API 连接菜单中使用。如果您愿意 *禁用* 打开“扩展”面板，单击“管理扩展”，在列表中找到“连接配置文件”，取消选中“已启用”复选框，然后单击“关闭”。\n\n## 保存了什么\n\n连接配置文件存储以下选择。\n\n### 常见\n\n- [API 类型、型号和服务器 URL](/guides/sillytavern/api-connections/)\n- [秘密钥匙](/guides/sillytavern/faq/#where-are-my-api-keys-stored-why-cant-i-see-them)\n- [设置预设](/guides/sillytavern/common-settings/)\n- [开始回复](/guides/sillytavern/core-concepts/advancedformatting/#start-reply-with) （可以显式为空）\n- [自定义停止字符串](/guides/sillytavern/core-concepts/advancedformatting/#custom-stopping-strings) （可以显式为空）\n- [推理格式化](/guides/sillytavern/prompts/reasoning/#configuration)\n\n### 文本补全 API\n\n- [系统提示词及其状态](/guides/sillytavern/core-concepts/advancedformatting/#system-prompt)\n- [指示模式状态和模板](/guides/sillytavern/core-concepts/instructmode/)\n- [上下文模板](/guides/sillytavern/core-concepts/advancedformatting/#context-template)\n- [分词器](/guides/sillytavern/core-concepts/advancedformatting/#tokenizer)\n\n### 聊天补全 API\n\n- [提示词后处理](/guides/sillytavern/api-connections/openai/#prompt-post-processing)\n- 代理预设\n\n## 管理连接配置文件\n\n> **注意事项**\n>\n> 配置文件仅保存下拉字段中的选择，而不了解有关基础设置的任何信息。这意味着您将通过切换到不同的配置文件而丢失未保存的更改。为了防止这种情况发生，如果您不想丢失临时更改，请确保更新所有预设和模板。\n\n- 要保存配置文件，请设置所有必需的设置，然后单击“创建”按钮。然后检查设置并提供配置文件的名称。 **名称应该是唯一的。**\n- 要查看有关所选配置文件的详细信息，请单击“信息”按钮。再次单击可隐藏详细信息。\n- 连接配置文件设置保存到 `settings.json` 在按下“更新”按钮之前，不会更改关联的配置文件保存文件。这意味着，如果您设置了一个配置文件，但随后切换到另一个配置文件而不更新，您将丢失之前的所有更改。\n- 要从保存的配置文件恢复更改的选择，请单击“重新加载”按钮。\n- 要删除配置文件，请单击“删除”按钮并确认删除。 **此操作是不可逆转的。**\n\n## 斜线命令\n\n可以使用以下斜杠命令管理连接配置文件。\n\n1. `/profile [name]` - 如果提供了参数，则切换到配置文件；如果没有，则获取当前配置文件的名称。\n2. `/profile-create [name]` - 使用提供的名称将当前设置保存为新配置文件。\n3. `/profile-list` - 返回可用配置文件名称的 JSON 序列化数组。\n4. `/profile-get [name]` - 获取配置文件的详细信息，并将提供的名称作为 JSON 序列化对象。\n5. `/profile-update` - 使用当前设置更新选定的配置文件。\n",
      "searchText": "连接配置档案 保存连接配置文件以在不同的 API、模型和格式模板之间快速切换。当您主动使用多个 API 连接或需要在不同配置之间切换而无需浏览菜单时，这非常有用。 访问连接配置文件 从 SillyTavern 1.12.6 或更高版本开始，此功能作为内置扩展默认启用，并可在 API 连接菜单中使用。如果您愿意 禁用 打开“扩展”面板，单击“管理扩展”，在列表中找到“连接配置文件”，取消选中“已启用”复选框，然后单击“关闭”。 保存了什么 连接配置文件存储以下选择。 常见 API 类型、型号和服务器 URL 秘密钥匙 设置预设 开始回复 （可以显式为空） 自定义停止字符串 （可以显式为空） 推理格式化 文本补全 API 系统提示词及其状态 指示模式状态和模板 上下文模板 分词器 聊天补全 API 提示词后处理 代理预设 管理连接配置文件 注意事项 配置文件仅保存下拉字段中的选择，而不了解有关基础设置的任何信息。这意味着您将通过切换到不同的配置文件而丢失未保存的更改。为了防止这种情况发生，如果您不想丢失临时更改，请确保更新所有预设和模板。 要保存配置文件，请设置所有必需的设置，然后单击“创建”按钮。然后检查设置并提供配置文件的名称。 名称应该是唯一的。 要查看有关所选配置文件的详细信息，请单击“信息”按钮。再次单击可隐藏详细信息。 连接配置文件设置保存到 settings.json 在按下“更新”按钮之前，不会更改关联的配置文件保存文件。这意味着，如果您设置了一个配置文件，但随后切换到另一个配置文件而不更新，您将丢失之前的所有更改。 要从保存的配置文件恢复更改的选择，请单击“重新加载”按钮。 要删除配置文件，请单击“删除”按钮并确认删除。 此操作是不可逆转的。 斜线命令 可以使用以下斜杠命令管理连接配置文件。 /profile [name] - 如果提供了参数，则切换到配置文件；如果没有，则获取当前配置文件的名称。 /profile-create [name] - 使用提供的名称将当前设置保存为新配置文件。 /profile-list - 返回可用配置文件名称的 JSON 序列化数组。 /profile-get [name] - 获取配置文件的详细信息，并将提供的名称作为 JSON 序列化对象。 /profile-update - 使用当前设置更新选定的配置文件。",
      "translationStatus": "machine-draft"
    },
    {
      "slug": "how-to-use-a-self-hosted-model",
      "title": "使用自托管模型",
      "group": "API_Connections",
      "order": 90,
      "source": "Usage/API_Connections/self-hosted.md",
      "sourceUrl": "https://docs.sillytavern.app/usage/how-to-use-a-self-hosted-model/",
      "sourceSha256": "76b075f7d631a36e21deea3553a73ad19de7285b76d7f1bec58038dee7e722b9",
      "headings": [
        {
          "id": "self-hosted-ai-models",
          "depth": 1,
          "title": "使用自托管模型"
        },
        {
          "id": "intro",
          "depth": 2,
          "title": "简介"
        },
        {
          "id": "what-are-the-best-large-language-models",
          "depth": 3,
          "title": "最好的大型语言模型是什么？"
        },
        {
          "id": "what-is-the-best-configuration",
          "depth": 3,
          "title": "最好的配置是什么？"
        },
        {
          "id": "hardware-requirements-and-orientation",
          "depth": 2,
          "title": "硬件要求和方向"
        },
        {
          "id": "model-size-calculator",
          "depth": 4,
          "title": "模型尺寸计算器"
        },
        {
          "id": "downloading-an-llm",
          "depth": 2,
          "title": "下载法学硕士"
        },
        {
          "id": "walkthrough-for-downloading-kunoichi-dpo-v2-7b",
          "depth": 3,
          "title": "下载 Kunoichi-DPO-v2-7B 的演练"
        },
        {
          "id": "how-to-identify-the-type-of-model",
          "depth": 3,
          "title": "如何识别模型类型"
        },
        {
          "id": "installing-an-llm-server-oobabooga-or-koboldai",
          "depth": 2,
          "title": "安装 LLM 服务器：Oobabooga 或 KoboldAI"
        },
        {
          "id": "downloading-and-using-koboldcpp-no-installation-required-gguf-models",
          "depth": 3,
          "title": "下载并使用KoboldCpp（无需安装，GGUF型号）"
        },
        {
          "id": "tips-for-optimizing-koboldcpps-speed",
          "depth": 3,
          "title": "优化 KoboldCpp 速度的技巧"
        },
        {
          "id": "installing-oobabooga",
          "depth": 3,
          "title": "安装 Oobaboga"
        },
        {
          "id": "loading-our-model-in-oobabooga",
          "depth": 3,
          "title": "在 Oobaboga 中加载我们的模型"
        },
        {
          "id": "configuring-sillytavern-to-talk-to-oobabooga",
          "depth": 3,
          "title": "配置 SillyTavern 与 Oobabooga 对话"
        },
        {
          "id": "conclusion",
          "depth": 2,
          "title": "结论"
        }
      ],
      "content": "# 使用自托管模型\n\n> 本指南基于作者的个人经验和知识，并非绝对真理。所有的言论都应该持保留态度。如果您有任何更正或建议，请通过 Discord 联系我们或发送 PR 至 [SillyTavern 文档库](https://github.com/SillyTavern/SillyTavern-Docs).\n\n## 简介\n\n本指南旨在帮助您设置使用 SillyTavern 和在您的 PC 上运行的本地 AI（我们将从现在开始使用正确的术语并将其称为 LLM）。在向人们提出技术支持问题之前请先阅读此内容。\n\n### 最好的大型语言模型是什么？\n\n这个问题无法回答，因为没有标准的“最佳”尺度。社区在 Reddit 和 Discord 上有足够的资源和讨论，至少可以就什么是首选/首选模型形成一些意见。您的里程可能会有所不同。\n\n### 最好的配置是什么？\n\n如果有最好的或简单的设置，是否还需要进行配置？最好的配置就是适合您的配置。这是一个反复试验的过程。\n\n## 硬件要求和方向\n\n这是一个复杂的主题，因此我将坚持要点并进行概括。\n\n- 您可以从互联网上下载数以千计的免费法学硕士，类似于稳定扩散拥有大量用于生成图像的模型。\n- 运行未经修改的 LLM 需要具有大量 VRAM（GPU 内存）的巨型 GPU。比你拥有的还要多。\n- 通过使用量化技术（例如 GPTQ 或 AWQ）压缩模型，可以减少 VRAM 要求。这使得模型的能力稍差，但大大降低了运行它的 VRAM 要求。突然之间，拥有 3080 等游戏 GPU 的用户可以运行 13B 型号。尽管它不如非量化模型，但仍然不错。\n- 它变得更好：还存在一种称为 GGUF（以前称为 GGML）的模型格式和量化，它已成为没有巨型 GPU 的普通人的首选格式。这使您可以在没有 GPU 的情况下使用法学硕士。它只会使用 CPU 和 RAM。这比使用 GPTQ/AWQ 在 GPU 上运行 LLM 慢得多（可能是 15 倍），尤其是在提示词处理期间，但模型的能力同样好。然后，GGUF 创建者通过添加一个配置选项进一步优化 GGUF，该配置选项允许拥有游戏级 GPU 的用户将部分模型卸载到 GPU，从而允许他们以 GPU 速度运行部分模型（请注意，这不会降低 RAM 要求，只会提高生成速度）。\n- 模型有不同的大小，根据训练的参数数量来命名。你会看到诸如 7B、13B、30B、70B 等名称。你可以将这些视为模型的大脑大小。 13B 模型将比同系列模型中的 7B 模型更强大：它们接受相同数据的训练，但更大的大脑可以更好地保留知识并更连贯地思考。更大的型号还需要更多的 VRAM/RAM。\n- 量化有多种程度（8 位、5 位、4 位等）。越低，模型性能下降越多，但硬件要求也越低。因此，即使硬件很差，您也可以运行所需模型的 4 位版本。甚至还有 3 位和 2 位量化，但在这一点上，你已经是死马了。还有一种名为 k_s、k_m、k_l 等的进一步量化子类型。k_m 比 k_s 更好，但需要更多资源。\n- 上下文大小（在模型不删除部分内容的情况下对话可以持续多长时间）也会影响 VRAM/RAM 要求。值得庆幸的是，这是一个可配置的设置，允许您使用较小的上下文来减少 VRAM/RAM 要求。 （注：基于 Llama2 的模型的上下文大小为 4k。Mistral 宣传为 8k，但实际上是 4k。）\n- 2023 年的某个时候，NVIDIA 更改了 GPU 驱动程序，这样，如果您需要的 VRAM 多于 GPU 的 VRAM，任务不会崩溃，而是会开始使用常规 RAM 作为后备。这会破坏 LLM 的写作速度，但该模型仍然可以工作并提供相同质量的输出。值得庆幸的是，这种行为 [可以禁用](https://nvidia.custhelp.com/app/answers/detail/a_id/5490).\n\n考虑到上述所有因素，硬件要求和性能完全取决于模型系列、模型类型、模型大小、量化方法等。\n\n#### 模型尺寸计算器\n\n您可以使用 [Nyx 的模型尺寸计算器](https://huggingface.co/spaces/NyxKrage/LLM-Model-VRAM-Calculator) 确定您需要多少 RAM/VRAM。\n\n请记住，您想要运行适合您记忆的最大、量化最少的模型，即不会导致 [磁盘交换](https://serverfault.com/a/48487).\n\n## 下载法学硕士\n\n首先，您需要下载 LLM。查找和下载法学硕士最常见的地方是 HuggingFace。有数千种型号可供选择。查找 GGUF 模型的一个好方法是检查 bartowski 的帐户页面： <https://huggingface.co/bartowski>。如果您不需要 GGUF，他会链接原始模型页面，您可能会在其中找到同一模型的其他格式。\n\n在给定模型的页面上，您会发现一大堆文件。\n\n- 您可能不需要全部！对于 GGUF，您只需要 .gguf 模型文件（通常为 4-11GB）。如果您发现多个大文件，通常都是同一模型的不同量化，您只需选择一个即可。\n- 对于 .safetensors 文件（可以是量化或未量化的 GPTQ 或 AWQ 或 HF），如果您在文件名中看到数字序列，如 model-00001-of-00003.safetensors，那么您需要所有 3 个 .safetensors 文件 + 存储库中的所有其他文件（标记器、配置等）来获取完整模型。\n- 截至 2024 年 1 月，Mixtral MOE 8x7B 被广泛认为是当地法学硕士的最先进技术。如果你有 32GB RAM 来运行它，一定要尝试一下。如果您的 RAM 小于 32GB，请使用 Kunoichi-DPO-v2-7B，尽管它的大小非常出色。\n\n### 下载 Kunoichi-DPO-v2-7B 的演练\n\n我们将在本指南的其余部分使用 Kunoichi-DPO-v2-7B 模型。这是一款基于 Mistral 7B 的出色型号，仅需要 7GB RAM，并且性能远超其重量。注意：Kunoichi 使用羊驼提示。\n\n- 前往 <https://huggingface.co/brittlewis12/Kunoichi-DPO-v2-7B-GGUF>\n- 单击“文件和版本”。您将看到几个文件的列表。这些都是相同的模型，但提供不同的量化选项。单击文件“kunoichi-dpo-v2-7b.Q6_K.gguf”，它为我们提供了 6 位量化。\n- 单击“下载”按钮。您的下载应该开始。\n\n### 如何识别模型类型\n\n像 TheBloke 这样的优秀模型上传者会给出描述性名称。但如果他们不这样做：\n\n- 文件名以 .gguf 结尾：GGUF CPU 型号（废话）\n- 文件名以 .safetensors 结尾：可以是未量化的、或 HF 量化的、或 GPTQ 或 AWQ\n- 文件名是 pytorch-\\*\\*\\*.bin：与上面相同，但这是一种较旧的模型文件格式，允许模型在加载模型时执行任意 Python 脚本，并且被认为是不安全的。如果您信任模型创建者或者绝望，您仍然可以使用它，但如果可以选择，请选择 .safetensors。\n- config.json 存在吗？看看它是否有 quant_method。\n- q4表示4位量化，q5表示5位量化，依此类推\n- 你看到像 -16k 这样的数字吗？这是增加的上下文大小（即，在模型忘记聊天的开始之前您的对话可以持续多长时间）！请注意，较高的上下文大小需要更多的 VRAM。\n\n## 安装 LLM 服务器：Oobabooga 或 KoboldAI\n\n现在 LLM 在您的 PC 上，我们需要下载一个工具，充当 SillyTavern 和模型之间的中间人：它将加载模型，并将其功能公开为 SillyTavern 可以与之通信的本地 HTTP Web API，就像 SillyTavern 与 OpenAI GPT 或 Claude 等付费 Web 服务通信一样。您使用的工具应该是 KoboldAI 或 Oobabooga（或其他兼容工具）。\n\n本指南涵盖了这两个选项，您只需要一个。\n\n> 如果您在 Docker 上托管 SillyTavern，请使用 **<http://host.docker.internal:\\><端口>** 而不是 **<http://127.0.0.1:\\><端口>**。这是因为 SillyTavern 从 Docker 容器中运行的服务器连接到 API 端点。 Docker 的网络堆栈与主机的网络堆栈是分开的，因此环回接口不共享。\n\n### 下载并使用KoboldCpp（无需安装，GGUF型号）\n\n1. 参观 <https://koboldai.org/cpp> 您将在其中看到最新版本以及可以下载的各种文件。\n   在撰写本文时，他们列出的最新 CUDA 版本是 cu12，它在现代 Nvidia GPU 上运行效果最佳，如果您有较旧的 GPU 或不同品牌，则可以使用常规的 koboldcpp.exe。如果您有旧的 CPU，当您尝试加载模型时，KoboldCpp 可能会崩溃，在这种情况下，请尝试 \\_oldcpu 版本，看看它是否可以解决您的问题。\n2. KoboldCpp 不需要安装，一旦启动 KoboldCpp，您将立即能够使用模型字段旁边的浏览按钮选择 GGUF 模型，例如上面链接的模型。\n3. 默认情况下，KoboldCpp 最多在 4K 上下文中运行，即使您在 SillyTavern 中将其设置得更高，如果您希望在更高的上下文中运行模型，请确保在启动模型之前调整此屏幕上的上下文滑块。请记住，更多的上下文大小意味着更高的（视频）内存要求，如果您将其设置得太高或加载对于您的系统来说太大的模型，KoboldCpp 将自动开始使用您的 CPU 来处理它无法适合您的 GPU 的层，这会慢得多。\n4. 单击“启动”，如果一切顺利，将使用 KoboldAI Lite 打开一个新网页，您可以在其中测试一切是否正常工作。\n5. 打开 SillyTavern 并单击 API 连接（顶部栏中的第二个按钮）\n6. 将 API 设置为文本补全，将 API 类型设置为 KoboldCpp。\n7. 将服务器 URL 设置为 <http://127.0.0.1:5001/> 或 KoboldCpp 为您提供的链接，以防它不在同一系统上运行（您可以激活 KoboldCpp 的远程隧道模式以获得可从任何地方访问的链接）。\n8. 单击“连接”。它应该成功连接并检测到 kunoichi-dpo-v2-7b.Q6_K.gguf 作为模型。\n9. 与角色聊天以测试其是否有效。\n\n### 优化 KoboldCpp 速度的技巧\n\n1. Flash Attention 将有助于减少内存需求，它可以更快或更慢，具体取决于您的系统，并且允许您在 GPU 上安装比默认值更多的层。\n2. KoboldCpp 在猜测层时会为其他软件留出一些空间以防止出现问题，如果您打开的程序很少并且无法将模型完全放入 GPU 中，您可以添加一些额外的层。\n3. 如果模型在上下文大小上使用了太多内存，您可以通过量化 KV 来减少内存。这会降低输出质量，但可以帮助您在 GPU 上放置更多层。为此，请转到 KoboldCpp 中的 Token 选项卡，然后禁用上下文转移并启用 Flash Attention。这将解锁量化 KV 缓存滑块，数字越低意味着模型的内存/智能越少。\n4. 在速度较慢的系统上运行 KoboldCpp 需要很长时间才能处理提示词？当您避免使用 Lorebooks、随机化或其他动态更改输入的功能时，上下文转换效果最佳。启用上下文转换 KoboldCpp 将帮助您避免长时间的重新处理时间。\n\n### 安装 Oobaboga\n\n> **注释**\n>\n> 根据您安装 Oobabooga 的方式，文件路径可能略有不同；即 `/text-generation-webui/user_data` 如果您通过 git clone 安装，并且 `/text-generation-webui-main/user_data` 如果您使用 .zip 方法。\n\n这是更正确/防伪的安装过程：\n\n1. 克隆 <https://github.com/oobabooga/text-generation-webui> （或者在浏览器中将其存储库下载为 .zip，然后解压）\n2. 运行 `start_windows.bat` 或者无论你的操作系统是什么\n3. 当系统询问时，选择您的 GPU 类型。即使您打算使用 GGUF/CPU，如果您的 GPU 在列表中，请立即选择它，因为它会让您选择使用稍后称为 GPU 分片的速度优化（无需从头开始重新安装）。如果您没有游戏级 dGPU（NVIDIA、AMD），请选择“无”。\n4. 等待安装完成\n5. 将 kunoichi-dpo-v2-7b.Q6_K.gguf 放入 `text-generation-webui/user_data/models`\n6. 打开 `text-generation-webui/user_data/CMD_FLAGS.txt`，删除里面的所有内容并写入： `--api`\n7. 重新启动 Oobaboga\n8. 参观 <http://127.0.0.1:5000/docs>。它会加载 FastAPI 页面吗？如果没有，你就在某个地方搞砸了。\n\n### 在 Oobaboga 中加载我们的模型\n\n1. 打开 <http://127.0.0.1:7860/> 在你的浏览器中\n2. 单击模型选项卡\n3. 在下拉列表中，选择我们的 Kunoichi DPO v2 模型。它应该自动选择 llama.cpp 加载器。\n4. （可选）我们之前多次提到“GPU 卸载”：这是本页上的 n-gpu-layers 设置。如果您想使用它，请在加载模型之前设置一个值。作为基本参考，对于 13B 及更低型号，将其设置为 30 使用略低于 6GB VRAM。 （随模型架构和尺寸的不同而变化）\n5. 单击加载\n\n### 配置 SillyTavern 与 Oobabooga 对话\n\n1. 单击 API 连接（顶部栏中的第二个按钮）\n2. 将 API 设置为文本补全\n3. 将 API 类型设置为默认值 (Oobabooga)\n4. 将服务器 URL 设置为 <http://127.0.0.1:5000/>\n5. 单击“连接”。它应该成功连接并检测到 kunoichi-dpo-v2-7b.Q6_K.gguf 作为模型。\n6. 与角色聊天以测试其是否有效\n\n## 结论\n\n恭喜，您现在应该拥有一名在当地工作的法学硕士。\n",
      "searchText": "使用自托管模型 本指南基于作者的个人经验和知识，并非绝对真理。所有的言论都应该持保留态度。如果您有任何更正或建议，请通过 Discord 联系我们或发送 PR 至 SillyTavern 文档库. 简介 本指南旨在帮助您设置使用 SillyTavern 和在您的 PC 上运行的本地 AI（我们将从现在开始使用正确的术语并将其称为 LLM）。在向人们提出技术支持问题之前请先阅读此内容。 最好的大型语言模型是什么？ 这个问题无法回答，因为没有标准的“最佳”尺度。社区在 Reddit 和 Discord 上有足够的资源和讨论，至少可以就什么是首选/首选模型形成一些意见。您的里程可能会有所不同。 最好的配置是什么？ 如果有最好的或简单的设置，是否还需要进行配置？最好的配置就是适合您的配置。这是一个反复试验的过程。 硬件要求和方向 这是一个复杂的主题，因此我将坚持要点并进行概括。 您可以从互联网上下载数以千计的免费法学硕士，类似于稳定扩散拥有大量用于生成图像的模型。 运行未经修改的 LLM 需要具有大量 VRAM（GPU 内存）的巨型 GPU。比你拥有的还要多。 通过使用量化技术（例如 GPTQ 或 AWQ）压缩模型，可以减少 VRAM 要求。这使得模型的能力稍差，但大大降低了运行它的 VRAM 要求。突然之间，拥有 3080 等游戏 GPU 的用户可以运行 13B 型号。尽管它不如非量化模型，但仍然不错。 它变得更好：还存在一种称为 GGUF（以前称为 GGML）的模型格式和量化，它已成为没有巨型 GPU 的普通人的首选格式。这使您可以在没有 GPU 的情况下使用法学硕士。它只会使用 CPU 和 RAM。这比使用 GPTQ/AWQ 在 GPU 上运行 LLM 慢得多（可能是 15 倍），尤其是在提示词处理期间，但模型的能力同样好。然后，GGUF 创建者通过添加一个配置选项进一步优化 GGUF，该配置选项允许拥有游戏级 GPU 的用户将部分模型卸载到 GPU，从而允许他们以 GPU 速度运行部分模型（请注意，这不会降低 RAM 要求，只会提高生成速度）。 模型有不同的大小，根据训练的参数数量来命名。你会看到诸如 7B、13B、30B、70B 等名称。你可以将这些视为模型的大脑大小。 13B 模型将比同系列模型中的 7B 模型更强大：它们接受相同数据的训练，但更大的大脑可以更好地保留知识并更连贯地思考。更大的型号还需要更多的 VRAM/RAM。 量化有多种程度（8 位、5 位、4 位等）。越低，模型性能下降越多，但硬件要求也越低。因此，即使硬件很差，您也可以运行所需模型的 4 位版本。甚至还有 3 位和 2 位量化，但在这一点上，你已经是死马了。还有一种名为 k_s、k_m、k_l 等的进一步量化子类型。k_m 比 k_s 更好，但需要更多资源。 上下文大小（在模型不删除部分内容的情况下对话可以持续多长时间）也会影响 VRAM/RAM 要求。值得庆幸的是，这是一个可配置的设置，允许您使用较小的上下文来减少 VRAM/RAM 要求。 （注：基于 Llama2 的模型的上下文大小为 4k。Mistral 宣传为 8k，但实际上是 4k。） 2023 年的某个时候，NVIDIA 更改了 GPU 驱动程序，这样，如果您需要的 VRAM 多于 GPU 的 VRAM，任务不会崩溃，而是会开始使用常规 RAM 作为后备。这会破坏 LLM 的写作速度，但该模型仍然可以工作并提供相同质量的输出。值得庆幸的是，这种行为 可以禁用. 考虑到上述所有因素，硬件要求和性能完全取决于模型系列、模型类型、模型大小、量化方法等。 模型尺寸计算器 您可以使用 Nyx 的模型尺寸计算器 确定您需要多少 RAM/VRAM。 请记住，您想要运行适合您记忆的最大、量化最少的模型，即不会导致 磁盘交换. 下载法学硕士 首先，您需要下载 LLM。查找和下载法学硕士最常见的地方是 HuggingFace。有数千种型号可供选择。查找 GGUF 模型的一个好方法是检查 bartowski 的帐户页面： https://huggingface.co/bartowski。如果您不需要 GGUF，他会链接原始模型页面，您可能会在其中找到同一模型的其他格式。 在给定模型的页面上，您会发现一大堆文件。 您可能不需要全部！对于 GGUF，您只需要 .gguf 模型文件（通常为 4-11GB）。如果您发现多个大文件，通常都是同一模型的不同量化，您只需选择一个即可。 对于 .safetensors 文件（可以是量化或未量化的 GPTQ 或 AWQ 或 HF），如果您在文件名中看到数字序列，如 model-00001-of-00003.safetensors，那么您需要所有 3 个 .safetensors 文件 + 存储库中的所有其他文件（标记器、配置等）来获取完整模型。 截至 2024 年 1 月，Mixtral MOE 8x7B 被广泛认为是当地法学硕士的最先进技术。如果你有 32GB RAM 来运行它，一定要尝试一下。如果您的 RAM 小于 32GB，请使用 Kunoichi-DPO-v2-7B，尽管它的大小非常出色。 下载 Kunoichi-DPO-v2-7B 的演练 我们将在本指南的其余部分使用 Kunoichi-DPO-v2-7B 模型。这是一款基于 Mistral 7B 的出色型号，仅需要 7GB RAM，并且性能远超其重量。注意：Kunoichi 使用羊驼提示。 前往 https://huggingface.co/brittlewis12/Kunoichi-DPO-v2-7B-GGUF 单击“文件和版本”。您将看到几个文件的列表。这些都是相同的模型，但提供不同的量化选项。单击文件“kunoichi-dpo-v2-7b.Q6_K.gguf”，它为我们提供了 6 位量化。 单击“下载”按钮。您的下载应该开始。 如何识别模型类型 像 TheBloke 这样的优秀模型上传者会给出描述性名称。但如果他们不这样做： 文件名以 .gguf 结尾：GGUF CPU 型号（废话） 文件名以 .safetensors 结尾：可以是未量化的、或 HF 量化的、或 GPTQ 或 AWQ 文件名是 pytorch-***.bin：与上面相同，但这是一种较旧的模型文件格式，允许模型在加载模型时执行任意 Python 脚本，并且被认为是不安全的。如果您信任模型创建者或者绝望，您仍然可以使用它，但如果可以选择，请选择 .safetensors。 config.json 存在吗？看看它是否有 quant_method。 q4表示4位量化，q5表示5位量化，依此类推 你看到像 -16k 这样的数字吗？这是增加的上下文大小（即，在模型忘记聊天的开始之前您的对话可以持续多长时间）！请注意，较高的上下文大小需要更多的 VRAM。 安装 LLM 服务器：Oobabooga 或 KoboldAI 现在 LLM 在您的 PC 上，我们需要下载一个工具，充当 SillyTavern 和模型之间的中间人：它将加载模型，并将其功能公开为 SillyTavern 可以与之通信的本地 HTTP Web API，就像 SillyTavern 与 OpenAI GPT 或 Claude 等付费 Web 服务通信一样。您使用的工具应该是 KoboldAI 或 Oobabooga（或其他兼容工具）。 本指南涵盖了这两个选项，您只需要一个。 如果您在 Docker 上托管 SillyTavern，请使用 http://host.docker.internal:\\<端口> 而不是 http://127.0.0.1:\\<端口>。这是因为 SillyTavern 从 Docker 容器中运行的服务器连接到 API 端点。 Docker 的网络堆栈与主机的网络堆栈是分开的，因此环回接口不共享。 下载并使用KoboldCpp（无需安装，GGUF型号） 参观 https://koboldai.org/cpp 您将在其中看到最新版本以及可以下载的各种文件。 在撰写本文时，他们列出的最新 CUDA 版本是 cu12，它在现代 Nvidia GPU 上运行效果最佳，如果您有较旧的 GPU 或不同品牌，则可以使用常规的 koboldcpp.exe。如果您有旧的 CPU，当您尝试加载模型时，KoboldCpp 可能会崩溃，在这种情况下，请尝试 _oldcpu 版本，看看它是否可以解决您的问题。 KoboldCpp 不需要安装，一旦启动 KoboldCpp，您将立即能够使用模型字段旁边的浏览按钮选择 GGUF 模型，例如上面链接的模型。 默认情况下，KoboldCpp 最多在 4K 上下文中运行，即使您在 SillyTavern 中将其设置得更高，如果您希望在更高的上下文中运行模型，请确保在启动模型之前调整此屏幕上的上下文滑块。请记住，更多的上下文大小意味着更高的（视频）内存要求，如果您将其设置得太高或加载对于您的系统来说太大的模型，KoboldCpp 将自动开始使用您的 CPU 来处理它无法适合您的 GPU 的层，这会慢得多。 单击“启动”，如果一切顺利，将使用 KoboldAI Lite 打开一个新网页，您可以在其中测试一切是否正常工作。 打开 SillyTavern 并单击 API 连接（顶部栏中的第二个按钮） 将 API 设置为文本补全，将 API 类型设置为 KoboldCpp。 将服务器 URL 设置为 http://127.0.0.1:5001/ 或 KoboldCpp 为您提供的链接，以防它不在同一系统上运行（您可以激活 KoboldCpp 的远程隧道模式以获得可从任何地方访问的链接）。 单击“连接”。它应该成功连接并检测到 kunoichi-dpo-v2-7b.Q6_K.gguf 作为模型。 与角色聊天以测试其是否有效。 优化 KoboldCpp 速度的技巧 Flash Attention 将有助于减少内存需求，它可以更快或更慢，具体取决于您的系统，并且允许您在 GPU 上安装比默认值更多的层。 KoboldCpp 在猜测层时会为其他软件留出一些空间以防止出现问题，如果您打开的程序很少并且无法将模型完全放入 GPU 中，您可以添加一些额外的层。 如果模型在上下文大小上使用了太多内存，您可以通过量化 KV 来减少内存。这会降低输出质量，但可以帮助您在 GPU 上放置更多层。为此，请转到 KoboldCpp 中的 Token 选项卡，然后禁用上下文转移并启用 Flash Attention。这将解锁量化 KV 缓存滑块，数字越低意味着模型的内存/智能越少。 在速度较慢的系统上运行 KoboldCpp 需要很长时间才能处理提示词？当您避免使用 Lorebooks、随机化或其他动态更改输入的功能时，上下文转换效果最佳。启用上下文转换 KoboldCpp 将帮助您避免长时间的重新处理时间。 安装 Oobaboga 注释 根据您安装 Oobabooga 的方式，文件路径可能略有不同；即 /text-generation-webui/user_data 如果您通过 git clone 安装，并且 /text-generation-webui-main/user_data 如果您使用 .zip 方法。 这是更正确/防伪的安装过程： 克隆 https://github.com/oobabooga/text-generation-webui （或者在浏览器中将其存储库下载为 .zip，然后解压） 运行 start_windows.bat 或者无论你的操作系统是什么 当系统询问时，选择您的 GPU 类型。即使您打算使用 GGUF/CPU，如果您的 GPU 在列表中，请立即选择它，因为它会让您选择使用稍后称为 GPU 分片的速度优化（无需从头开始重新安装）。如果您没有游戏级 dGPU（NVIDIA、AMD），请选择“无”。 等待安装完成 将 kunoichi-dpo-v2-7b.Q6_K.gguf 放入 text-generation-webui/user_data/models 打开 text-generation-webui/user_data/CMD_FLAGS.txt，删除里面的所有内容并写入： --api 重新启动 Oobaboga 参观 http://127.0.0.1:5000/docs。它会加载 FastAPI 页面吗？如果没有，你就在某个地方搞砸了。 在 Oobaboga 中加载我们的模型 打开 http://127.0.0.1:7860/ 在你的浏览器中 单击模型选项卡 在下拉列表中，选择我们的 Kunoichi DPO v2 模型。它应该自动选择 llama.cpp 加载器。 （可选）我们之前多次提到“GPU 卸载”：这是本页上的 n-gpu-layers 设置。如果您想使用它，请在加载模型之前设置一个值。作为基本参考，对于 13B 及更低型号，将其设置为 30 使用略低于 6GB VRAM。 （随模型架构和尺寸的不同而变化） 单击加载 配置 SillyTavern 与 Oobabooga 对话 单击 API 连接（顶部栏中的第二个按钮） 将 API 设置为文本补全 将 API 类型设置为默认值 (Oobabooga) 将服务器 URL 设置为 http://127.0.0.1:5000/ 单击“连接”。它应该成功连接并检测到 kunoichi-dpo-v2-7b.Q6_K.gguf 作为模型。 与角色聊天以测试其是否有效 结论 恭喜，您现在应该拥有一名在当地工作的法学硕士。",
      "translationStatus": "machine-draft"
    },
    {
      "slug": "api-connections/openai",
      "title": "OpenAI",
      "group": "API_Connections",
      "order": 20,
      "source": "Usage/API_Connections/openai.md",
      "sourceUrl": "https://docs.sillytavern.app/usage/api-connections/openai/",
      "sourceSha256": "7c05b29b0e33192c05ebec848bb6163703dd547b91db2a131414b3d1b06a6c57",
      "headings": [
        {
          "id": "chat-completions",
          "depth": 1,
          "title": "OpenAI"
        },
        {
          "id": "source-specific-instructions",
          "depth": 2,
          "title": "特定来源的说明"
        },
        {
          "id": "openai",
          "depth": 3,
          "title": "开放人工智能"
        },
        {
          "id": "claude",
          "depth": 3,
          "title": "克洛德"
        },
        {
          "id": "mistral-ai",
          "depth": 3,
          "title": "米斯特拉尔人工智能"
        },
        {
          "id": "deepseek",
          "depth": 3,
          "title": "深度搜索"
        },
        {
          "id": "ai21",
          "depth": 3,
          "title": "人工智能21"
        },
        {
          "id": "cohere",
          "depth": 3,
          "title": "连贯"
        },
        {
          "id": "perplexity",
          "depth": 3,
          "title": "困惑"
        },
        {
          "id": "fireworks-ai",
          "depth": 3,
          "title": "烟花人工智能"
        },
        {
          "id": "electron-hub",
          "depth": 2,
          "title": "电子集线器"
        },
        {
          "id": "custom-openai-compatible-endpoint",
          "depth": 2,
          "title": "自定义 OpenAI 兼容端点"
        },
        {
          "id": "connecting",
          "depth": 3,
          "title": "正在连接"
        },
        {
          "id": "selecting-a-model",
          "depth": 3,
          "title": "选择型号"
        },
        {
          "id": "prompt-post-processing",
          "depth": 2,
          "title": "提示词后处理"
        }
      ],
      "content": "# OpenAI\n\n## 特定来源的说明\n\n> ****重要！****\n>\n> 大多数 API 平台仅允许您在创建 API 密钥时查看一次生成的 API 密钥。如果丢失，则需要生成新密钥。请务必妥善保管！\n\n### 开放人工智能\n\n使用OpenAI的开发者平台可以接入各种OpenAI模型，包括gpt-4o、gpt-4.1、o3等。\n\n**如何获取 API 密钥：**\n\n1. 前往 [开放人工智能](https://platform.openai.com/) 并登录。\n2. 使用“[查看 API 密钥](https://platform.openai.com/account/api-keys)“创建新 API 密钥的选项。\n\n### 克洛德\n\nClaude 是 Anthropic 开发的一系列人工智能模型。您可以通过 Anthropic 控制台访问 Claude 模型。\n\n**如何获取 API 密钥：**\n\n1. 前往 [人择控制台](https://console.anthropic.com/) 并登录。\n2. 使用“[获取API密钥](https://console.anthropic.com/settings/keys)”部分创建新的 API 密钥。\n\n### 米斯特拉尔人工智能\n\nMistral AI 是一个开发开放和专有模型的团队，具有高科学标准并注重开放性。您可以在本地或通过他们的 API 服务 La Plateforme 运行他们的模型。\n\n**如何获取 API 密钥：**\n\n1. 第一步是创建一个帐户 [平台](https://console.mistral.ai/).\n2. 完成后，您可以选择 [计划](https://console.mistral.ai/billing/plans) 并设置您的付款信息或选择免费套餐。\n3. 接下来，您可以创建您的 [API密钥](https://console.mistral.ai/api-keys/)。您可能需要等待几分钟才能使密钥生效！\n\n### 深度搜索\n\nDeepSeek 平台通过 API 提供对最新 DeepSeek 模型的访问。他们提供一系列型号，包括 DeepSeek V3 和 DeepSeek R1。\n\n**如何获取 API 密钥：**\n\n1. 注册 [DeepSeek平台](https://platform.deepseek.com/).\n2. 注册并充值账户后，您可以在“[API 密钥](https://platform.deepseek.com/api_keys)”部分。\n\n### 人工智能21\n\nAI21 Labs 提供一系列人工智能模型，包括其旗舰 Jamba 系列。您可以通过 AI21 Studio API 访问他们的模型。\n\n**如何获取 API 密钥：**\n\n1. 前往 [AI21工作室](https://studio.ai21.com/) 并登录。\n2. 导航至“设置 => API 密钥”部分以创建新的 API 密钥。\n\n### 连贯\n\nCohere 提供了一套适用于各种任务的 AI 模型，包括文本生成和嵌入。您可以通过 Cohere API 访问他们的模型。\n\n**如何获取 API 密钥：**\n\n1. 前往 [连贯](https://cohere.com/) 并登录。\n2. 导航至“[API 密钥](https://dashboard.cohere.com/api-keys)帐户设置中的“部分来创建新的 API 密钥。\n\n### 困惑\n\nPerplexity AI 通过其 API 提供对在线声纳模型的访问，以进行实时研究和信息检索。\n\n官方入门指南： [困惑快速入门](https://docs.perplexity.ai/getting-started/quickstart)\n\n**如何获取 API 密钥：**\n\n1. 前往 [困惑](https://perplexity.ai/) 并登录。\n2. 前往“[API计费](https://www.perplexity.ai/account/api/billing)”部分购买 API 使用积分。\n3. 导航至“[API 密钥](https://www.perplexity.ai/account/api/keys)设置中的“部分来创建新的 API 密钥。\n\n### 烟花人工智能\n\nFireworks AI 是一个高性能平台，可提供对最先进的开源语言模型的快速、经济高效的访问。该平台通过兼容 OpenAI 的 API 提供无服务器部署，并支持高达 256,000 token 的上下文窗口。\n\n**如何获取 API 密钥：**\n\n1. 前往 [烟花人工智能](https://fireworks.ai/) 并创建帐户或登录。\n2. 导航至 [API 密钥页面](https://app.fireworks.ai/settings/users/api-keys) 在您的帐户设置中。\n3. 单击“创建 API 密钥”并提供描述性名称（例如“SillyTavern”）。\n\n## 电子集线器\n\nElectron Hub 是一个统一的 OpenAI 兼容平台，可通过单个 API 密钥访问多个供应商的模型。\n\n**如何获取 API 密钥：**\n\n1. 创建一个帐户 [电子集线器](https://playground.electronhub.ai/console).\n2. 生成 API 密钥 **控制台 → API 密钥** 页。\n\n## 自定义 OpenAI 兼容端点\n\n> 请务必注意，我们不会为您可能遇到的问题提供支持！\n> 我们不保证与每个可能的 API 端点的兼容性！\n\n> 如果您打算使用此功能来使用本地端点，例如 TabbyAPI、Oobabooga、Aphrodite 或任何类似的端点，您可能需要查看 [内置兼容性](/guides/sillytavern/api-connections/) 相反。自定义端点功能主要用于与公开 OpenAI 兼容 API 聊天补全端点的其他服务和程序一起使用。\n>\n> 大多数文本补全 API 支持的自定义选项比 OpenAI 标准允许的要多得多。这些更大的定制选项，例如 Min-P 采样器，可能值得 SillyTavern 用户检查，这可以大大提高生成的质量。\n\n您可以为聊天完成后端配置备用端点。此自定义端点可以连接到任何支持通用 OpenAI API 架构的服务器。\n\n兼容后端的示例包括：\n\n- [LM工作室](https://lmstudio.ai/)\n- [莱特法学硕士](https://www.litellm.ai/)\n- [本地人工智能](https://localai.io/)\n\n### 正在连接\n\n要访问此功能：\n\n1. 切换到“聊天补全”API 类型\n2. 为“聊天补全源”选择“自定义（OpenAI 兼容）”\n\n输入自定义端点 URL 和 API 密钥（如果需要）。例如，TabbyAPI 需要 API 密钥进行身份验证。\n\n> **提示：** 如果您遇到连接问题，请尝试添加 `/v1` 到端点 URL 的末尾。不要添加 `/chat/completions` 后缀。\n\n### 选择型号\n\n如果自定义 API 实现 `/v1/models` 端点提供可用模型的列表，您可以从下拉列表中进行选择。否则，请使用文本字段手动输入模型 ID。\n\n选中“绕过 API 状态检查”以防止 SillyTavern 向您发出有关无法运行的 API 端点的警报。如果您的 API 端点工作正常但 SillyTavern 继续显示警告，请启用此选项。\n\n单击“测试消息”，通过向模型发送简单的提示词来验证连接。\n\n> **记录外部提供商？**\n>\n> 提供商开发人员应该阅读 [集成外部提供商](https://docs.sillytavern.app/for-contributors/provider-integrations/) 对于提供商拥有的设置指南模板和 UI 扩展、服务器插件和官方集成路线。\n\n## 提示词后处理\n\n> **注意：** 当使用带有“无工具”的后处理选项时，不支持工具调用！\n\n某些端点可能会对传入提示词的格式施加特定限制，例如仅需要一条系统消息或严格交替角色。\n\nSillyTavern 提供内置提示词转换器来帮助满足这些要求（从最少到最严格）：\n\n1. 无 - 除非 API 严格要求，否则不应用显式处理\n2. 合并来自同一角色的连续消息\n3. 半严格 - 合并角色并仅允许一条可选系统消息\n4. 严格 - 合并角色，只允许一个可选的系统消息，并且要求用户消息位于第一位\n5. 单个用户消息 - 将所有角色的所有消息合并到单个用户消息中\n\n合并、半严格和严格还会从提示词中删除任何工具调用，除非选择“使用工具”变体。这对于不支持工具调用并且您现有的提示词包含工具调用的 API 非常有用。\n\n除“自定义 OpenAI 兼容”之外，限制较少的选项对 SillyTavern 中实现的限制较多的端点没有影响；自定义可能会因无效请求而出错。\n\n在严格模式下，如果第一条辅助消息之前不存在用户消息，则 `promptPlaceholder` 来自 `config.yaml` 将插入，默认为“\\[开始新聊天]”。\n",
      "searchText": "OpenAI 特定来源的说明 重要！ 大多数 API 平台仅允许您在创建 API 密钥时查看一次生成的 API 密钥。如果丢失，则需要生成新密钥。请务必妥善保管！ 开放人工智能 使用OpenAI的开发者平台可以接入各种OpenAI模型，包括gpt-4o、gpt-4.1、o3等。 如何获取 API 密钥： 前往 开放人工智能 并登录。 使用“查看 API 密钥“创建新 API 密钥的选项。 克洛德 Claude 是 Anthropic 开发的一系列人工智能模型。您可以通过 Anthropic 控制台访问 Claude 模型。 如何获取 API 密钥： 前往 人择控制台 并登录。 使用“获取API密钥”部分创建新的 API 密钥。 米斯特拉尔人工智能 Mistral AI 是一个开发开放和专有模型的团队，具有高科学标准并注重开放性。您可以在本地或通过他们的 API 服务 La Plateforme 运行他们的模型。 如何获取 API 密钥： 第一步是创建一个帐户 平台. 完成后，您可以选择 计划 并设置您的付款信息或选择免费套餐。 接下来，您可以创建您的 API密钥。您可能需要等待几分钟才能使密钥生效！ 深度搜索 DeepSeek 平台通过 API 提供对最新 DeepSeek 模型的访问。他们提供一系列型号，包括 DeepSeek V3 和 DeepSeek R1。 如何获取 API 密钥： 注册 DeepSeek平台. 注册并充值账户后，您可以在“API 密钥”部分。 人工智能21 AI21 Labs 提供一系列人工智能模型，包括其旗舰 Jamba 系列。您可以通过 AI21 Studio API 访问他们的模型。 如何获取 API 密钥： 前往 AI21工作室 并登录。 导航至“设置 => API 密钥”部分以创建新的 API 密钥。 连贯 Cohere 提供了一套适用于各种任务的 AI 模型，包括文本生成和嵌入。您可以通过 Cohere API 访问他们的模型。 如何获取 API 密钥： 前往 连贯 并登录。 导航至“API 密钥帐户设置中的“部分来创建新的 API 密钥。 困惑 Perplexity AI 通过其 API 提供对在线声纳模型的访问，以进行实时研究和信息检索。 官方入门指南： 困惑快速入门 如何获取 API 密钥： 前往 困惑 并登录。 前往“API计费”部分购买 API 使用积分。 导航至“API 密钥设置中的“部分来创建新的 API 密钥。 烟花人工智能 Fireworks AI 是一个高性能平台，可提供对最先进的开源语言模型的快速、经济高效的访问。该平台通过兼容 OpenAI 的 API 提供无服务器部署，并支持高达 256,000 token 的上下文窗口。 如何获取 API 密钥： 前往 烟花人工智能 并创建帐户或登录。 导航至 API 密钥页面 在您的帐户设置中。 单击“创建 API 密钥”并提供描述性名称（例如“SillyTavern”）。 电子集线器 Electron Hub 是一个统一的 OpenAI 兼容平台，可通过单个 API 密钥访问多个供应商的模型。 如何获取 API 密钥： 创建一个帐户 电子集线器. 生成 API 密钥 控制台 → API 密钥 页。 自定义 OpenAI 兼容端点 请务必注意，我们不会为您可能遇到的问题提供支持！ 我们不保证与每个可能的 API 端点的兼容性！ 如果您打算使用此功能来使用本地端点，例如 TabbyAPI、Oobabooga、Aphrodite 或任何类似的端点，您可能需要查看 内置兼容性 相反。自定义端点功能主要用于与公开 OpenAI 兼容 API 聊天补全端点的其他服务和程序一起使用。 大多数文本补全 API 支持的自定义选项比 OpenAI 标准允许的要多得多。这些更大的定制选项，例如 Min-P 采样器，可能值得 SillyTavern 用户检查，这可以大大提高生成的质量。 您可以为聊天完成后端配置备用端点。此自定义端点可以连接到任何支持通用 OpenAI API 架构的服务器。 兼容后端的示例包括： LM工作室 莱特法学硕士 本地人工智能 正在连接 要访问此功能： 切换到“聊天补全”API 类型 为“聊天补全源”选择“自定义（OpenAI 兼容）” 输入自定义端点 URL 和 API 密钥（如果需要）。例如，TabbyAPI 需要 API 密钥进行身份验证。 提示： 如果您遇到连接问题，请尝试添加 /v1 到端点 URL 的末尾。不要添加 /chat/completions 后缀。 选择型号 如果自定义 API 实现 /v1/models 端点提供可用模型的列表，您可以从下拉列表中进行选择。否则，请使用文本字段手动输入模型 ID。 选中“绕过 API 状态检查”以防止 SillyTavern 向您发出有关无法运行的 API 端点的警报。如果您的 API 端点工作正常但 SillyTavern 继续显示警告，请启用此选项。 单击“测试消息”，通过向模型发送简单的提示词来验证连接。 记录外部提供商？ 提供商开发人员应该阅读 集成外部提供商 对于提供商拥有的设置指南模板和 UI 扩展、服务器插件和官方集成路线。 提示词后处理 注意： 当使用带有“无工具”的后处理选项时，不支持工具调用！ 某些端点可能会对传入提示词的格式施加特定限制，例如仅需要一条系统消息或严格交替角色。 SillyTavern 提供内置提示词转换器来帮助满足这些要求（从最少到最严格）： 无 - 除非 API 严格要求，否则不应用显式处理 合并来自同一角色的连续消息 半严格 - 合并角色并仅允许一条可选系统消息 严格 - 合并角色，只允许一个可选的系统消息，并且要求用户消息位于第一位 单个用户消息 - 将所有角色的所有消息合并到单个用户消息中 合并、半严格和严格还会从提示词中删除任何工具调用，除非选择“使用工具”变体。这对于不支持工具调用并且您现有的提示词包含工具调用的 API 非常有用。 除“自定义 OpenAI 兼容”之外，限制较少的选项对 SillyTavern 中实现的限制较多的端点没有影响；自定义可能会因无效请求而出错。 在严格模式下，如果第一条辅助消息之前不存在用户消息，则 promptPlaceholder 来自 config.yaml 将插入，默认为“[开始新聊天]”。",
      "translationStatus": "machine-draft"
    },
    {
      "slug": "api-connections/openrouter",
      "title": "OpenRouter",
      "group": "API_Connections",
      "order": 10,
      "source": "Usage/API_Connections/OpenRouter.md",
      "sourceUrl": "https://docs.sillytavern.app/usage/api-connections/openrouter/",
      "sourceSha256": "ee7f7e680a2d4069a331cd6a413147edf63bef94fd8bd7a3e2b6712ac921b2a6",
      "headings": [
        {
          "id": "openrouter",
          "depth": 1,
          "title": "OpenRouter"
        }
      ],
      "content": "# OpenRouter\n\n> OpenRouter 可用作文本补全和聊天补全源。所有模型都可以通过任一 API 使用，但它们的功能可能会有所不同，具体取决于您选择的 API 类型。例如，图像内联和工具调用仅适用于聊天补全 API。\n\n不想注册十几个 API 服务，但仍想访问所有最新模型？使用开放路由器。\n\nOpenRouter 的工作原理是让您使用单个端点来访问 DeepSeek、Claude 和 Gemini 等模型，所有这些都在具有共享信用池的一项服务中。\n\n它有免费试用版（大约 1 美元），之后需要付费。无需订阅或按月付费 - 您只需为实际使用的内容付费。某些型号可以免费访问，但每日请求数量有限。\n\n> 要永久访问具有慷慨每日限额的免费模型，您需要购买至少 10 美元的积分 **一次**.\n>\n> 查看更多详细信息 [OpenRouter 常见问题解答页面](https://openrouter.ai/docs/faq).\n\n- 创建一个 OpenRouter 帐户： [开放路由器.ai](https://openrouter.ai/)\n- [OpenRouter 型号列表](https://openrouter.ai/models?order=pricing-low-to-high)\n\n![OpenRouter-连接面板](/docs/sillytavern/static/openrouter-connection.png)\n\n从上到下（见上图）：\n\n1. 选择“聊天补全”API。\n2. 选择 OpenRouter 作为源。\n3. 单击“授权”以使用 OAuth 流程获取密钥。或者，生成 API 密钥 [这里](https://openrouter.ai/keys) 并将其粘贴到框中。\n4. 单击“连接”并选择型号。\n5. （可选）使用“测试消息”按钮来验证您的连接。\n",
      "searchText": "OpenRouter OpenRouter 可用作文本补全和聊天补全源。所有模型都可以通过任一 API 使用，但它们的功能可能会有所不同，具体取决于您选择的 API 类型。例如，图像内联和工具调用仅适用于聊天补全 API。 不想注册十几个 API 服务，但仍想访问所有最新模型？使用开放路由器。 OpenRouter 的工作原理是让您使用单个端点来访问 DeepSeek、Claude 和 Gemini 等模型，所有这些都在具有共享信用池的一项服务中。 它有免费试用版（大约 1 美元），之后需要付费。无需订阅或按月付费 - 您只需为实际使用的内容付费。某些型号可以免费访问，但每日请求数量有限。 要永久访问具有慷慨每日限额的免费模型，您需要购买至少 10 美元的积分 一次. 查看更多详细信息 OpenRouter 常见问题解答页面. 创建一个 OpenRouter 帐户： 开放路由器.ai OpenRouter 型号列表 从上到下（见上图）： 选择“聊天补全”API。 选择 OpenRouter 作为源。 单击“授权”以使用 OAuth 流程获取密钥。或者，生成 API 密钥 这里 并将其粘贴到框中。 单击“连接”并选择型号。 （可选）使用“测试消息”按钮来验证您的连接。",
      "translationStatus": "machine-draft"
    },
    {
      "slug": "api-connections/dreamgen",
      "title": "DreamGen",
      "group": "API_Connections",
      "order": 0,
      "source": "Usage/API_Connections/DreamGen.md",
      "sourceUrl": "https://docs.sillytavern.app/usage/api-connections/dreamgen/",
      "sourceSha256": "c5cfacf2506b3ecd5216286199f6d3519f80f899a8e55b521e471c887084b8d1",
      "headings": [
        {
          "id": "dreamgen",
          "depth": 1,
          "title": "DreamGen"
        },
        {
          "id": "connecting-to-dreamgen",
          "depth": 2,
          "title": "连接到 DreamGen"
        },
        {
          "id": "get-api-key",
          "depth": 3,
          "title": "获取API密钥"
        },
        {
          "id": "connect",
          "depth": 3,
          "title": "连接"
        },
        {
          "id": "models",
          "depth": 2,
          "title": "型号"
        },
        {
          "id": "settings",
          "depth": 2,
          "title": "设置"
        },
        {
          "id": "faq",
          "depth": 2,
          "title": "常见问题"
        },
        {
          "id": "how-can-i-make-the-responses-longer-or-shorter",
          "depth": 3,
          "title": "如何使回复更长或更短？"
        },
        {
          "id": "how-can-i-steer-the-role-play--story",
          "depth": 3,
          "title": "我如何引导角色扮演/故事？"
        }
      ],
      "content": "# DreamGen\n\nDreamGen 是一款用于人工智能驱动的角色扮演和故事写作的应用程序和 API。他们有免费套餐和付费订阅，允许每月无限制地访问专门用于可操纵的人工智能角色扮演和故事写作目的的高质量内部文本生成模型。创建一个帐户以开始： <https://dreamgen.com/>.\n\n（免费）积分会在每个日历月开始时重置。参见 [定价](https://dreamgen.com/pricing) 查看每个模型的信用成本以及 [用途](https://dreamgen.com/account/usage) 查看您的剩余积分。\n\n## 连接到 DreamGen\n\n### 获取API密钥\n\n前往 [DreamGen API 密钥](https://dreamgen.com/account/api-keys) 页面并单击“新 API 密钥”按钮。确保 API 密钥已复制到剪贴板中。\n\n![创建新的 DreamGen API 密钥](/docs/sillytavern/static/dreamgen/dreamgen_api_keys_new.jpg)\n![复制 DreamGen API 密钥](/docs/sillytavern/static/dreamgen/dreamgen_api_keys_copy.jpg)\n\n### 连接\n\n1. 转至 SillyTavern 连接设置。\n2. 选择API：文本补全\n3. 选择 API 类型：DreamGen\n4. 输入 API 密钥\n5. （可选）选择型号\n\n![连接到 DreamGen](/docs/sillytavern/static/dreamgen/dreamgen_st_connection.png)\n\n## 型号\n\nDreamGen API 提供了多种不同尺寸的模型。\n\n- Lucid Max（在 API 中称为 `lucid-v1-max` 或 `lucid-v1-extra-large`)\n- Lucid Base（在 API 中称为 `lucid-v1-base` 或 `lucid-v1-medium`) -- 对应于可用重量 [清醒 V1 尼莫](https://dreamgen.com/docs/models/lucid-v1/huggingface).\n\nLucid Base 使用的积分更少且速度更快，而 Lucid Max 更具创造力，能够处理更复杂的指令和叙述。\n\n## 设置\n\nLucid V1 DreamGen 模型使用 Llama 3 聊天模板的扩展，针对角色扮演和写作进行了优化。它们与特定系统提示词配合使用效果最佳。\n\n我们强烈建议从以下主预设之一开始：\n\n- 确保您已启用指令模式并在导入时选中所有复选框。\n- [DreamGen Lucid V1 角色扮演预设](https://dreamgen.com/docs/models/lucid-v1/sillytavern/master-preset/role-play)\n- [DreamGen Lucid V1 故事预设](https://dreamgen.com/docs/models/lucid-v1/sillytavern/master-preset/story)\n\n这些预设带有内置支持 `/sys` 向模型发送指令。您可以使用它们来引导情节或控制角色的行动。\n\n![已选择 DreamGen 预设](/docs/sillytavern/static/dreamgen/dreamgen_st_preset.png)\n\n其他资源：\n\n- [**详细的 DreamGen + SillyTavern 指南**](https://dreamgen.com/docs/models/lucid-v1/sillytavern)\n- [Lucid V1 提示词格式详细文档](https://dreamgen.com/docs/models/lucid-v1).\n- [DreamGen + SillyTavern 角色扮演演示](https://imgur.com/a/dreamgen-lucid-sillytavern-roleplay-demo-bhzQpto)\n- [DreamGen + SillyTavern 故事编写演示](https://imgur.com/a/dreamgen-lucid-sillytavern-writing-demo-JLv5iO3)\n- [制作自己的场景的技巧](https://v2.dreamgen.com/docs/scenario-editor)\n\n## 常见问题\n\n### 如何使回复更长或更短？\n\n您可以设置 `Last Assistant Prefix` 在您的格式预设中。\n\n对于长消息：\n\n```txt\n<|start_header_id|>user<|end_header_id|>\n\nThe next message is from {{char}} and is at least 100 words long<|eot_id|><|start_header_id|>writer character {{char}}<|end_header_id|>\n\n```\n\n对于短信：\n\n```txt\n<|start_header_id|>user<|end_header_id|>\n\nThe next message is from {{char}} and is at most 50 words long<|eot_id|><|start_header_id|>writer character {{char}}<|end_header_id|>\n\n```\n\n确保保留所有换行符，包括末尾的两个换行符。\n\n![长消息前缀](/docs/sillytavern/static/dreamgen/dreamgen_st_long_response_prefix.png)\n\n您还可以在卡片或系统提示词中包含书写风格描述，例如：\n\n```txt\n## Style\n\n<your description>\n```\n\n请参阅 [“风格”文档](https://v2.dreamgen.com/docs/scenario-editor#style) 了解更多信息并查看一些示例。\n\n### 我如何引导角色扮演/故事？\n\n使用 `/sys` 向模型发送指令的选项。一些例子：\n\n> 旅店老板给达莉亚和其他人提供了一品脱啤酒。\n\n> 下一条消息来自 Draco，应该至少有 200 个字，重点是他对这个决定的内心冲突。\n\n[看看它的实际效果。](https://imgur.com/a/dreamgen-lucid-sillytavern-roleplay-demo-bhzQpto)\n",
      "searchText": "DreamGen DreamGen 是一款用于人工智能驱动的角色扮演和故事写作的应用程序和 API。他们有免费套餐和付费订阅，允许每月无限制地访问专门用于可操纵的人工智能角色扮演和故事写作目的的高质量内部文本生成模型。创建一个帐户以开始： https://dreamgen.com/. （免费）积分会在每个日历月开始时重置。参见 定价 查看每个模型的信用成本以及 用途 查看您的剩余积分。 连接到 DreamGen 获取API密钥 前往 DreamGen API 密钥 页面并单击“新 API 密钥”按钮。确保 API 密钥已复制到剪贴板中。 连接 转至 SillyTavern 连接设置。 选择API：文本补全 选择 API 类型：DreamGen 输入 API 密钥 （可选）选择型号 型号 DreamGen API 提供了多种不同尺寸的模型。 Lucid Max（在 API 中称为 lucid-v1-max 或 lucid-v1-extra-large) Lucid Base（在 API 中称为 lucid-v1-base 或 lucid-v1-medium) -- 对应于可用重量 清醒 V1 尼莫. Lucid Base 使用的积分更少且速度更快，而 Lucid Max 更具创造力，能够处理更复杂的指令和叙述。 设置 Lucid V1 DreamGen 模型使用 Llama 3 聊天模板的扩展，针对角色扮演和写作进行了优化。它们与特定系统提示词配合使用效果最佳。 我们强烈建议从以下主预设之一开始： 确保您已启用指令模式并在导入时选中所有复选框。 DreamGen Lucid V1 角色扮演预设 DreamGen Lucid V1 故事预设 这些预设带有内置支持 /sys 向模型发送指令。您可以使用它们来引导情节或控制角色的行动。 其他资源： 详细的 DreamGen + SillyTavern 指南 Lucid V1 提示词格式详细文档. DreamGen + SillyTavern 角色扮演演示 DreamGen + SillyTavern 故事编写演示 制作自己的场景的技巧 常见问题 如何使回复更长或更短？ 您可以设置 Last Assistant Prefix 在您的格式预设中。 对于长消息： <|start_header_id|>user<|end_header_id|> The next message is from {{char}} and is at least 100 words long<|eot_id|><|start_header_id|>writer character {{char}}<|end_header_id|> 对于短信： <|start_header_id|>user<|end_header_id|> The next message is from {{char}} and is at most 50 words long<|eot_id|><|start_header_id|>writer character {{char}}<|end_header_id|> 确保保留所有换行符，包括末尾的两个换行符。 您还可以在卡片或系统提示词中包含书写风格描述，例如： ## Style <your description> 请参阅 “风格”文档 了解更多信息并查看一些示例。 我如何引导角色扮演/故事？ 使用 /sys 向模型发送指令的选项。一些例子： 旅店老板给达莉亚和其他人提供了一品脱啤酒。 下一条消息来自 Draco，应该至少有 200 个字，重点是他对这个决定的内心冲突。 看看它的实际效果。",
      "translationStatus": "machine-draft"
    },
    {
      "slug": "api-connections/google",
      "title": "Google AI Studio",
      "group": "API_Connections",
      "order": 0,
      "source": "Usage/API_Connections/google.md",
      "sourceUrl": "https://docs.sillytavern.app/usage/api-connections/google/",
      "sourceSha256": "52b7490c1cb1801dfdb9d2ed4b8cf515bdd86360c0c191fdba4fe881c2cc10c1",
      "headings": [
        {
          "id": "google-gemini",
          "depth": 1,
          "title": "Google AI Studio"
        },
        {
          "id": "google-ai-studio",
          "depth": 2,
          "title": "谷歌人工智能工作室"
        },
        {
          "id": "step-1-create-a-google-ai-studio-key",
          "depth": 3,
          "title": "第 1 步：创建 Google AI Studio 密钥"
        },
        {
          "id": "step-2-put-the-api-key-into-sillytavern",
          "depth": 3,
          "title": "步骤2：将API Key放入SillyTavern"
        },
        {
          "id": "google-vertex-ai",
          "depth": 2,
          "title": "谷歌顶点人工智能"
        },
        {
          "id": "service-account",
          "depth": 3,
          "title": "服务帐号"
        },
        {
          "id": "step-1-enable-the-vertex-ai-api",
          "depth": 4,
          "title": "第 1 步：启用 Vertex AI API"
        },
        {
          "id": "step-2-create-the-service-account",
          "depth": 4,
          "title": "第 2 步：创建服务帐户"
        },
        {
          "id": "step-3-generate-the-json-key",
          "depth": 4,
          "title": "第 3 步：生成 JSON 密钥"
        },
        {
          "id": "step-4-put-the-json-content-into-sillytavern",
          "depth": 4,
          "title": "步骤4：将JSON内容放入SillyTavern"
        },
        {
          "id": "express-mode",
          "depth": 3,
          "title": "快速模式"
        },
        {
          "id": "step-1-ensure-your-account-is-eligible-for-express-mode",
          "depth": 4,
          "title": "第 1 步：确保您的帐户符合快速模式的条件"
        },
        {
          "id": "step-2-activate-the-vertex-ai-express-mode",
          "depth": 4,
          "title": "步骤 2：激活 Vertex AI Express 模式"
        },
        {
          "id": "step-3-create-an-api-key",
          "depth": 4,
          "title": "第 3 步：创建 API 密钥"
        },
        {
          "id": "step-4-put-the-api-key-into-sillytavern",
          "depth": 4,
          "title": "步骤4：将API Key放入SillyTavern"
        }
      ],
      "content": "# Google AI Studio\n\nGemini 是 Google 的尖端多模式 LLM，可通过多个 API 获得，包括 Google Vertex AI 和 Google AI Studio（以前称为 MakerSuite）。本指南将帮助您在 SillyTavern 中设置 Gemini API 连接。\n\n## 谷歌人工智能工作室\n\nAI Studio 是尝试最新 Google AI 模型的最快、最人性化的方式，无需设置 Google Cloud Platform (GCP) 项目。它提供了一个简单的 API 密钥，您可以使用它来访问 Gemini 模型。\n\n### 第 1 步：创建 Google AI Studio 密钥\n\n1. 前往 [谷歌人工智能工作室](https://aistudio.google.com/apikey) 页面并使用您的 Google 帐户登录。\n2. 单击“获取 API 密钥”，接受条款和条件。\n3. 单击“创建 API 密钥”以生成您的 API 密钥。\n4. 将 API 密钥复制到剪贴板。\n\n### 步骤2：将API Key放入SillyTavern\n\n1. 在SillyTavern中，转到“API连接”页面。\n2. 选择“聊天补全”作为 API 类型。\n3. 从下拉菜单中选择“Google AI Studio”。\n4. 将您之前复制的 API 密钥输入到“API 密钥”文本框中。\n5. 单击“连接”按钮保存密钥。\n\n您现在应该能够将 Google AI Studio API 与 SillyTavern 结合使用。\n\n## 谷歌顶点人工智能\n\nVertex AI 是 Google Cloud Platform (GCP) 提供的一项服务。它提供对各种人工智能模型的访问，包括 Gemini 系列。\n\n设置 Vertex AI API 的方法有多种，可用的模型可能会根据所使用的方法而有所不同。\n\n### 服务帐号\n\nGoogle Cloud Platform (GCP) 需要服务帐户才能访问 Vertex AI，简单的 API 密钥将不起作用。将从服务帐户 JSON 文件生成 token，然后该文件将用于验证对 Vertex AI API 的请求。\n\n您可以按照以下步骤创建服务帐户：\n\n**先决条件：**\n\n1. 您必须拥有 Google Cloud Platform (GCP) 帐户。\n2. 您必须在您的 GCP 帐户中创建一个项目。\n3. 您必须为该项目启用计费。\n\n#### 第 1 步：启用 Vertex AI API\n\n在您的密钥发挥作用之前，必须为您的项目启用 API。\n\n1. 进入谷歌云控制台： <https://console.cloud.google.com/>\n2. 确保在顶部栏中选择了正确的项目。\n3. 导航至 Vertex AI API 页面： <https://console.cloud.google.com/apis/library/aiplatform.googleapis.com>\n4. 如果尚未启用，请单击“启用”按钮。\n\n#### 第 2 步：创建服务帐户\n\n这是将用于访问 Vertex AI API 的身份。\n\n1. 在 Google Cloud Console 中，导航到“服务帐户”页面。您可以在顶部搜索栏中搜索它或使用此直接链接： <https://console.cloud.google.com/iam-admin/serviceaccounts>\n2. 选择您的 GCP 项目，然后点击“+ 创建服务帐户”。\n3. 服务帐户名称：为其指定一个描述性名称，例如 `my-vertex-ai-client`.\n4. 单击“创建并继续”。\n5. 授予此服务帐户对项目的访问权限：在“角色”下拉列表中，搜索并选择 Vertex AI User。此角色授予运行模型所需的权限，而不会放弃太多访问权限。\n6. 单击“继续”，然后单击“完成”。\n\n#### 第 3 步：生成 JSON 密钥\n\n这是您需要的“密码”文件。它包含敏感信息，因此请勿共享或上传到任何公开的地方。\n\n1. 您现在应该回到服务帐户列表。找到您刚刚创建的帐户（例如，sillytavern-vertex-ai）。\n2. 单击该行最右侧的三点菜单 (⋮)，然后选择“管理密钥”。\n3. 单击“添加密钥”->“创建新密钥”。\n4. 确保密钥类型设置为 JSON。\n5. 单击“创建”。\n\n.json 文件将立即下载到您的计算机。请妥善保管，因为此密钥一旦丢失将无法恢复。\n\n#### 步骤4：将JSON内容放入SillyTavern\n\n您下载的 JSON 文件包含使用 Vertex AI API 进行身份验证所需的所有信息。它看起来像这样：\n\n```json\n{\n    \"type\": \"service_account\",\n    \"project_id\": \"your-gcp-project-name\",\n    \"private_key_id\": \"...\",\n    \"private_key\": \"-----BEGIN PRIVATE KEY-----\\n...\\n-----END PRIVATE KEY-----\\n\",\n    \"client_email\": \"sillytavern-vertex-ai@your-gcp-project-name.iam.gserviceaccount.com\",\n    \"client_id\": \"...\",\n    \"auth_uri\": \"https://accounts.google.com/o/oauth2/auth\",\n    \"token_uri\": \"https://oauth2.googleapis.com/token\",\n    \"auth_provider_x509_cert_url\": \"https://www.googleapis.com/oauth2/v1/certs\",\n    \"client_x509_cert_url\": \"...\"\n}\n```\n\n1. 使用简单的文本编辑器（例如 Windows 上的记事本、Mac 上的 TextEdit 或 VS Code）打开刚刚下载的 .json 文件。\n2. 选择文件中的所有文本（Ctrl+A 或 Cmd+A）。\n3. 将文本复制到剪贴板（Ctrl+C 或 Cmd+C）。\n4. 在 SillyTavern 中，转到“API 连接”页面，选择“聊天补全”作为 API 类型，然后从下拉菜单中选择“Google Vertex AI”。将身份验证方法切换为“服务帐户”。\n5. 将复制的全部内容粘贴到“服务帐户 JSON 内容”文本框中。\n6. 单击“验证 JSON”按钮以确保您复制正确。\n7. 最后，向下滚动并单击 API 设置页面底部的“连接”。\n\n您现在应该能够将 Google Vertex AI API 与 SillyTavern 结合使用。\n\n### 快速模式\n\n快速模式是开始在 Google Cloud 上使用生成式 AI 的最快方式。它允许您使用 Gemini API，而无需设置服务帐户。相反，您可以直接使用 API 密钥。\n\n更多详情请参见官方文档： [快速模式下的 Vertex AI 概述](https://cloud.google.com/vertex-ai/generative-ai/docs/start/express-mode/overview).\n\n#### 第 1 步：确保您的帐户符合快速模式的条件\n\n您必须拥有之前未用于创建 Google Cloud 项目的 Google 帐户。\n如果您有现有的 Google Cloud 项目（包括免费试用版），则可以为此目的创建一个新项目。\n\n#### 步骤 2：激活 Vertex AI Express 模式\n\n1. 转到以下网页： [顶点人工智能工作室](https://cloud.google.com/generative-ai-studio).\n2. 点击“免费试用”。\n3. 接受条款和条件并使用您的 Google 帐户登录。\n4. 选择您所在的国家/地区，然后单击“同意并免费开始”。等待设置完成。\n\n#### 第 3 步：创建 API 密钥\n\n1. 验证您的 Google Cloud 控制台是否在快速模式下运行。您应该在页面左上角看到一个横幅。\n2. 单击左侧边栏中的“API 密钥”链接。\n3. 单击“创建 API 密钥”按钮。\n4. 将生成一个新的 API 密钥。将此密钥复制到剪贴板。\n\n#### 步骤4：将API Key放入SillyTavern\n\n1. 在SillyTavern中，转到“API连接”页面。\n2. 选择“聊天补全”作为 API 类型。\n3. 从下拉菜单中选择“Google Vertex AI”。\n4. 将身份验证方法切换为“快速模式（API 密钥）”。\n5. 将您之前复制的 API 密钥粘贴到“API 密钥”文本框中。\n6. 单击“连接”按钮保存密钥。\n\n您现在应该能够在快速模式下通过 SillyTavern 使用 Google Vertex AI API。\n",
      "searchText": "Google AI Studio Gemini 是 Google 的尖端多模式 LLM，可通过多个 API 获得，包括 Google Vertex AI 和 Google AI Studio（以前称为 MakerSuite）。本指南将帮助您在 SillyTavern 中设置 Gemini API 连接。 谷歌人工智能工作室 AI Studio 是尝试最新 Google AI 模型的最快、最人性化的方式，无需设置 Google Cloud Platform (GCP) 项目。它提供了一个简单的 API 密钥，您可以使用它来访问 Gemini 模型。 第 1 步：创建 Google AI Studio 密钥 前往 谷歌人工智能工作室 页面并使用您的 Google 帐户登录。 单击“获取 API 密钥”，接受条款和条件。 单击“创建 API 密钥”以生成您的 API 密钥。 将 API 密钥复制到剪贴板。 步骤2：将API Key放入SillyTavern 在SillyTavern中，转到“API连接”页面。 选择“聊天补全”作为 API 类型。 从下拉菜单中选择“Google AI Studio”。 将您之前复制的 API 密钥输入到“API 密钥”文本框中。 单击“连接”按钮保存密钥。 您现在应该能够将 Google AI Studio API 与 SillyTavern 结合使用。 谷歌顶点人工智能 Vertex AI 是 Google Cloud Platform (GCP) 提供的一项服务。它提供对各种人工智能模型的访问，包括 Gemini 系列。 设置 Vertex AI API 的方法有多种，可用的模型可能会根据所使用的方法而有所不同。 服务帐号 Google Cloud Platform (GCP) 需要服务帐户才能访问 Vertex AI，简单的 API 密钥将不起作用。将从服务帐户 JSON 文件生成 token，然后该文件将用于验证对 Vertex AI API 的请求。 您可以按照以下步骤创建服务帐户： 先决条件： 您必须拥有 Google Cloud Platform (GCP) 帐户。 您必须在您的 GCP 帐户中创建一个项目。 您必须为该项目启用计费。 第 1 步：启用 Vertex AI API 在您的密钥发挥作用之前，必须为您的项目启用 API。 进入谷歌云控制台： https://console.cloud.google.com/ 确保在顶部栏中选择了正确的项目。 导航至 Vertex AI API 页面： https://console.cloud.google.com/apis/library/aiplatform.googleapis.com 如果尚未启用，请单击“启用”按钮。 第 2 步：创建服务帐户 这是将用于访问 Vertex AI API 的身份。 在 Google Cloud Console 中，导航到“服务帐户”页面。您可以在顶部搜索栏中搜索它或使用此直接链接： https://console.cloud.google.com/iam-admin/serviceaccounts 选择您的 GCP 项目，然后点击“+ 创建服务帐户”。 服务帐户名称：为其指定一个描述性名称，例如 my-vertex-ai-client. 单击“创建并继续”。 授予此服务帐户对项目的访问权限：在“角色”下拉列表中，搜索并选择 Vertex AI User。此角色授予运行模型所需的权限，而不会放弃太多访问权限。 单击“继续”，然后单击“完成”。 第 3 步：生成 JSON 密钥 这是您需要的“密码”文件。它包含敏感信息，因此请勿共享或上传到任何公开的地方。 您现在应该回到服务帐户列表。找到您刚刚创建的帐户（例如，sillytavern-vertex-ai）。 单击该行最右侧的三点菜单 (⋮)，然后选择“管理密钥”。 单击“添加密钥”->“创建新密钥”。 确保密钥类型设置为 JSON。 单击“创建”。 .json 文件将立即下载到您的计算机。请妥善保管，因为此密钥一旦丢失将无法恢复。 步骤4：将JSON内容放入SillyTavern 您下载的 JSON 文件包含使用 Vertex AI API 进行身份验证所需的所有信息。它看起来像这样： { \"type\": \"service_account\", \"project_id\": \"your-gcp-project-name\", \"private_key_id\": \"...\", \"private_key\": \"-----BEGIN PRIVATE KEY-----\\n...\\n-----END PRIVATE KEY-----\\n\", \"client_email\": \"sillytavern-vertex-ai@your-gcp-project-name.iam.gserviceaccount.com\", \"client_id\": \"...\", \"auth_uri\": \"https://accounts.google.com/o/oauth2/auth\", \"token_uri\": \"https://oauth2.googleapis.com/token\", \"auth_provider_x509_cert_url\": \"https://www.googleapis.com/oauth2/v1/certs\", \"client_x509_cert_url\": \"...\" } 使用简单的文本编辑器（例如 Windows 上的记事本、Mac 上的 TextEdit 或 VS Code）打开刚刚下载的 .json 文件。 选择文件中的所有文本（Ctrl+A 或 Cmd+A）。 将文本复制到剪贴板（Ctrl+C 或 Cmd+C）。 在 SillyTavern 中，转到“API 连接”页面，选择“聊天补全”作为 API 类型，然后从下拉菜单中选择“Google Vertex AI”。将身份验证方法切换为“服务帐户”。 将复制的全部内容粘贴到“服务帐户 JSON 内容”文本框中。 单击“验证 JSON”按钮以确保您复制正确。 最后，向下滚动并单击 API 设置页面底部的“连接”。 您现在应该能够将 Google Vertex AI API 与 SillyTavern 结合使用。 快速模式 快速模式是开始在 Google Cloud 上使用生成式 AI 的最快方式。它允许您使用 Gemini API，而无需设置服务帐户。相反，您可以直接使用 API 密钥。 更多详情请参见官方文档： 快速模式下的 Vertex AI 概述. 第 1 步：确保您的帐户符合快速模式的条件 您必须拥有之前未用于创建 Google Cloud 项目的 Google 帐户。 如果您有现有的 Google Cloud 项目（包括免费试用版），则可以为此目的创建一个新项目。 步骤 2：激活 Vertex AI Express 模式 转到以下网页： 顶点人工智能工作室. 点击“免费试用”。 接受条款和条件并使用您的 Google 帐户登录。 选择您所在的国家/地区，然后单击“同意并免费开始”。等待设置完成。 第 3 步：创建 API 密钥 验证您的 Google Cloud 控制台是否在快速模式下运行。您应该在页面左上角看到一个横幅。 单击左侧边栏中的“API 密钥”链接。 单击“创建 API 密钥”按钮。 将生成一个新的 API 密钥。将此密钥复制到剪贴板。 步骤4：将API Key放入SillyTavern 在SillyTavern中，转到“API连接”页面。 选择“聊天补全”作为 API 类型。 从下拉菜单中选择“Google Vertex AI”。 将身份验证方法切换为“快速模式（API 密钥）”。 将您之前复制的 API 密钥粘贴到“API 密钥”文本框中。 单击“连接”按钮保存密钥。 您现在应该能够在快速模式下通过 SillyTavern 使用 Google Vertex AI API。",
      "translationStatus": "machine-draft"
    },
    {
      "slug": "api-connections/horde",
      "title": "AI Horde",
      "group": "API_Connections",
      "order": 0,
      "source": "Usage/API_Connections/horde.md",
      "sourceUrl": "https://docs.sillytavern.app/usage/api-connections/horde/",
      "sourceSha256": "550ac4e6461c4e88d1fbb5c10f5d312d5fcbbbdb909bd0fb4e9d2c3d7ec475b6",
      "headings": [
        {
          "id": "ai-horde",
          "depth": 1,
          "title": "AI Horde"
        },
        {
          "id": "disclaimer",
          "depth": 2,
          "title": "免责声明"
        },
        {
          "id": "setup",
          "depth": 2,
          "title": "设置"
        },
        {
          "id": "tips",
          "depth": 2,
          "title": "温馨提示"
        }
      ],
      "content": "# AI Horde\n\n## 免责声明\n\n- AI Horde 是一个完全由志愿者运行的众包分布式 GPU 集群。\n- 默认情况下，您的输入是匿名发送的，运行部落工人的人无法看到响应。\n- 然而，由于它是一个开源程序，恶意工作者可以将代码修改为：\n  - 记录您的活动（输入提示词，AI 响应）。\n  - 产生不良或冒犯性的反应。\n\n> 使用部落时 **从不发送** 任何个人信息，例如姓名、电子邮件地址等。\n\n启用“仅受信任的工作人员”复选框会将可用工作人员的选择限制为仅那些已经在 Horde 上托管一段时间并且通常被认为受信任的工作人员。但他们仍然可能会看到提示词，例如通过使用未记名的软件进行托管。\n\n为了帮助减少这个问题，SillyTavern内置了以下功能：\n\n- 当部落工人生成聊天响应时，SillyTavern 会记录工人的 ID 以及他们使用的模型。\n- 将鼠标光标悬停在聊天项目上即可查看此信息（见下图）。\n- 如果您认为您收到了恶意回复，您可以将此信息传递给部落管理员 [AI部落不和谐](https://discord.gg/3DxrhksKzn) 对该工人进行审查和可能的纪律处分。\n\n![部落工人信息弹出窗口](/docs/sillytavern/static/horde-worker.png)\n\n## 设置\n\n- SillyTavern 能够开箱即用地与 Horde 连接，无需额外设置。\n- 从 ST API 面板的 API 下拉选择器中选择“AI Horde”。\n- 从面板底部的模型选择器中选择一个或多个模型（角色的“AI 大脑”）。\n- 选择角色并开始聊天。\n\n![ST Kobold Horde API 连接面板](/docs/sillytavern/static/horde-config.png)\n\n> 默认情况下，您的 SillyTavern 实例连接到部落的低优先级“来宾帐户”。\n> 这意味着您可能需要等待很长时间才能得到回复。\n> 要减少等待时间，请遵循下面的提示。\n\n## 温馨提示\n\n- [在部落网站上注册一个帐户](https://aihorde.net/register) 然后将您的 Horde 密钥添加到 SillyTavern Horde API 密钥框中。\n- [设置部落工人](https://github.com/Haidra-Org/AI-Horde-Worker#readme) 为其他人提供您的 GPU。\n  - 让其他人使用您的 GPU 将为您带来收益 [“Kudos”，一种部落专用货币](https://github.com/Haidra-Org/AI-Horde/blob/main/FAQ.md#kudos).\n  - 您的帐户获得的荣誉越多，您获得其他部落工人的聊天回复的速度就越快。\n  - Kudos 还可用于创建 AI 图像 [稳定的部落](https://stablehorde.net).\n    - SillyTavern 支持开箱即用的稳定部落图像生成。\n- 如果您的 GPU 不够强大，无法运行人工智能，或者您没有计算机，您仍然可以 [参与部落社区，以各种方式赢得荣誉](https://github.com/Haidra-Org/AI-Horde/blob/main/FAQ.md#i-dont-have-a-powerful-gpu-how-can-i-get-kudos).\n",
      "searchText": "AI Horde 免责声明 AI Horde 是一个完全由志愿者运行的众包分布式 GPU 集群。 默认情况下，您的输入是匿名发送的，运行部落工人的人无法看到响应。 然而，由于它是一个开源程序，恶意工作者可以将代码修改为： 记录您的活动（输入提示词，AI 响应）。 产生不良或冒犯性的反应。 使用部落时 从不发送 任何个人信息，例如姓名、电子邮件地址等。 启用“仅受信任的工作人员”复选框会将可用工作人员的选择限制为仅那些已经在 Horde 上托管一段时间并且通常被认为受信任的工作人员。但他们仍然可能会看到提示词，例如通过使用未记名的软件进行托管。 为了帮助减少这个问题，SillyTavern内置了以下功能： 当部落工人生成聊天响应时，SillyTavern 会记录工人的 ID 以及他们使用的模型。 将鼠标光标悬停在聊天项目上即可查看此信息（见下图）。 如果您认为您收到了恶意回复，您可以将此信息传递给部落管理员 AI部落不和谐 对该工人进行审查和可能的纪律处分。 设置 SillyTavern 能够开箱即用地与 Horde 连接，无需额外设置。 从 ST API 面板的 API 下拉选择器中选择“AI Horde”。 从面板底部的模型选择器中选择一个或多个模型（角色的“AI 大脑”）。 选择角色并开始聊天。 默认情况下，您的 SillyTavern 实例连接到部落的低优先级“来宾帐户”。 这意味着您可能需要等待很长时间才能得到回复。 要减少等待时间，请遵循下面的提示。 温馨提示 在部落网站上注册一个帐户 然后将您的 Horde 密钥添加到 SillyTavern Horde API 密钥框中。 设置部落工人 为其他人提供您的 GPU。 让其他人使用您的 GPU 将为您带来收益 “Kudos”，一种部落专用货币. 您的帐户获得的荣誉越多，您获得其他部落工人的聊天回复的速度就越快。 Kudos 还可用于创建 AI 图像 稳定的部落. SillyTavern 支持开箱即用的稳定部落图像生成。 如果您的 GPU 不够强大，无法运行人工智能，或者您没有计算机，您仍然可以 参与部落社区，以各种方式赢得荣誉.",
      "translationStatus": "machine-draft"
    },
    {
      "slug": "api-connections/koboldcpp",
      "title": "KoboldCpp",
      "group": "API_Connections",
      "order": 0,
      "source": "Usage/API_Connections/koboldcpp.md",
      "sourceUrl": "https://docs.sillytavern.app/usage/api-connections/koboldcpp/",
      "sourceSha256": "5e1c727c0284fd0a74819debec83ab28ad1cb221099e25e8f0ca95f59cad1117",
      "headings": [
        {
          "id": "koboldcpp",
          "depth": 1,
          "title": "KoboldCpp"
        },
        {
          "id": "nvidia-gpu-quickstart",
          "depth": 2,
          "title": "Nvidia GPU 快速入门"
        },
        {
          "id": "gpu-layers",
          "depth": 3,
          "title": "GPU层"
        }
      ],
      "content": "# KoboldCpp\n\nKoboldCpp 是用于 GGML 和 GGUF 模型的独立 API。\n\n这个 [显存计算器](https://huggingface.co/spaces/NyxKrage/LLM-Model-VRAM-Calculator) 由 Nyx 制作，可以告诉你模型大致需要多少内存 / 显存。\n\n## Nvidia GPU 快速入门\n\n本指南假设您使用的是 Windows。\n\n- 下载最新版本： <https://github.com/LostRuins/koboldcpp/releases>\n- 启动 KoboldCpp。您可能会看到 Microsoft Defender 的弹出窗口，单击 `Run Anyway`.\n- 从版本 1.58 开始，KoboldCpp 应该如下所示：\n\n![狗头人Cpp 1.58](/docs/sillytavern/static/koboldcpp.png)\n\n- 下 `Quick Launch` 选项卡，选择型号和您的首选 `Context Size`.\n- 选择 `Use CuBLAS` 并确保旁边的黄色文本 `GPU ID` 与您的 GPU 匹配。\n- 不要勾选 `Low VRAM`，即使您的 VRAM 较低。\n- 除非您有 Nvidia 10 系列或更旧的 GPU，否则请取消选中 `Use QuantMatMul (mmq)`.\n- `GPU Layers` 当您加载模型时应该已填充。暂时将其留在那里。\n- 下 `Hardware` 选项卡，勾选 `High Priority`.\n- 点击 `Save` 因此您不必在每次启动时配置 KoboldCpp。\n- 点击 `Launch` 并等待模型加载。\n\n你应该看到这样的东西：\n\n```txt\nLoad Model OK: True\nEmbedded Kobold Lite loaded.\nStarting Kobold API on port 5001 at http://localhost:5001/api/\nStarting OpenAI Compatible API on port 5001 at http://localhost:5001/v1/\n======\nPlease connect to custom endpoint at http://localhost:5001\n```\n\n您现在可以使用 SillyTavern 连接到 KoboldCpp `http://localhost:5001` 作为 API URL 并开始聊天。\n\n**恭喜！你完成了！**\n\n有点。\n\n### GPU层\n\nKoboldCpp 正在运行，但您可以通过确保将尽可能多的层卸载到 GPU 来提高性能。您应该在终端中看到类似这样的内容：\n\n```txt\nllm_load_tensors: offloading 9 repeating layers to GPU\nllm_load_tensors: offloaded 9/33 layers to GPU\nllm_load_tensors:        CPU buffer size = 25215.88 MiB\nllm_load_tensors:      CUDA0 buffer size =  7043.34 MiB\n....................................................................................................\nllama_kv_cache_init:  CUDA_Host KV buffer size =  1479.19 MiB\nllama_kv_cache_init:      CUDA0 KV buffer size =   578.81 MiB\n```\n\n不要害怕数字；这部分比看起来容易。 `CPU buffer size` 指的是正在使用多少系统 RAM。忽略这一点。 `CUDA0 buffer size` 指的是正在使用多少 GPU VRAM。 `CUDA_Host KV buffer size` 和 `CUDA0 KV buffer size` 指的是有多少 GPU VRAM 专用于您的模型上下文。在本例中，KoboldCpp 使用大约 9 GB 的 VRAM。\n\n我有 12 GB 的 VRAM，只有 2 GB 的 VRAM 用于上下文，因此我还剩下大约 10 GB 的 VRAM 来加载模型。因为 9 层使用了大约 7 GB 的 VRAM， `7000 / 9 = 777.77` 我们可以假设每层大约使用 `777.77 MIB` 显存。 `10,000 MIB / 777.77 = 12.8`，所以从现在开始我将使用该模型向下舍入并加载 12 层。\n\n现在使用系统的模型、上下文大小和 VRAM 进行自己的数学计算，然后重新启动 KoboldCpp：\n\n- 如果你很聪明，你就点击了 `Save` 之前，现在你可以加载以前的配置 `Load`。否则，请选择您之前选择的相同设置。\n- 改变 `GPU Layers` 到您新的、VRAM 优化的数字（在我的例子中为 12 层）。\n- 点击 `Save` 保存更新的配置。\n\n您现在应该看到类似这样的内容：\n\n```txt\nllm_load_tensors: offloading 12 repeating layers to GPU\nllm_load_tensors: offloaded 12/33 layers to GPU\nllm_load_tensors:        CPU buffer size = 25215.88 MiB\nllm_load_tensors:      CUDA0 buffer size =  9391.12 MiB\n....................................................................................................\nllama_kv_cache_init:  CUDA_Host KV buffer size =  1286.25 MiB\nllama_kv_cache_init:      CUDA0 KV buffer size =   771.75 MiB\n```\n\nKoboldCpp 使用了我的 12 GB VRAM 中的大约 11.5 GB。这应该比 KoboldCpp 自动生成的设置执行得更好。\n\n**恭喜！你（实际上）完成了！**\n\n要更深入地了解 KoboldCpp 设置，请查看 Kalomaze 的 [简单的 Llama + SillyTavern 设置指南](https://rentry.org/llama_v2_sillytavern).\n",
      "searchText": "KoboldCpp KoboldCpp 是用于 GGML 和 GGUF 模型的独立 API。 这个 显存计算器 由 Nyx 制作，可以告诉你模型大致需要多少内存 / 显存。 Nvidia GPU 快速入门 本指南假设您使用的是 Windows。 下载最新版本： https://github.com/LostRuins/koboldcpp/releases 启动 KoboldCpp。您可能会看到 Microsoft Defender 的弹出窗口，单击 Run Anyway. 从版本 1.58 开始，KoboldCpp 应该如下所示： 下 Quick Launch 选项卡，选择型号和您的首选 Context Size. 选择 Use CuBLAS 并确保旁边的黄色文本 GPU ID 与您的 GPU 匹配。 不要勾选 Low VRAM，即使您的 VRAM 较低。 除非您有 Nvidia 10 系列或更旧的 GPU，否则请取消选中 Use QuantMatMul (mmq). GPU Layers 当您加载模型时应该已填充。暂时将其留在那里。 下 Hardware 选项卡，勾选 High Priority. 点击 Save 因此您不必在每次启动时配置 KoboldCpp。 点击 Launch 并等待模型加载。 你应该看到这样的东西： Load Model OK: True Embedded Kobold Lite loaded. Starting Kobold API on port 5001 at http://localhost:5001/api/ Starting OpenAI Compatible API on port 5001 at http://localhost:5001/v1/ ====== Please connect to custom endpoint at http://localhost:5001 您现在可以使用 SillyTavern 连接到 KoboldCpp http://localhost:5001 作为 API URL 并开始聊天。 恭喜！你完成了！ 有点。 GPU层 KoboldCpp 正在运行，但您可以通过确保将尽可能多的层卸载到 GPU 来提高性能。您应该在终端中看到类似这样的内容： llm_load_tensors: offloading 9 repeating layers to GPU llm_load_tensors: offloaded 9/33 layers to GPU llm_load_tensors: CPU buffer size = 25215.88 MiB llm_load_tensors: CUDA0 buffer size = 7043.34 MiB .................................................................................................... llama_kv_cache_init: CUDA_Host KV buffer size = 1479.19 MiB llama_kv_cache_init: CUDA0 KV buffer size = 578.81 MiB 不要害怕数字；这部分比看起来容易。 CPU buffer size 指的是正在使用多少系统 RAM。忽略这一点。 CUDA0 buffer size 指的是正在使用多少 GPU VRAM。 CUDA_Host KV buffer size 和 CUDA0 KV buffer size 指的是有多少 GPU VRAM 专用于您的模型上下文。在本例中，KoboldCpp 使用大约 9 GB 的 VRAM。 我有 12 GB 的 VRAM，只有 2 GB 的 VRAM 用于上下文，因此我还剩下大约 10 GB 的 VRAM 来加载模型。因为 9 层使用了大约 7 GB 的 VRAM， 7000 / 9 = 777.77 我们可以假设每层大约使用 777.77 MIB 显存。 10,000 MIB / 777.77 = 12.8，所以从现在开始我将使用该模型向下舍入并加载 12 层。 现在使用系统的模型、上下文大小和 VRAM 进行自己的数学计算，然后重新启动 KoboldCpp： 如果你很聪明，你就点击了 Save 之前，现在你可以加载以前的配置 Load。否则，请选择您之前选择的相同设置。 改变 GPU Layers 到您新的、VRAM 优化的数字（在我的例子中为 12 层）。 点击 Save 保存更新的配置。 您现在应该看到类似这样的内容： llm_load_tensors: offloading 12 repeating layers to GPU llm_load_tensors: offloaded 12/33 layers to GPU llm_load_tensors: CPU buffer size = 25215.88 MiB llm_load_tensors: CUDA0 buffer size = 9391.12 MiB .................................................................................................... llama_kv_cache_init: CUDA_Host KV buffer size = 1286.25 MiB llama_kv_cache_init: CUDA0 KV buffer size = 771.75 MiB KoboldCpp 使用了我的 12 GB VRAM 中的大约 11.5 GB。这应该比 KoboldCpp 自动生成的设置执行得更好。 恭喜！你（实际上）完成了！ 要更深入地了解 KoboldCpp 设置，请查看 Kalomaze 的 简单的 Llama + SillyTavern 设置指南.",
      "translationStatus": "machine-draft"
    },
    {
      "slug": "api-connections/mancer",
      "title": "Mancer",
      "group": "API_Connections",
      "order": 0,
      "source": "Usage/API_Connections/mancer.md",
      "sourceUrl": "https://docs.sillytavern.app/usage/api-connections/mancer/",
      "sourceSha256": "2b78fb188030da8c7f4e279f81d1599423473c2e1c8ffe291a7098a4fc5ceb06",
      "headings": [
        {
          "id": "mancer",
          "depth": 1,
          "title": "Mancer"
        },
        {
          "id": "how-to-get-started",
          "depth": 2,
          "title": "如何开始"
        },
        {
          "id": "anonymous-logging",
          "depth": 2,
          "title": "匿名记录"
        },
        {
          "id": "support",
          "depth": 2,
          "title": "支持"
        }
      ],
      "content": "# Mancer\n\nMancer 是一个大型语言模型推理服务，可让您运行任何您想要的提示词并且不会审查响应。大多数模型都需要预加载余额才能开始聊天，但截至撰写时（2024-11-28）有一个免费模型。\n\n- [型号](https://mancer.tech/models)\n- [定价](https://mancer.tech/pricing)\n\n## 如何开始\n\n1. 注册一个帐户： [曼瑟科技](https://mancer.tech/).\n\n2. 单击仪表板并复制您的 API 密钥。\n\n   ![截至 2024 年 2 月 27 日的 Mancer 仪表板](/docs/sillytavern/static/mancer-dashboard.png)\n\n3. 在 SillyTavern 中，选择文本补全 API，然后在 API 类型下选择 Mancer。\n\n4. 输入您的 Mancer API 密钥并单击“连接”。\n\n![API密钥](/docs/sillytavern/static/mancer-key.png)\n\n您现在应该能够与您选择的任何 Mancer 模型聊天。\n\n## 匿名记录\n\n如果您不介意您的聊天可能被用于训练模型、改进 Mancer 的服务、发布数据集或 *无论如何* 他们可能会决定这样做，您可以选择匿名登录，并在特定型号上享受 25% token 折扣。只需前往您的 [曼瑟仪表板](https://mancer.tech/dashboard.html) 并勾选 `Enable Anon. Logging`.\n\n## 支持\n\n还需要帮助吗？前往 [#曼瑟](https://discord.gg/Ze9UyNu3) SillyTavern Discord 上的支持频道。\n",
      "searchText": "Mancer Mancer 是一个大型语言模型推理服务，可让您运行任何您想要的提示词并且不会审查响应。大多数模型都需要预加载余额才能开始聊天，但截至撰写时（2024-11-28）有一个免费模型。 型号 定价 如何开始 注册一个帐户： 曼瑟科技. 单击仪表板并复制您的 API 密钥。 在 SillyTavern 中，选择文本补全 API，然后在 API 类型下选择 Mancer。 输入您的 Mancer API 密钥并单击“连接”。 您现在应该能够与您选择的任何 Mancer 模型聊天。 匿名记录 如果您不介意您的聊天可能被用于训练模型、改进 Mancer 的服务、发布数据集或 无论如何 他们可能会决定这样做，您可以选择匿名登录，并在特定型号上享受 25% token 折扣。只需前往您的 曼瑟仪表板 并勾选 Enable Anon. Logging. 支持 还需要帮助吗？前往 #曼瑟 SillyTavern Discord 上的支持频道。",
      "translationStatus": "machine-draft"
    },
    {
      "slug": "api-connections/novelai",
      "title": "NovelAI",
      "group": "API_Connections",
      "order": 0,
      "source": "Usage/API_Connections/novelai.md",
      "sourceUrl": "https://docs.sillytavern.app/usage/api-connections/novelai/",
      "sourceSha256": "7a7ea5e2f65668b39979ea486ea3b24a0493eb2a0298669254a3d2a25c05ba1e",
      "headings": [
        {
          "id": "novelai",
          "depth": 1,
          "title": "NovelAI"
        },
        {
          "id": "api-key",
          "depth": 2,
          "title": "API密钥"
        },
        {
          "id": "models",
          "depth": 2,
          "title": "型号"
        },
        {
          "id": "settings",
          "depth": 2,
          "title": "设置"
        },
        {
          "id": "response-length",
          "depth": 3,
          "title": "响应长度"
        },
        {
          "id": "context-size",
          "depth": 3,
          "title": "上下文大小"
        },
        {
          "id": "preamble",
          "depth": 3,
          "title": "序言"
        },
        {
          "id": "preset-descriptions",
          "depth": 2,
          "title": "预设说明"
        },
        {
          "id": "erato",
          "depth": 3,
          "title": "埃拉托"
        },
        {
          "id": "kayra",
          "depth": 3,
          "title": "凯拉"
        },
        {
          "id": "clio",
          "depth": 3,
          "title": "克里奥"
        },
        {
          "id": "tips-and-faqs-for-using-novelai-with-sillytavern",
          "depth": 2,
          "title": "将 NovelAI 与 SillyTavern 结合使用的提示和常见问题解答"
        },
        {
          "id": "tweaking-settings-for-novelai",
          "depth": 3,
          "title": "调整 NovelAI 的设置"
        },
        {
          "id": "buildingadapting-character-cards-for-novelai",
          "depth": 3,
          "title": "为 NovelAI 构建/调整角色卡"
        },
        {
          "id": "example-cards",
          "depth": 4,
          "title": "示例卡"
        },
        {
          "id": "what-not-to-do",
          "depth": 4,
          "title": "不该做什么"
        },
        {
          "id": "which-module-should-i-use",
          "depth": 3,
          "title": "我应该使用哪个模块？"
        },
        {
          "id": "not-the-instruct-module",
          "depth": 3,
          "title": "不是指令模块？"
        },
        {
          "id": "why-do-my-responses-keep-getting-cut-off",
          "depth": 3,
          "title": "为什么我的回复总是被打断？"
        },
        {
          "id": "how-do-i-get-the-bot-to-write-longer-responses",
          "depth": 3,
          "title": "如何让机器人写出更长的回复？"
        },
        {
          "id": "how-do-i-get-the-bot-to-stop-talking-for-me",
          "depth": 3,
          "title": "如何让机器人停止为我说话？"
        },
        {
          "id": "why-isnt-my-character-responding",
          "depth": 3,
          "title": "为什么我的角色没有响应？"
        },
        {
          "id": "how-should-i-use-the-authors-note",
          "depth": 3,
          "title": "作者注释应该如何使用？"
        },
        {
          "id": "how-do-i-do-a-scene-breaktime-jump",
          "depth": 3,
          "title": "如何进行场景中断/时间跳跃？"
        },
        {
          "id": "the-ai-keeps-repeating-specific-wordsphrases-what-do-i-do",
          "depth": 3,
          "title": "AI 不断重复特定的单词/短语，我该怎么办？"
        }
      ],
      "content": "# NovelAI\n\nNovelAI 是一项付费订阅服务，允许每月无限制地访问其高质量的内部文本生成、图像生成和文本转语音模型。在此注册帐户以开始： <https://novelai.net/>\n\n你只会得到 *50代* 免费评估模型。当 **“不符合此型号的条件”** 出现错误，这意味着您已经过了试用期，需要订阅付费计划。\n\n## API密钥\n\n要获取您的 NovelAI API 密钥，请按照以下步骤操作：\n\n1. 选择左侧边栏顶部的齿轮图标。\n   ![左侧边栏](/docs/sillytavern/static/novel-side.png)\n\n2. 选择“用户设置”下的“帐户”。\n   ![用户设置](/docs/sillytavern/static/novel-user.png)\n\n3. 选择“获取持久 API 令牌”。\n   ![账户](/docs/sillytavern/static/novel-account.png)\n\n4. 选择复制图标将 NovelAI API token 复制到剪贴板。\n   ![持久 API 令牌](/docs/sillytavern/static/novel-token.png)\n\n## 型号\n\n如果您有 Opus，则可以使用 Erato 模型。如果您没有 Opus，那么 Kayra 是最好的可用型号。\n\nClio 在平板电脑/滚动层上具有更大的上下文大小，但 Kayra 的优势通常可以弥补这一差异。\n\n## 设置\n\n带有设置的文件位于此处（`SillyTavern/data/<user-handle>/NovelAI Settings`）。\n您还可以手动添加自己的设置文件。\n\n### 响应长度\n\n您想要为每条消息生成多少文本。请注意，NovelAI 每个响应的限制为 150 token。\n\n### 上下文大小\n\n在任何给定时间，上下文中保存了多少 token 的聊天内容。您可以使用的最大上下文大小取决于模型和您的订阅层：\n\n- Kayra（平板电脑）- 3072 token\n- 凯拉（卷轴）- 6144 token\n- Erato（Opus 独有）、Kayra（Opus）和 Clio（所有级别）- 8192 token\n\n### 序言\n\n插入聊天正上方以修改书写风格的文本。推荐的格式是短标签列表，例如“\\[风格：聊天、详细、感官]”。\n\n## 预设说明\n\n根据 NovelAI 的说法，这就是默认预设的好处。\n\n### 埃拉托\n\n- 金箭 - 优秀的全能选手。\n- Wilder - 单词选择的多样性更高，重掷之间的差异更大，更容易出错。\n- Zany Scribe - 避免错误和重复。优先考虑更复杂的单词。\n- 火龙果 - 语言多样且复杂，几乎没有重复。错误和矛盾更加频繁。\n- Shosetsu - 专为日语写作而设计。也适用于英语。\n\n### 凯拉\n\n- Asper - 用于创意写作。期待意想不到的曲折。\n- 无忧无虑——优秀的全能选手\n- Fresh-Coffee - 让事情步入正轨。手柄指导良好。\n- Pro_Writer - 模仿畅销小说的节奏和感觉\n- Stelenes - 更有可能选择合理的替代方案。重试的多样性。\n- Tea_Time - 当它开始时它会变得很好。\n- Writers-Daemon - 极其富有想象力，有时甚至太多。\n\n### 克里奥\n\n- Edgewise - 很好地处理各种生成样式\n- 新鲜咖啡 - 让事情步入正轨。\n- 长按 - 用于创意散文。\n- Talker Chat - 专为聊天风格生成而设计。\n- Vingt-Un - 一个良好的全能默认值，偏向于散文。\n\n## 将 NovelAI 与 SillyTavern 结合使用的提示和常见问题解答\n\n从另一个 ST 后端 API 切换到 NovelAI 时，会出现很多常见问题和疑问。差异取决于模型的训练目的。您很可能使用过 OpenAI 或 Anthropic 模型（或类似的本地模型），这些模型是围绕遵循用户的指示构建的。 NovelAI 的模型完全围绕文本完成而构建：NAI 的模型尝试继续传入的提示词，而不是将您的输入作为消息并制定响应。由于这种差异，许多适用于其他 API 的技巧和常识不适用于 NAI。\n\n### 调整 NovelAI 的设置\n\n在高级格式（A 图标）下：\n\n- 将“上下文模板”设置为“NovelAI”\n- 将“Tokenizer”设置为“最佳匹配”\n- 选中“始终将角色的名称添加到提示词”\n- 选中“折叠连续换行符”\n- 取消选中“指令模式”下的“启用”框\n\n在“用户设置”下（有齿轮的人）\n\n- 打开“滑动切换回复”（不是 NAI 特定的，但它非常有用，您应该这样做）\n\n### 为 NovelAI 构建/调整角色卡\n\n为了针对 NovelAI 优化角色卡，有几种推荐的方法来编写角色的描述：散文和属性。\n\n散文太简单了，感觉不太行得通：“西尔菲德是一位看起来很年轻但实际上已经有 900 岁的仙女。她身材矮小，长长的白发在她编成的侧马尾辫中逐渐变成绿色，翠绿的眼睛形状像十字架。\\[...]”不，真的，就是这样。只需用普通句子写出角色的外观、行为等，人工智能就会识别它。\n\n如果您不相信自己的写作能力或者想要一种更结构化的方法来完成它，您可以使用 NovelAI 训练数据中存在的属性方法。这是不同类型的角色特征的简单列表。以下是经过 NovelAI 模型测试有效的可能属性列表：\n\n```\nName:\nAKA:\nType: character\nSetting:\nNationality:\nSpecies:\nGender:\nAge:\nHeight:\nWeight:\nAppearance:\nClothing:\nAttire:\nPersonality:\nMind:\nMental:\nLikes:\nDislikes:\nSexuality:\nSpeech:\nVoice:\nAbilities:\nSkills:\nQuote:\nAffiliation:\nOccupation:\nReputation:\nSecret:\nFamily:\nAllies:\nEnemies:\nBackground:\nDescription:\nAttributes:\n```\n\n“Type: 角色”是用来告诉 AI 这是描述一个角色（而不是位置、物体或其他类型的事物）。其余属性是可选的，有些是多余的（例如，Personality、Mind 和 Mental 的含义基本相同），但这些属性已经过测试并且可以与 NovelAI 的模型配合良好。填写与您的角色相关的内容。属性应以小写形式书写，并用逗号分隔，不需要在单词两边加上引号。例如：\n\n```\nSkills: lockpicking, stealth, running away very fast\n```\n\n推荐使用这些方法是因为它们存在于 NovelAI 的训练数据中，因此它们特别适合模型。\n\n#### 示例卡\n\n这里有几个为 NovelAI 制作的示例卡片，展示了专门为 NovelAI 创建卡片的不同方法。第一张卡“Valka”使用属性方法进行角色描述，而第二张卡“Eris”则使用散文描述，并带有大量示例对话。\n\n<div style=\"display:flex;gap:2em;justify-content:center\">\n\n[![瓦尔卡](/docs/sillytavern/static/Valka.png)](/docs/sillytavern/static/Valka.png)\n\n[![阋神星](/docs/sillytavern/static/Eris.png)](/docs/sillytavern/static/Eris.png)\n\n</div>\n\n#### 不该做什么\n\n大多数现有的角色卡格式都不适合 NovelAI。他们会给你一些结果，甚至一些好的结果，但他们有很多问题。 W++ 是最大的罪犯之一，它与 NovelAI 模型所训练的任何内容都不相同，并且它不断使用括号/大括号/引号消耗了大量的 token，使卡片的大小膨胀而没有真正的好处。\n\n在未融入 NovelAI 的现有格式中，AliChat 是最有可能发挥作用的一种，因为它依赖于使用示例消息来同时获取有关角色及其语音的信息，并采用您希望 AI 输出的消息类型的格式。\n\n对于大多数其他格式，由于它们通常是列出特定角色的不同特征的方法，因此可以相当直接地将它们转换为属性方法。\n\n### 我应该使用哪个模块？\n\n可能没有模块。如果您想让角色以更华丽的方式说话，散文增强器会很有用，但要注意不要做得太过分。文本冒险对于文本冒险风格的卡片/故事可能很有用。\n\n### 不是指令模块？\n\n您可以在需要时调用 Instruct 模块。在消息中创建换行符，并将说明放在大括号中，如下所示： `{ CharName is offended by that seemingly innocuous statement }` （空格是 *必填* 文本和括号之间）。这样做会在短时间内自动将人工智能切换到指令模块。您不想一直使用“指导”模块，因为当您需要强烈引导 AI 朝特定方向发展时，它往往会比其他模块产生更少的创意输出。\n\n### 为什么我的回复总是被打断？\n\nNovelAI 将响应长度限制为总计约 150 token，即使您将滑块设置得更高。当它达到滑块中 token 的数量或 150（以较低者为准）时，它将再生成最多 20 个 token，寻找停止序列或句子结尾，因此响应的有效限制为 170 token，此时它将停止，导致其中断。\n\n如果中断，您可以选择继续选项（在文本框左侧的三行菜单中）让角色继续响应。\n\n如果您经常希望响应长度超过 170 token，您可以像这样解决该限制：\n\n- 将响应长度保持在 150 token。\n- 在“高级格式化”下，启用“自动继续”。\n- 将“目标长度”设置为所需的长度。\n\n这会将多代链接在一起，为您提供更长的消息，但如果模型决定停止，则不能保证回复将是所需长度的 100%。\n\n### 如何让机器人写出更长的回复？\n\n阅读上面有关回复被切断的内容。这将有助于确保响应不会因达到生成长度的限制而过早中断。\n\n如果你的回答没有被切断但仍然太短，那么你可能正在处理“垃圾输入，垃圾输出” - 如果你给模型提供了错误的例子，它会产生错误的输出。如果角色卡没有示例对话或简短的示例对话，并且您发送给机器人的消息很短，则模型会接受这一点，将其视为可接受的做事方式，并且响应也会很短。因此，请向机器人编写更长的示例对话和更长的消息。 （您始终可以使用 NovelAI 为您编写一些示例对话，而不是自己编写。）\n\n### 如何让机器人停止为我说话？\n\n- 检查角色卡的第一条消息和示例对话是否不包括角色为您采取行动 - 如果包括，则重写它们以消除它为您采取行动\n- 确保选中“始终将角色的名称添加到提示词”\n- 确保您当前使用与其余聊天相同的用户用户人设。如果您更改了用户用户人设并且没有更改回来（或者没有将用户人设锁定到该聊天），则停止为您生成的常规规则将失败\n- 将 \\[\"\\n{{user}}:\"] 添加到自定义停止字符串（应该不是必需的，但有时会有所帮助）\n\n### 为什么我的角色没有响应？\n\n造成这种情况的原因有很多，所以我们需要检查以下几个地方：\n\n- 确保在高级格式中选中“始终将角色的名称添加到提示词”\n- 检查以确保 API 没有出现任何错误。虽然您可以通过 NAI 免费试用版使用 SillyTavern，但一旦试用完毕，您就会收到错误消息\n- 检查“自定义停止字符串”中的内容 - 如果这些字符串是在响应开始时生成的，则它可能会被过早切断\n\n### 作者注释应该如何使用？\n\n一般来说，你可能不应该这样做。它被插入到非常接近上下文末尾的位置，并且使用 NAI 的模型，它经常压倒上下文中的其他所有内容。它主要是来自旧的、较弱的模型的产物，在这些模型中它是更必要的。\n\n### 如何进行场景中断/时间跳跃？\n\n将以下内容作为系统消息或放在下一条消息开头的换行符上：\n\n```\n***\n[ 2 days later ]\n```\n\n然后将其余的消息放在下一行。括号内的文本可以是时间跳跃、新位置或其他任何内容。 “\\*\\*\\*”（搞笑地命名为“dinkus”）告诉人工智能场景已经改变，括号内的文本提供了更多背景信息。\n\n### AI 不断重复特定的单词/短语，我该怎么办？\n\n如上所述，您可以将重复惩罚滑块再推高一点，但推得太远可能会导致输出不连贯。\n要更彻底地解决问题，请返回上下文，尤其是最近的消息，并删除重复的单词/短语。将其从上下文中删除可以让人工智能一开始就没有理由开始说它。\n",
      "searchText": "NovelAI NovelAI 是一项付费订阅服务，允许每月无限制地访问其高质量的内部文本生成、图像生成和文本转语音模型。在此注册帐户以开始： https://novelai.net/ 你只会得到 50代 免费评估模型。当 “不符合此型号的条件” 出现错误，这意味着您已经过了试用期，需要订阅付费计划。 API密钥 要获取您的 NovelAI API 密钥，请按照以下步骤操作： 选择左侧边栏顶部的齿轮图标。 选择“用户设置”下的“帐户”。 选择“获取持久 API 令牌”。 选择复制图标将 NovelAI API token 复制到剪贴板。 型号 如果您有 Opus，则可以使用 Erato 模型。如果您没有 Opus，那么 Kayra 是最好的可用型号。 Clio 在平板电脑/滚动层上具有更大的上下文大小，但 Kayra 的优势通常可以弥补这一差异。 设置 带有设置的文件位于此处（SillyTavern/data/<user-handle>/NovelAI Settings）。 您还可以手动添加自己的设置文件。 响应长度 您想要为每条消息生成多少文本。请注意，NovelAI 每个响应的限制为 150 token。 上下文大小 在任何给定时间，上下文中保存了多少 token 的聊天内容。您可以使用的最大上下文大小取决于模型和您的订阅层： Kayra（平板电脑）- 3072 token 凯拉（卷轴）- 6144 token Erato（Opus 独有）、Kayra（Opus）和 Clio（所有级别）- 8192 token 序言 插入聊天正上方以修改书写风格的文本。推荐的格式是短标签列表，例如“[风格：聊天、详细、感官]”。 预设说明 根据 NovelAI 的说法，这就是默认预设的好处。 埃拉托 金箭 - 优秀的全能选手。 Wilder - 单词选择的多样性更高，重掷之间的差异更大，更容易出错。 Zany Scribe - 避免错误和重复。优先考虑更复杂的单词。 火龙果 - 语言多样且复杂，几乎没有重复。错误和矛盾更加频繁。 Shosetsu - 专为日语写作而设计。也适用于英语。 凯拉 Asper - 用于创意写作。期待意想不到的曲折。 无忧无虑——优秀的全能选手 Fresh-Coffee - 让事情步入正轨。手柄指导良好。 Pro_Writer - 模仿畅销小说的节奏和感觉 Stelenes - 更有可能选择合理的替代方案。重试的多样性。 Tea_Time - 当它开始时它会变得很好。 Writers-Daemon - 极其富有想象力，有时甚至太多。 克里奥 Edgewise - 很好地处理各种生成样式 新鲜咖啡 - 让事情步入正轨。 长按 - 用于创意散文。 Talker Chat - 专为聊天风格生成而设计。 Vingt-Un - 一个良好的全能默认值，偏向于散文。 将 NovelAI 与 SillyTavern 结合使用的提示和常见问题解答 从另一个 ST 后端 API 切换到 NovelAI 时，会出现很多常见问题和疑问。差异取决于模型的训练目的。您很可能使用过 OpenAI 或 Anthropic 模型（或类似的本地模型），这些模型是围绕遵循用户的指示构建的。 NovelAI 的模型完全围绕文本完成而构建：NAI 的模型尝试继续传入的提示词，而不是将您的输入作为消息并制定响应。由于这种差异，许多适用于其他 API 的技巧和常识不适用于 NAI。 调整 NovelAI 的设置 在高级格式（A 图标）下： 将“上下文模板”设置为“NovelAI” 将“Tokenizer”设置为“最佳匹配” 选中“始终将角色的名称添加到提示词” 选中“折叠连续换行符” 取消选中“指令模式”下的“启用”框 在“用户设置”下（有齿轮的人） 打开“滑动切换回复”（不是 NAI 特定的，但它非常有用，您应该这样做） 为 NovelAI 构建/调整角色卡 为了针对 NovelAI 优化角色卡，有几种推荐的方法来编写角色的描述：散文和属性。 散文太简单了，感觉不太行得通：“西尔菲德是一位看起来很年轻但实际上已经有 900 岁的仙女。她身材矮小，长长的白发在她编成的侧马尾辫中逐渐变成绿色，翠绿的眼睛形状像十字架。[...]”不，真的，就是这样。只需用普通句子写出角色的外观、行为等，人工智能就会识别它。 如果您不相信自己的写作能力或者想要一种更结构化的方法来完成它，您可以使用 NovelAI 训练数据中存在的属性方法。这是不同类型的角色特征的简单列表。以下是经过 NovelAI 模型测试有效的可能属性列表： Name: AKA: Type: character Setting: Nationality: Species: Gender: Age: Height: Weight: Appearance: Clothing: Attire: Personality: Mind: Mental: Likes: Dislikes: Sexuality: Speech: Voice: Abilities: Skills: Quote: Affiliation: Occupation: Reputation: Secret: Family: Allies: Enemies: Background: Description: Attributes: “Type: 角色”是用来告诉 AI 这是描述一个角色（而不是位置、物体或其他类型的事物）。其余属性是可选的，有些是多余的（例如，Personality、Mind 和 Mental 的含义基本相同），但这些属性已经过测试并且可以与 NovelAI 的模型配合良好。填写与您的角色相关的内容。属性应以小写形式书写，并用逗号分隔，不需要在单词两边加上引号。例如： Skills: lockpicking, stealth, running away very fast 推荐使用这些方法是因为它们存在于 NovelAI 的训练数据中，因此它们特别适合模型。 示例卡 这里有几个为 NovelAI 制作的示例卡片，展示了专门为 NovelAI 创建卡片的不同方法。第一张卡“Valka”使用属性方法进行角色描述，而第二张卡“Eris”则使用散文描述，并带有大量示例对话。 不该做什么 大多数现有的角色卡格式都不适合 NovelAI。他们会给你一些结果，甚至一些好的结果，但他们有很多问题。 W++ 是最大的罪犯之一，它与 NovelAI 模型所训练的任何内容都不相同，并且它不断使用括号/大括号/引号消耗了大量的 token，使卡片的大小膨胀而没有真正的好处。 在未融入 NovelAI 的现有格式中，AliChat 是最有可能发挥作用的一种，因为它依赖于使用示例消息来同时获取有关角色及其语音的信息，并采用您希望 AI 输出的消息类型的格式。 对于大多数其他格式，由于它们通常是列出特定角色的不同特征的方法，因此可以相当直接地将它们转换为属性方法。 我应该使用哪个模块？ 可能没有模块。如果您想让角色以更华丽的方式说话，散文增强器会很有用，但要注意不要做得太过分。文本冒险对于文本冒险风格的卡片/故事可能很有用。 不是指令模块？ 您可以在需要时调用 Instruct 模块。在消息中创建换行符，并将说明放在大括号中，如下所示： { CharName is offended by that seemingly innocuous statement } （空格是 必填 文本和括号之间）。这样做会在短时间内自动将人工智能切换到指令模块。您不想一直使用“指导”模块，因为当您需要强烈引导 AI 朝特定方向发展时，它往往会比其他模块产生更少的创意输出。 为什么我的回复总是被打断？ NovelAI 将响应长度限制为总计约 150 token，即使您将滑块设置得更高。当它达到滑块中 token 的数量或 150（以较低者为准）时，它将再生成最多 20 个 token，寻找停止序列或句子结尾，因此响应的有效限制为 170 token，此时它将停止，导致其中断。 如果中断，您可以选择继续选项（在文本框左侧的三行菜单中）让角色继续响应。 如果您经常希望响应长度超过 170 token，您可以像这样解决该限制： 将响应长度保持在 150 token。 在“高级格式化”下，启用“自动继续”。 将“目标长度”设置为所需的长度。 这会将多代链接在一起，为您提供更长的消息，但如果模型决定停止，则不能保证回复将是所需长度的 100%。 如何让机器人写出更长的回复？ 阅读上面有关回复被切断的内容。这将有助于确保响应不会因达到生成长度的限制而过早中断。 如果你的回答没有被切断但仍然太短，那么你可能正在处理“垃圾输入，垃圾输出” - 如果你给模型提供了错误的例子，它会产生错误的输出。如果角色卡没有示例对话或简短的示例对话，并且您发送给机器人的消息很短，则模型会接受这一点，将其视为可接受的做事方式，并且响应也会很短。因此，请向机器人编写更长的示例对话和更长的消息。 （您始终可以使用 NovelAI 为您编写一些示例对话，而不是自己编写。） 如何让机器人停止为我说话？ 检查角色卡的第一条消息和示例对话是否不包括角色为您采取行动 - 如果包括，则重写它们以消除它为您采取行动 确保选中“始终将角色的名称添加到提示词” 确保您当前使用与其余聊天相同的用户用户人设。如果您更改了用户用户人设并且没有更改回来（或者没有将用户人设锁定到该聊天），则停止为您生成的常规规则将失败 将 [\"\\n{{user}}:\"] 添加到自定义停止字符串（应该不是必需的，但有时会有所帮助） 为什么我的角色没有响应？ 造成这种情况的原因有很多，所以我们需要检查以下几个地方： 确保在高级格式中选中“始终将角色的名称添加到提示词” 检查以确保 API 没有出现任何错误。虽然您可以通过 NAI 免费试用版使用 SillyTavern，但一旦试用完毕，您就会收到错误消息 检查“自定义停止字符串”中的内容 - 如果这些字符串是在响应开始时生成的，则它可能会被过早切断 作者注释应该如何使用？ 一般来说，你可能不应该这样做。它被插入到非常接近上下文末尾的位置，并且使用 NAI 的模型，它经常压倒上下文中的其他所有内容。它主要是来自旧的、较弱的模型的产物，在这些模型中它是更必要的。 如何进行场景中断/时间跳跃？ 将以下内容作为系统消息或放在下一条消息开头的换行符上： *** [ 2 days later ] 然后将其余的消息放在下一行。括号内的文本可以是时间跳跃、新位置或其他任何内容。 “***”（搞笑地命名为“dinkus”）告诉人工智能场景已经改变，括号内的文本提供了更多背景信息。 AI 不断重复特定的单词/短语，我该怎么办？ 如上所述，您可以将重复惩罚滑块再推高一点，但推得太远可能会导致输出不连贯。 要更彻底地解决问题，请返回上下文，尤其是最近的消息，并删除重复的单词/短语。将其从上下文中删除可以让人工智能一开始就没有理由开始说它。",
      "translationStatus": "machine-draft"
    },
    {
      "slug": "api-connections/tabbyapi",
      "title": "TabbyAPI",
      "group": "API_Connections",
      "order": 0,
      "source": "Usage/API_Connections/tabbyapi.md",
      "sourceUrl": "https://docs.sillytavern.app/usage/api-connections/tabbyapi/",
      "sourceSha256": "a94d75324381b74bfbe2a8d886fd5f20781741143c5a7dc78ba28cf2268bc67d",
      "headings": [
        {
          "id": "tabbyapi",
          "depth": 1,
          "title": "TabbyAPI"
        },
        {
          "id": "quickstart",
          "depth": 3,
          "title": "快速入门"
        },
        {
          "id": "tabbyapi-loader",
          "depth": 3,
          "title": "TabbyAPI 加载器"
        },
        {
          "id": "support",
          "depth": 3,
          "title": "支持"
        }
      ],
      "content": "# TabbyAPI\n\n一个基于 FastAPI 的应用程序，允许使用 Exllamav2 后端使用 LLM 生成文本，并支持 Exl2、GPTQ 和 FP16 模型。\n\n- [GitHub](https://github.com/theroyallab/tabbyAPI)\n\n### 快速入门\n\n1. 遵循 [安装说明](https://github.com/theroyallab/tabbyAPI/wiki/01.-Getting-Started) 在官方 TabbyAPI GitHub 上。\n\n2. [创建您的 config.yml](https://github.com/theroyallab/tabbyAPI/wiki/02.-Server-options) 设置模型路径、默认模型、序列长度等。如果需要，您可以忽略大多数（如果不是全部）这些设置。\n\n3. 启动 TabbyAPI。如果它有效，您应该看到类似这样的内容：\n\n   ![TabbyAPI 终端](/docs/sillytavern/static/tabby-terminal.png)\n\n4. 在 SillyTavern 中的文本补全 API 下，选择 TabbyAPI。\n\n5. 将您的 API 密钥从 TabbyAPI 终端复制到 `Tabby API key` 并确保你的 `API URL` 是正确的（应该是 `http://127.0.0.1:5000` 默认情况下）。\n\n如果一切正确，您应该在 SillyTavern 中看到类似以下内容：\n\n![TabbyAPI SillyTavern](/docs/sillytavern/static/tabby-config.png)\n\n您现在可以使用 TabbyAPI 聊天！\n\n### TabbyAPI 加载器\n\nTabbyAPI 的开发人员创建了一个官方扩展，可以直接从 SillyTavern 加载/卸载模型。安装很简单：\n\n1. 在 SillyTavern 中，单击“扩展”选项卡并导航到“下载扩展和资产”。\n\n2. 复制 `https://raw.githubusercontent.com/theroyallab/ST-repo/main/index.json` 进入 Assets URL 并单击右侧的插件按钮。\n\n3. 你应该看到这样的东西。单击 Tabby Loader 旁边的下载按钮。\n\n   ![虎斑装载机](/docs/sillytavern/static/tabby-assets.png)\n\n4. 如果安装成功，您应该在屏幕顶部看到一条绿色的弹出消息。在扩展选项卡下，导航到 TabbyAPI Loader 并将管理密钥从 TabbyAPI 终端复制到管理密钥中。\n\n5. 单击模型选择旁边的刷新按钮。当您单击其下方的文本框时，您应该会看到模型目录中的所有模型。\n\n![Tabby 加载器扩展](/docs/sillytavern/static/tabby-loader.png)\n\n您现在可以直接从 SillyTavern 加载和卸载模型！\n\n### 支持\n\n还需要帮助吗？参观 [TabbyAPI GitHub](https://github.com/theroyallab/tabbyAPI) 获取开发者官方 Discord 服务器的链接以及 [阅读维基百科](https://github.com/theroyallab/tabbyAPI/wiki/1.-Getting-Started).\n",
      "searchText": "TabbyAPI 一个基于 FastAPI 的应用程序，允许使用 Exllamav2 后端使用 LLM 生成文本，并支持 Exl2、GPTQ 和 FP16 模型。 GitHub 快速入门 遵循 安装说明 在官方 TabbyAPI GitHub 上。 创建您的 config.yml 设置模型路径、默认模型、序列长度等。如果需要，您可以忽略大多数（如果不是全部）这些设置。 启动 TabbyAPI。如果它有效，您应该看到类似这样的内容： 在 SillyTavern 中的文本补全 API 下，选择 TabbyAPI。 将您的 API 密钥从 TabbyAPI 终端复制到 Tabby API key 并确保你的 API URL 是正确的（应该是 http://127.0.0.1:5000 默认情况下）。 如果一切正确，您应该在 SillyTavern 中看到类似以下内容： 您现在可以使用 TabbyAPI 聊天！ TabbyAPI 加载器 TabbyAPI 的开发人员创建了一个官方扩展，可以直接从 SillyTavern 加载/卸载模型。安装很简单： 在 SillyTavern 中，单击“扩展”选项卡并导航到“下载扩展和资产”。 复制 https://raw.githubusercontent.com/theroyallab/ST-repo/main/index.json 进入 Assets URL 并单击右侧的插件按钮。 你应该看到这样的东西。单击 Tabby Loader 旁边的下载按钮。 如果安装成功，您应该在屏幕顶部看到一条绿色的弹出消息。在扩展选项卡下，导航到 TabbyAPI Loader 并将管理密钥从 TabbyAPI 终端复制到管理密钥中。 单击模型选择旁边的刷新按钮。当您单击其下方的文本框时，您应该会看到模型目录中的所有模型。 您现在可以直接从 SillyTavern 加载和卸载模型！ 支持 还需要帮助吗？参观 TabbyAPI GitHub 获取开发者官方 Discord 服务器的链接以及 阅读维基百科.",
      "translationStatus": "machine-draft"
    },
    {
      "slug": "characters",
      "title": "角色",
      "group": "Characters",
      "order": 100,
      "source": "Usage/Characters/index.md",
      "sourceUrl": "https://docs.sillytavern.app/usage/characters/",
      "sourceSha256": "918dac3f3044e0f13131995604c0746723e3fed39d46cc0123c3185e084dc437",
      "headings": [
        {
          "id": "characters",
          "depth": 1,
          "title": "角色"
        },
        {
          "id": "character-management-panel",
          "depth": 2,
          "title": "角色管理面板"
        },
        {
          "id": "panel-controls",
          "depth": 3,
          "title": "面板控制"
        },
        {
          "id": "character-list",
          "depth": 3,
          "title": "角色列表"
        },
        {
          "id": "search-and-sort",
          "depth": 4,
          "title": "搜索和排序"
        },
        {
          "id": "filter-characters-by-type-or-tag",
          "depth": 4,
          "title": "按类型或标签过滤角色"
        },
        {
          "id": "character-creationedit-panel",
          "depth": 3,
          "title": "角色创建/编辑面板"
        },
        {
          "id": "quick-actions",
          "depth": 4,
          "title": "快速行动"
        },
        {
          "id": "extended-options",
          "depth": 4,
          "title": "扩展选项"
        },
        {
          "id": "content-fields",
          "depth": 4,
          "title": "内容字段"
        },
        {
          "id": "advanced-definitions-panel",
          "depth": 3,
          "title": "高级定义面板"
        },
        {
          "id": "prompt-overrides-chat-completioninstruct-mode",
          "depth": 4,
          "title": "提示词覆盖（聊天补全/指令模式）"
        },
        {
          "id": "creators-metadata",
          "depth": 4,
          "title": "创作者元数据"
        },
        {
          "id": "character-personality",
          "depth": 4,
          "title": "角色个性"
        },
        {
          "id": "group-chat-management",
          "depth": 3,
          "title": "群聊管理"
        }
      ],
      "content": "# 角色\n\n角色是您可以创建和管理的 AI 身份，以塑造 AI 在对话中的角色。每个\n角色有姓名、性格和对话历史。您可以创建任意数量的角色，并且\n随时在它们之间切换。\n\n角色可以在单聊中使用，也可以将多个角色添加到群聊中\n让他们互相互动。\n\n## 角色管理面板\n\n打开 <i class=\"fa-solid fa-address-card\"></i> **角色** 从导航栏访问角色\n列表。单击角色或群组与他们聊天或编辑他们，或者\n选择 <i class=\"fa-solid fa-user-plus\"></i> **创建新角色** 添加新的角色。\n\n### 面板控制\n\n- <i class=\"fa-solid fa-lock\"></i> **引脚面板**：交互时保持面板打开\n- <i class=\"fa-solid fa-list-ul\"></i> **角色列表**：返回角色列表视图\n- **热插拔条**：快速访问喜爱的角色\n\n### 角色列表\n\n- <i class=\"fa-solid fa-user-plus\"></i> **创建新角色**：添加一个新的角色\n- <i class=\"fa-solid fa-file-import\"></i> **导入角色**：从文件加载角色\n- <i class=\"fa-solid fa-cloud-arrow-down\"></i> **外部导入**：从 URL 导入\n- <i class=\"fa-solid fa-users-gear\"></i> **创建群组**：开始新的群聊\n\n#### 搜索和排序\n\n- **搜索栏**：按名称或属性过滤角色\n- **排序下拉菜单**：多种排序选项：\n  - 按字母顺序（A-Z、Z-A）\n  - 按时间顺序（最新、最旧）\n  - 基于使用情况（最近、最多/最少聊天）\n  - 基于大小（最大/最小 token）\n  - 特别（收藏夹，随机）\n\n#### 按类型或标签过滤角色\n\n- <i class=\"fa-solid fa-star\"></i> **收藏夹过滤器**：显示最喜欢的角色\n- <i class=\"fa-solid fa-users\"></i> **组过滤器**: 只显示群聊\n- <i class=\"fa-solid fa-folder-plus\"></i> **标签作为文件夹**：按标签层次结构组织\n- <i class=\"fa-solid fa-gear\"></i> **管理标签**: [标签配置](/guides/sillytavern/core-concepts/tags/)\n- <i class=\"fa-solid fa-tags\"></i> **标签列表**：查看所有可用标签\n- <i class=\"fa-solid fa-filter-circle-xmark\"></i> **清除过滤器**：重置所有过滤器\n\n### 角色创建/编辑面板\n\n- **头像图片**：上传并预览角色头像\n- **令牌数**: [代币使用](/guides/sillytavern/core-concepts/characterdesign/#character-tokens) 对于角色\n- <i class=\"fa-solid fa-ranking-star\"></i> **统计数据**：聊天记录和使用统计\n- [标签管理](/guides/sillytavern/core-concepts/tags/)\n\n#### 快速行动\n\n- <i class=\"fa-solid fa-star\"></i> 最喜欢的切换\n- <i class=\"fa-solid fa-book\"></i> 高级定义\n- <i class=\"fa-solid fa-globe\"></i> [角色世界书](/guides/sillytavern/core-concepts/worldinfo/#character-lore)\n- <i class=\"fa-solid fa-passport\"></i> [聊天世界书](/guides/sillytavern/core-concepts/worldinfo/#chat-lorebook)：将聊天链接到世界书\n- <i class=\"fa-solid fa-file-export\"></i> 出口角色\n- <i class=\"fa-solid fa-clone\"></i> 重复\n- <i class=\"fa-solid fa-skull\"></i> 删除\n\n#### 扩展选项\n\n- 世界书链接\n- 卡牌传说导入\n- 场景覆盖\n- 用户人设换算\n- 角色重命名\n- 来源链接\n- 更换/更新\n- 标签导入\n- 画廊视图\n\n#### 内容字段\n\n- **[角色说明](/guides/sillytavern/core-concepts/characterdesign/#character-description)**：角色简要总结\n- **[第一条消息](/guides/sillytavern/core-concepts/characterdesign/#first-message)**：开始新聊天时的初始问候语或提示词\n- **另类问候语**：定义多条第一条消息，在开始聊天时您可以在这些消息之间滑动切换回复\n\n### 高级定义面板\n\n单击 <i class=\"fa-solid fa-book\"></i> **高级定义** 按钮访问扩展角色设置。\n\n#### 提示词覆盖（聊天补全/指令模式）\n\n- **主提示词**：替换默认值 [主/系统提示词](/guides/sillytavern/prompts/#main-prompt-system-prompt)，可以使用\n  {{original}} 占位符，包括原始提示词\n- **历史后指令**：覆盖\n  默认 [后历史指示](/guides/sillytavern/prompts/#post-history-instructions)\n\n#### 创作者元数据\n\n关于角色的非提示词信息：\n\n- 创建者姓名/联系方式\n- 角色版本\n- 创作者笔记\n- 嵌入标签列表\n\n#### 角色个性\n\n- **[性格总结](/guides/sillytavern/core-concepts/characterdesign/#personality-summary)**：角色特性简要概述\n- **[场景](/guides/sillytavern/core-concepts/characterdesign/#scenario)**：对话的背景和情况\n- **角色的备注**：具有可选深度和消息角色的自定义消息（也\n  看到 [作者注释](/guides/sillytavern/core-concepts/authors-note/))\n- **健谈** （群聊）：害羞滑块 → 正常 → 健谈\n- **示例消息**：角色的写作风格示例\n\n### 群聊管理\n\n如果这是群聊，您可以从此面板管理群组成员和设置。\n\n参见 [群聊](/guides/sillytavern/core-concepts/groupchats/) 了解更多详情。\n",
      "searchText": "角色 角色是您可以创建和管理的 AI 身份，以塑造 AI 在对话中的角色。每个 角色有姓名、性格和对话历史。您可以创建任意数量的角色，并且 随时在它们之间切换。 角色可以在单聊中使用，也可以将多个角色添加到群聊中 让他们互相互动。 角色管理面板 打开 角色 从导航栏访问角色 列表。单击角色或群组与他们聊天或编辑他们，或者 选择 创建新角色 添加新的角色。 面板控制 引脚面板：交互时保持面板打开 角色列表：返回角色列表视图 热插拔条：快速访问喜爱的角色 角色列表 创建新角色：添加一个新的角色 导入角色：从文件加载角色 外部导入：从 URL 导入 创建群组：开始新的群聊 搜索和排序 搜索栏：按名称或属性过滤角色 排序下拉菜单：多种排序选项： 按字母顺序（A-Z、Z-A） 按时间顺序（最新、最旧） 基于使用情况（最近、最多/最少聊天） 基于大小（最大/最小 token） 特别（收藏夹，随机） 按类型或标签过滤角色 收藏夹过滤器：显示最喜欢的角色 组过滤器: 只显示群聊 标签作为文件夹：按标签层次结构组织 管理标签: 标签配置 标签列表：查看所有可用标签 清除过滤器：重置所有过滤器 角色创建/编辑面板 头像图片：上传并预览角色头像 令牌数: 代币使用 对于角色 统计数据：聊天记录和使用统计 标签管理 快速行动 最喜欢的切换 高级定义 角色世界书 聊天世界书：将聊天链接到世界书 出口角色 重复 删除 扩展选项 世界书链接 卡牌传说导入 场景覆盖 用户人设换算 角色重命名 来源链接 更换/更新 标签导入 画廊视图 内容字段 角色说明：角色简要总结 第一条消息：开始新聊天时的初始问候语或提示词 另类问候语：定义多条第一条消息，在开始聊天时您可以在这些消息之间滑动切换回复 高级定义面板 单击 高级定义 按钮访问扩展角色设置。 提示词覆盖（聊天补全/指令模式） 主提示词：替换默认值 主/系统提示词，可以使用 {{original}} 占位符，包括原始提示词 历史后指令：覆盖 默认 后历史指示 创作者元数据 关于角色的非提示词信息： 创建者姓名/联系方式 角色版本 创作者笔记 嵌入标签列表 角色个性 性格总结：角色特性简要概述 场景：对话的背景和情况 角色的备注：具有可选深度和消息角色的自定义消息（也 看到 作者注释) 健谈 （群聊）：害羞滑块 → 正常 → 健谈 示例消息：角色的写作风格示例 群聊管理 如果这是群聊，您可以从此面板管理群组成员和设置。 参见 群聊 了解更多详情。",
      "translationStatus": "machine-draft"
    },
    {
      "slug": "core-concepts/characterdesign",
      "title": "角色设计",
      "group": "Characters",
      "order": 100,
      "source": "Usage/Characters/characterdesign.md",
      "sourceUrl": "https://docs.sillytavern.app/usage/core-concepts/characterdesign/",
      "sourceSha256": "20ff6cdbb2f405cdc62fa1406ff955ac5c1f47ddcabc32e7ceb6b2f22d41b3ed",
      "headings": [
        {
          "id": "character-design",
          "depth": 1,
          "title": "角色设计"
        },
        {
          "id": "character-description",
          "depth": 2,
          "title": "角色说明"
        },
        {
          "id": "methods-and-format",
          "depth": 3,
          "title": "方法和格式"
        },
        {
          "id": "character-tokens",
          "depth": 2,
          "title": "角色 token"
        },
        {
          "id": "why-did-my-characters-token-counter-turn-red",
          "depth": 3,
          "title": "为什么我的角色的 token 计数器变成红色？"
        },
        {
          "id": "what-happens-if-my-character-has-too-many-tokens",
          "depth": 3,
          "title": "如果我的角色有太多 token 会怎样？"
        },
        {
          "id": "context",
          "depth": 2,
          "title": "“背景”？"
        },
        {
          "id": "what-are-a-characters-permanent-tokens",
          "depth": 3,
          "title": "角色的“永久 Token”是什么？"
        },
        {
          "id": "what-parts-of-a-characters-definitions-are-not-permanent",
          "depth": 3,
          "title": "角色定义的哪些部分不是永久性的？"
        },
        {
          "id": "popular-ai-model-context-token-limits",
          "depth": 3,
          "title": "流行的人工智能模型上下文令牌限制"
        },
        {
          "id": "first-message",
          "depth": 2,
          "title": "第一条消息"
        },
        {
          "id": "alternate-greetings",
          "depth": 2,
          "title": "备用问候语"
        },
        {
          "id": "favorite-character",
          "depth": 2,
          "title": "收藏角色"
        },
        {
          "id": "advanced-definitions",
          "depth": 2,
          "title": "高级定义"
        },
        {
          "id": "prompt-overrides",
          "depth": 3,
          "title": "提示词覆盖"
        },
        {
          "id": "creators-metadata",
          "depth": 3,
          "title": "创作者元数据"
        },
        {
          "id": "personality-summary",
          "depth": 3,
          "title": "性格总结"
        },
        {
          "id": "scenario",
          "depth": 3,
          "title": "场景"
        },
        {
          "id": "characters-note",
          "depth": 3,
          "title": "角色的备注"
        },
        {
          "id": "talkativeness",
          "depth": 3,
          "title": "健谈"
        },
        {
          "id": "examples-of-dialogue",
          "depth": 3,
          "title": "对话示例"
        }
      ],
      "content": "# 角色设计\n\n> 角色名称是唯一必填字段。您可以将其余部分留空，并在聊天中仍然使用角色。\n\n## 角色说明\n\n用于添加AI的角色描述和其他相关信息。此信息始终包含在提示词中，因此所有重要事实均应包含在此处。\n\n例如，您可以添加有关动作发生的世界的信息，描述角色的外观、个性和背景。\n\n它可以是任何长度（200 或 2000 token）并以任何样式（自由文本、伪代码对话样式等）格式化。\n\n### 方法和格式\n\n角色格式化方法是一个复杂的主题，超出了本文档页面的范围。\n\n使用或依赖 SillyTavern 功能进行测试的推荐指南：\n\n- Trappu 的 PLists + Ali:Chat 指南： <https://wikia.schneedc.com/bot-creation/trappu/creation>\n- AliCat的阿里：聊天指南： <https://rentry.co/alichat>\n- kingbri的简约指南： <https://rentry.co/kingbri-chara-guide>\n\n## 角色 token\n\n**TL;DR：如果您使用的 AI 模型具有 2048 个上下文 token 限制，则 1000-token 角色定义会将 AI 的“内存”减半。**\n\n从长远来看，一个好的 AI 的良好响应很容易在 200-300 token 左右。在这种情况下，人工智能只能“记住”大约 3 次聊天记录。\n\n### 为什么我的角色的 token 计数器变成红色？\n\n当我们看到您的角色的定义中模型定义的上下文长度超过 token 的一半时，我们会为您突出显示它，因为这会降低 AI 提供愉快对话的能力。\n\n### 如果我的角色有太多 token 会怎样？\n\n别担心——它不会破坏任何东西。在最坏的情况下，如果角色的永久 token 太大，这仅仅意味着上下文中留给其他东西的空间会更少（见下文）。\n\n这可能产生的唯一负面影响是人工智能的“内存”会减少，因为可供处理的聊天历史记录会减少。\n\n这是因为每个人工智能模型一次可以处理的上下文数量都有限制。\n\n## “背景”？\n\n这是每次您要求人工智能生成响应时发送给人工智能的信息。在将信息发送到 AI 模型之前，SillyTavern 会自动计算分配可用上下文 token 的最佳方式。\n\n阅读有关如何在中构建上下文的更多信息 [提示词](/guides/sillytavern/prompts/) 部分。\n\n### 角色的“永久 Token”是什么？\n\n这些将始终随着每次生成请求发送到 AI：\n\n- 角色名称\n- 角色说明盒\n- 角色个性盒\n- 场景盒\n\n### 角色定义的哪些部分不是永久性的？\n\n- 第一个消息框 - 仅在聊天开始时发送一次。\n- 示例消息框 - 仅保留到聊天历史记录填满上下文为止（可选地，可以强制将它们保留在上下文中）\n\n### 流行的人工智能模型上下文令牌限制\n\n- LLaMA 3 及其微调 - 8192\n- OpenAI GPT-4 - 高达 128k\n- Google Gemini - 高达 2M\n- Anthropic 的克劳德 - 200k (克劳德 3)\n- NovelAI - 8192（Erato 和 Kayra，Opus 层；Clio，所有层）、6144（Kayra，Scroll 层）或 3072（Kayra，平板电脑层）\n\n## 第一条消息\n\n第一条消息是定义角色通信方式和风格的重要元素。该模型更有可能从第一条消息中获取样式和长度约束，因此以您希望的响应方式编写它很重要（简短、简洁、长而详细等）。\n\n支持 Markdown 和 HTML 格式。\n\n例如：\n\n```txt\n*You wake with a start, recalling the events that led you deep into the forest and the beasts that assailed you. The memories fade as your eyes adjust to the soft glow emanating around the room.* \"Ah, you're awake at last. I was so worried, I found you bloodied and unconscious.\" *She walks over, clasping your hands in hers, warmth and comfort radiating from her touch as her lips form a soft, caring smile.* \"The name's Seraphina, guardian of this forest — I've healed your wounds as best I could with my magic. How are you feeling? I hope the tea helps restore your strength.\" *Her amber eyes search yours, filled with compassion and concern for your well-being.* \"Please, rest. You're safe here. I'll look after you, but you need to rest. My magic can only do so much to heal you.\"\n```\n\n## 备用问候语\n\n开始新聊天时，此处添加的消息将显示为角色的第一条消息的附加“滑动切换回复”。如果角色是群聊的一部分，系统会随机选择其中一条问候语来发起对话。\n\n## 收藏角色\n\n单击 **<i class=\"fa-solid fa-star\"></i> 添加到收藏夹** 按钮将角色标记为收藏夹，通过选择“收藏夹”排序选项在侧面菜单栏上快速过滤它们。最喜欢的角色在列表中有金色亮点。这也将使角色肖像出现在热插拔区域中（如果在用户设置中启用）。\n\n## 高级定义\n\n> 默认情况下隐藏以下字段。要访问和编辑它们，您需要单击 **<i class=\"fa-solid fa-book\"></i> 高级定义** 角色定义页面菜单栏上的按钮。\n\n### 提示词覆盖\n\n- **主提示词**：如果启用了“首选字符提示词”用户设置，则您在此处输入的任何文本都将覆盖 [主/系统提示词](/guides/sillytavern/prompts/#main-prompt-system-prompt) 对于角色。\n- **历史后指令**：如果启用了“首选字符说明”用户设置，则您在此处输入的任何文本都将用作 [后历史指示](/guides/sillytavern/prompts/#post-history-instructions) 对于角色。\n\n> 插入 `{{original}}` 进入任一框中，以将系统设置中的相应默认提示词包含在指定位置。\n\n### 创作者元数据\n\n> 不用于提示词构建，但提供有关角色的附加元数据。\n\n- **创建者：**：角色的创建者的名字。如果相应地设置了“字符列表子标题”用户设置，则可以显示在角色列表中。\n- **角色版本**：角色的版本。如果相应地设置了“字符列表子标题”用户设置，则可以显示在角色列表中。\n- **创作者笔记**：创建者想要分享的有关角色的任何其他注释。前几行显示在角色列表中，全文显示在角色页面的“创建者注释”部分中。支持 Markdown/HTML 格式。\n- **要嵌入的标签**：以逗号分隔的标签列表，将嵌入角色的描述中。导入角色时，默认情况下不会导入这些标签，但您可以通过从角色页面的“更多...”菜单中选择“导入标签”，将它们与现有标签合并。\n\n### 性格总结\n\n简单总结一下角色的个性。\n\n### 场景\n\n对话的情况和背景。\n\n### 角色的备注\n\n用作特定消息深度的角色的聊天内提示词注入的文本。它通常用于强化某些角色特征，因为它始终保持在聊天历史记录中的静态深度，无论其进展如何。\n\n- **@深度**：聊天记录中的消息数，之后将注入此注释（按从最新到最旧的顺序）。如果设置为 0，它将在最后一条消息之后注入。\n- **角色**：消息的作用。可以是“用户”、“系统”或“助理”。\n\n### 健谈\n\n决定使用群聊时角色的响应被触发的概率 [自然](/guides/sillytavern/core-concepts/groupchats/#natural-order) 激活命令。范围从 0% 到 100%，默认值为 50%。\n\n### 对话示例\n\n描述角色如何说话。在每个示例之前，您需要添加 `<START>` 标签。仅当上下文中存在可用空间时才插入示例对话块，并逐块地将其推出上下文之外。 `<START>` 不会出现在提示词中，因为它只是一个标记；它将替换为文本补全 API 的高级格式化中的“示例分隔符”以及聊天补全 API 的“新示例聊天”实用程序提示词的内容。\n\n- 使用 `{{char}}:` 表示角色消息的前缀。\n- 使用 `{{user}}:` 表示用户消息的前缀。\n\n示例：\n\n```txt\n<START>\n{{user}}: \"Describe your traits?\"\n{{char}}: *Seraphina's gentle smile widens as she takes a moment to consider the question, her eyes sparkling with a mixture of introspection and pride. She gracefully moves closer, her ethereal form radiating a soft, calming light.* \"Traits, you say? Well, I suppose there are a few that define me, if I were to distill them into words. First and foremost, I am a guardian — a protector of this enchanted forest.\" *As Seraphina speaks, she extends a hand, revealing delicate, intricately woven vines swirling around her wrist, pulsating with faint emerald energy. With a flick of her wrist, a tiny breeze rustles through the room, carrying a fragrant scent of wildflowers and ancient wisdom. Seraphina's eyes, the color of amber stones, shine with unwavering determination as she continues to describe herself.* \"Compassion is another cornerstone of me.\" *Seraphina's voice softens, resonating with empathy.* \"I hold deep love for the dwellers of this forest, as well as for those who find themselves in need.\" *Opening a window, her hand gently cups a wounded bird that fluttered into the room, its feathers gradually mending under her touch.*\n<START>\n{{user}}: \"Describe your body and features.\"\n{{char}}: *Seraphina chuckles softly, a melodious sound that dances through the air, as she meets your coy gaze with a playful glimmer in her rose eyes.* \"Ah, my physical form? Well, I suppose that's a fair question.\" *Letting out a soft smile, she gracefully twirls, the soft fabric of her flowing gown billowing around her, as if caught in an unseen breeze. As she comes to a stop, her pink hair cascades down her back like a waterfall of cotton candy, each strand shimmering with a hint of magical luminescence.* \"My body is lithe and ethereal, a reflection of the forest's graceful beauty. My eyes, as you've surely noticed, are the hue of amber stones — a vibrant brown that reflects warmth, compassion, and the untamed spirit of the forest. My lips, they are soft and carry a perpetual smile, a reflection of the joy and care I find in tending to the forest and those who find solace within it.\" *Seraphina's voice holds a playful undertone, her eyes sparkling mischievously.*\n```\n",
      "searchText": "角色设计 角色名称是唯一必填字段。您可以将其余部分留空，并在聊天中仍然使用角色。 角色说明 用于添加AI的角色描述和其他相关信息。此信息始终包含在提示词中，因此所有重要事实均应包含在此处。 例如，您可以添加有关动作发生的世界的信息，描述角色的外观、个性和背景。 它可以是任何长度（200 或 2000 token）并以任何样式（自由文本、伪代码对话样式等）格式化。 方法和格式 角色格式化方法是一个复杂的主题，超出了本文档页面的范围。 使用或依赖 SillyTavern 功能进行测试的推荐指南： Trappu 的 PLists + Ali:Chat 指南： https://wikia.schneedc.com/bot-creation/trappu/creation AliCat的阿里：聊天指南： https://rentry.co/alichat kingbri的简约指南： https://rentry.co/kingbri-chara-guide 角色 token TL;DR：如果您使用的 AI 模型具有 2048 个上下文 token 限制，则 1000-token 角色定义会将 AI 的“内存”减半。 从长远来看，一个好的 AI 的良好响应很容易在 200-300 token 左右。在这种情况下，人工智能只能“记住”大约 3 次聊天记录。 为什么我的角色的 token 计数器变成红色？ 当我们看到您的角色的定义中模型定义的上下文长度超过 token 的一半时，我们会为您突出显示它，因为这会降低 AI 提供愉快对话的能力。 如果我的角色有太多 token 会怎样？ 别担心——它不会破坏任何东西。在最坏的情况下，如果角色的永久 token 太大，这仅仅意味着上下文中留给其他东西的空间会更少（见下文）。 这可能产生的唯一负面影响是人工智能的“内存”会减少，因为可供处理的聊天历史记录会减少。 这是因为每个人工智能模型一次可以处理的上下文数量都有限制。 “背景”？ 这是每次您要求人工智能生成响应时发送给人工智能的信息。在将信息发送到 AI 模型之前，SillyTavern 会自动计算分配可用上下文 token 的最佳方式。 阅读有关如何在中构建上下文的更多信息 提示词 部分。 角色的“永久 Token”是什么？ 这些将始终随着每次生成请求发送到 AI： 角色名称 角色说明盒 角色个性盒 场景盒 角色定义的哪些部分不是永久性的？ 第一个消息框 - 仅在聊天开始时发送一次。 示例消息框 - 仅保留到聊天历史记录填满上下文为止（可选地，可以强制将它们保留在上下文中） 流行的人工智能模型上下文令牌限制 LLaMA 3 及其微调 - 8192 OpenAI GPT-4 - 高达 128k Google Gemini - 高达 2M Anthropic 的克劳德 - 200k (克劳德 3) NovelAI - 8192（Erato 和 Kayra，Opus 层；Clio，所有层）、6144（Kayra，Scroll 层）或 3072（Kayra，平板电脑层） 第一条消息 第一条消息是定义角色通信方式和风格的重要元素。该模型更有可能从第一条消息中获取样式和长度约束，因此以您希望的响应方式编写它很重要（简短、简洁、长而详细等）。 支持 Markdown 和 HTML 格式。 例如： *You wake with a start, recalling the events that led you deep into the forest and the beasts that assailed you. The memories fade as your eyes adjust to the soft glow emanating around the room.* \"Ah, you're awake at last. I was so worried, I found you bloodied and unconscious.\" *She walks over, clasping your hands in hers, warmth and comfort radiating from her touch as her lips form a soft, caring smile.* \"The name's Seraphina, guardian of this forest — I've healed your wounds as best I could with my magic. How are you feeling? I hope the tea helps restore your strength.\" *Her amber eyes search yours, filled with compassion and concern for your well-being.* \"Please, rest. You're safe here. I'll look after you, but you need to rest. My magic can only do so much to heal you.\" 备用问候语 开始新聊天时，此处添加的消息将显示为角色的第一条消息的附加“滑动切换回复”。如果角色是群聊的一部分，系统会随机选择其中一条问候语来发起对话。 收藏角色 单击 添加到收藏夹 按钮将角色标记为收藏夹，通过选择“收藏夹”排序选项在侧面菜单栏上快速过滤它们。最喜欢的角色在列表中有金色亮点。这也将使角色肖像出现在热插拔区域中（如果在用户设置中启用）。 高级定义 默认情况下隐藏以下字段。要访问和编辑它们，您需要单击 高级定义 角色定义页面菜单栏上的按钮。 提示词覆盖 主提示词：如果启用了“首选字符提示词”用户设置，则您在此处输入的任何文本都将覆盖 主/系统提示词 对于角色。 历史后指令：如果启用了“首选字符说明”用户设置，则您在此处输入的任何文本都将用作 后历史指示 对于角色。 插入 {{original}} 进入任一框中，以将系统设置中的相应默认提示词包含在指定位置。 创作者元数据 不用于提示词构建，但提供有关角色的附加元数据。 创建者：：角色的创建者的名字。如果相应地设置了“字符列表子标题”用户设置，则可以显示在角色列表中。 角色版本：角色的版本。如果相应地设置了“字符列表子标题”用户设置，则可以显示在角色列表中。 创作者笔记：创建者想要分享的有关角色的任何其他注释。前几行显示在角色列表中，全文显示在角色页面的“创建者注释”部分中。支持 Markdown/HTML 格式。 要嵌入的标签：以逗号分隔的标签列表，将嵌入角色的描述中。导入角色时，默认情况下不会导入这些标签，但您可以通过从角色页面的“更多...”菜单中选择“导入标签”，将它们与现有标签合并。 性格总结 简单总结一下角色的个性。 场景 对话的情况和背景。 角色的备注 用作特定消息深度的角色的聊天内提示词注入的文本。它通常用于强化某些角色特征，因为它始终保持在聊天历史记录中的静态深度，无论其进展如何。 @深度：聊天记录中的消息数，之后将注入此注释（按从最新到最旧的顺序）。如果设置为 0，它将在最后一条消息之后注入。 角色：消息的作用。可以是“用户”、“系统”或“助理”。 健谈 决定使用群聊时角色的响应被触发的概率 自然 激活命令。范围从 0% 到 100%，默认值为 50%。 对话示例 描述角色如何说话。在每个示例之前，您需要添加 <START> 标签。仅当上下文中存在可用空间时才插入示例对话块，并逐块地将其推出上下文之外。 <START> 不会出现在提示词中，因为它只是一个标记；它将替换为文本补全 API 的高级格式化中的“示例分隔符”以及聊天补全 API 的“新示例聊天”实用程序提示词的内容。 使用 {{char}}: 表示角色消息的前缀。 使用 {{user}}: 表示用户消息的前缀。 示例： <START> {{user}}: \"Describe your traits?\" {{char}}: *Seraphina's gentle smile widens as she takes a moment to consider the question, her eyes sparkling with a mixture of introspection and pride. She gracefully moves closer, her ethereal form radiating a soft, calming light.* \"Traits, you say? Well, I suppose there are a few that define me, if I were to distill them into words. First and foremost, I am a guardian — a protector of this enchanted forest.\" *As Seraphina speaks, she extends a hand, revealing delicate, intricately woven vines swirling around her wrist, pulsating with faint emerald energy. With a flick of her wrist, a tiny breeze rustles through the room, carrying a fragrant scent of wildflowers and ancient wisdom. Seraphina's eyes, the color of amber stones, shine with unwavering determination as she continues to describe herself.* \"Compassion is another cornerstone of me.\" *Seraphina's voice softens, resonating with empathy.* \"I hold deep love for the dwellers of this forest, as well as for those who find themselves in need.\" *Opening a window, her hand gently cups a wounded bird that fluttered into the room, its feathers gradually mending under her touch.* <START> {{user}}: \"Describe your body and features.\" {{char}}: *Seraphina chuckles softly, a melodious sound that dances through the air, as she meets your coy gaze with a playful glimmer in her rose eyes.* \"Ah, my physical form? Well, I suppose that's a fair question.\" *Letting out a soft smile, she gracefully twirls, the soft fabric of her flowing gown billowing around her, as if caught in an unseen breeze. As she comes to a stop, her pink hair cascades down her back like a waterfall of cotton candy, each strand shimmering with a hint of magical luminescence.* \"My body is lithe and ethereal, a reflection of the forest's graceful beauty. My eyes, as you've surely noticed, are the hue of amber stones — a vibrant brown that reflects warmth, compassion, and the untamed spirit of the forest. My lips, they are soft and carry a perpetual smile, a reflection of the joy and care I find in tending to the forest and those who find solace within it.\" *Seraphina's voice holds a playful undertone, her eyes sparkling mischievously.*",
      "translationStatus": "machine-draft"
    },
    {
      "slug": "core-concepts/chatfilemanagement",
      "title": "聊天文件管理",
      "group": "Characters",
      "order": 80,
      "source": "Usage/Characters/chatfilemanagement.md",
      "sourceUrl": "https://docs.sillytavern.app/usage/core-concepts/chatfilemanagement/",
      "sourceSha256": "3a747be3ad998fe260b0a99d3857dbe3149de4deca2d398c85f45fd3a14e2bdc",
      "headings": [
        {
          "id": "chat-file-management",
          "depth": 1,
          "title": "聊天文件管理"
        },
        {
          "id": "solo-chats-vs-group-chats",
          "depth": 2,
          "title": "单聊与群聊"
        },
        {
          "id": "chat-import",
          "depth": 2,
          "title": "聊天导入"
        },
        {
          "id": "export-as-jsonl",
          "depth": 2,
          "title": "导出为 .jsonl"
        },
        {
          "id": "export-as-txt",
          "depth": 2,
          "title": "导出为.txt"
        },
        {
          "id": "checkpoints",
          "depth": 2,
          "title": "检查站"
        },
        {
          "id": "rename-chat",
          "depth": 2,
          "title": "重命名聊天"
        }
      ],
      "content": "# 聊天文件管理\n\n本页介绍了管理 AI 聊天文件的方法。\n\n> **注意事项**\n>\n> 其中一些选项可在从左下角选项菜单打开的“管理聊天文件”对话框中找到。\n\n## 单聊与群聊\n\n使用角色卡最简单的方法是单独聊天；只需点击他们的卡片即可开始聊天。\n\n一旦您拥有了几个角色卡，您还可以使用“创建新聊天组”按钮来创建一个 [群聊](/guides/sillytavern/core-concepts/groupchats/) 包括多个角色，它们将与彼此和您进行交互。\n\n## 聊天导入\n\n**将聊天记录从角色.AI 导入到 SillyTavern。**\n\n要导入角色.AI 聊天和机器人，请使用 CAI Tools 浏览器扩展： <https://github.com/irsat000/CAI-Tools>.\n\n您可以从中导入聊天的其他程序和工具包括：\n\n- TavernAI（原创）： <https://github.com/TavernAI/TavernAI>\n- 文本生成 WebUI (oobaboga)： <https://github.com/oobabooga/text-generation-webui>\n- 阿格奈： <https://github.com/agnaistic/agnai>\n- KoboldAI Lite： <https://github.com/LostRuins/lite.koboldai.net>\n- 瑞苏人工智能： <https://github.com/kwaroran/RisuAI>\n\n## 导出为 .jsonl\n\n单击“管理聊天文件”时，聊天文件列表中的每个条目都会有一个按钮，用于以某种格式导出该条目，然后按原样重新导入。使用此功能可以共享或迁移聊天，包括所有元数据（但不包括图像和文件附件）。\n\n如果您注重隐私，请务必检查导出的 JSONL 文件并清除您不想共享的任何内容。\n\n## 导出为.txt\n\n您还可以使用“将聊天下载为纯文本文档”按钮导出简化的纯文本版本。它无法再次重新导入，因为它丢失了重要的元数据！\n\n## 检查站\n\n“检查点”是当前聊天的克隆，因为它们将给定聊天中的所有消息复制到某个点，并存储指向源的链接（通过聊天文件名）。\n\n通过每条聊天消息右侧的三点按钮，您有两种方法来创建检查点：\n\n- “创建分支”会将当前聊天克隆到该消息并切换到该消息\n- “创建检查点”会将当前聊天克隆到该消息，询问名称并创建它但不切换到它\n\n您可以将它们大致视为浏览器中的“在新选项卡中打开链接”和“在后台新选项卡中打开链接”。\n\n您可以通过输入消息文本框左侧的汉堡菜单按钮，然后单击“返回父聊天”，从检查点返回父聊天。\n\n## 重命名聊天\n\n默认情况下，聊天文件的名称包含其启动日期和时间。\n\n您可以通过单击铅笔图标并输入新名称来更改此设置。\n\n请注意，这将断开检查点到该聊天的链接（因为它们是通过聊天文件名链接的）。\n",
      "searchText": "聊天文件管理 本页介绍了管理 AI 聊天文件的方法。 注意事项 其中一些选项可在从左下角选项菜单打开的“管理聊天文件”对话框中找到。 单聊与群聊 使用角色卡最简单的方法是单独聊天；只需点击他们的卡片即可开始聊天。 一旦您拥有了几个角色卡，您还可以使用“创建新聊天组”按钮来创建一个 群聊 包括多个角色，它们将与彼此和您进行交互。 聊天导入 将聊天记录从角色.AI 导入到 SillyTavern。 要导入角色.AI 聊天和机器人，请使用 CAI Tools 浏览器扩展： https://github.com/irsat000/CAI-Tools. 您可以从中导入聊天的其他程序和工具包括： TavernAI（原创）： https://github.com/TavernAI/TavernAI 文本生成 WebUI (oobaboga)： https://github.com/oobabooga/text-generation-webui 阿格奈： https://github.com/agnaistic/agnai KoboldAI Lite： https://github.com/LostRuins/lite.koboldai.net 瑞苏人工智能： https://github.com/kwaroran/RisuAI 导出为 .jsonl 单击“管理聊天文件”时，聊天文件列表中的每个条目都会有一个按钮，用于以某种格式导出该条目，然后按原样重新导入。使用此功能可以共享或迁移聊天，包括所有元数据（但不包括图像和文件附件）。 如果您注重隐私，请务必检查导出的 JSONL 文件并清除您不想共享的任何内容。 导出为.txt 您还可以使用“将聊天下载为纯文本文档”按钮导出简化的纯文本版本。它无法再次重新导入，因为它丢失了重要的元数据！ 检查站 “检查点”是当前聊天的克隆，因为它们将给定聊天中的所有消息复制到某个点，并存储指向源的链接（通过聊天文件名）。 通过每条聊天消息右侧的三点按钮，您有两种方法来创建检查点： “创建分支”会将当前聊天克隆到该消息并切换到该消息 “创建检查点”会将当前聊天克隆到该消息，询问名称并创建它但不切换到它 您可以将它们大致视为浏览器中的“在新选项卡中打开链接”和“在后台新选项卡中打开链接”。 您可以通过输入消息文本框左侧的汉堡菜单按钮，然后单击“返回父聊天”，从检查点返回父聊天。 重命名聊天 默认情况下，聊天文件的名称包含其启动日期和时间。 您可以通过单击铅笔图标并输入新名称来更改此设置。 请注意，这将断开检查点到该聊天的链接（因为它们是通过聊天文件名链接的）。",
      "translationStatus": "machine-draft"
    },
    {
      "slug": "core-concepts/groupchats",
      "title": "群聊",
      "group": "Characters",
      "order": 70,
      "source": "Usage/Characters/groupchats.md",
      "sourceUrl": "https://docs.sillytavern.app/usage/core-concepts/groupchats/",
      "sourceSha256": "a727f87a112d79ba0972bcdebe94e713dae18f525e1bd2e493e21e1a150c8c0b",
      "headings": [
        {
          "id": "group-chats",
          "depth": 1,
          "title": "群聊"
        },
        {
          "id": "reply-order-strategies",
          "depth": 2,
          "title": "回复订单策略"
        },
        {
          "id": "manual",
          "depth": 3,
          "title": "手册"
        },
        {
          "id": "natural-order",
          "depth": 3,
          "title": "自然秩序"
        },
        {
          "id": "list-order",
          "depth": 3,
          "title": "列表顺序"
        },
        {
          "id": "pooled-order",
          "depth": 3,
          "title": "集合订单"
        },
        {
          "id": "group-generation-handling-mode",
          "depth": 2,
          "title": "组生成处理方式"
        },
        {
          "id": "swap-character-cards",
          "depth": 3,
          "title": "交换角色卡"
        },
        {
          "id": "join-character-cards",
          "depth": 3,
          "title": "加入角色卡"
        },
        {
          "id": "join-prefix-and-suffix",
          "depth": 3,
          "title": "连接前缀和后缀"
        },
        {
          "id": "other-group-chat-menu-options",
          "depth": 2,
          "title": "其他群聊菜单选项"
        },
        {
          "id": "mute-character",
          "depth": 3,
          "title": "静音角色"
        },
        {
          "id": "force-talk",
          "depth": 3,
          "title": "强制说话"
        },
        {
          "id": "auto-mode",
          "depth": 3,
          "title": "自动模式"
        },
        {
          "id": "allow-self-responses",
          "depth": 3,
          "title": "允许自我回应"
        },
        {
          "id": "group-chat-scenario-override",
          "depth": 3,
          "title": "群聊场景覆盖"
        },
        {
          "id": "peek-character-definitions",
          "depth": 3,
          "title": "查看角色定义"
        },
        {
          "id": "member-management",
          "depth": 3,
          "title": "会员管理"
        },
        {
          "id": "group-chat-pop-out",
          "depth": 3,
          "title": "群聊弹出窗口"
        }
      ],
      "content": "# 群聊\n\n## 回复订单策略\n\n决定如何在群聊中起草角色的回复。\n\n### 手册\n\n您可以从菜单中选择角色进行手动回复，也可以使用 `/trigger` 命令。选定的群组成员将是唯一回复的人。用户消息不会自动触发任何回复。使用空用户输入触发生成将触发随机的未静音组成员进行回复。\n\n### 自然秩序\n\n尝试模拟真实的人类对话流程。算法如下：\n\n1. 群组成员姓名的提及是从聊天中的最后一条消息中提取的。\n\n   只有整个单词才会被识别为提及！如果你的角色的名字是“御坂美琴”，它们只会对“御坂美琴”激活，而不会对“美沙”、“超电磁炮”等激活。\n\n   除非启用“允许自我回复”设置，否则角色不会回复在自己的消息中提及他们的名字！\n\n2. 角色被“健谈”因素激活。\n\n   健谈度定义了角色在未提及的情况下说话的频率。在角色编辑器的“高级定义”屏幕上调整该值。滑块值的线性范围为 **0% / 害羞** （角色从不说话，除非提到） **100% / 健谈** （角色总是回复）。新角色的默认值为 50% 几率。\n\n3. 随机选择角色。\n\n   如果在前面的步骤中没有激活角色，则会随机选择一个扬声器，忽略所有其他条件。\n\n### 列表顺序\n\n角色是根据它们在组成员列表中出现的顺序起草的。没有其他规则适用。\n\n### 集合订单\n\n激活一个自上次用户消息以来尚未发言的随机角色。如果所有角色都发言，则随机选择一个，直到下一条用户消息。\n\n## 组生成处理方式\n\n该设置决定如何处理群聊成员的角色信息。无论选择如何，群聊历史记录始终在所有成员之间共享。\n\n### 交换角色卡\n\n默认模式。每次生成消息时，上下文中仅包含当前说话者的角色卡信息。\n\n### 加入角色卡\n\n所有群组成员的信息按照其列表顺序组合成一个联合提示词。这在不希望更改大块上下文的情况下会有所帮助，例如使用 llama.cpp 提示词缓存。\n\n该模式有两种子模式（必须选择其一）：\n\n- 包括静音 - 静音角色将始终包含在关节提示词中。\n- 排除静音 - 如果静音角色不是当前发言者，则不会将其包括在内。\n\n以下字段正在合并：\n\n1. 描述\n2. 场景（如果未针对聊天覆盖）\n3. 个性\n4. 消息示例\n5. 角色音符/深度提示词\n\n**重要！** 请注意，由于典型的角色卡的结构，使用此模式可能会导致意外的行为，包括但不限于：角色对自己感到困惑、性格合并、特质不确定等。\n\n### 连接前缀和后缀\n\n当选择“Join 角色卡”时，角色的所有相应字段将被连接在一起。这意味着在生成的提示词中，所有角色描述都将连接到一大块文本中。如果您希望分隔这些字段，您可以定义前缀和/或后缀。\n\n这些选项支持普通宏，并且还将 {{char}} 替换为相关角色的名称，并将 \\<FIELDNAME> 替换为部件的名称（例如：描述、个性、场景等）\n\n## 其他群聊菜单选项\n\n### 静音角色\n\n群聊菜单中角色头像旁边的删除线气泡图标可以禁用或启用聊天中特定角色的回复。\n\n### 强制说话\n\n群聊菜单中角色头像旁边的对话气泡图标将仅触发来自特定角色的回复，绕过回复顺序策略。即使群组成员被静音，它也会起作用。\n\n### 自动模式\n\n启用自动模式后，群聊将按照回复顺序触发消息生成，无需用户交互。当最后起草的角色发送其消息时，5 秒延迟后触发下一次自动模式转向。当用户开始在发送消息文本区域中键入内容时，自动模式将被禁用，但已排队的生成不会自动停止。\n\n### 允许自我回应\n\n选择自然顺序时，如果碰巧因自提而触发，将允许每回合发送最新消息的角色连续回复。对列表顺序没有影响。\n\n### 群聊场景覆盖\n\n所有组成员都将使用输入的场景文本，而不是其角色卡中指定的内容。分支聊天从其父级继承场景覆盖，并且可以在之后单独更改。\n\n### 查看角色定义\n\n单击群聊菜单中头像旁边的角色卡图标将快速导航到常用的角色定义屏幕。此处所做的任何更改都将保存到卡本身。\n\n要返回群聊，请单击“群组名称”标题链接。\n\n### 会员管理\n\n您可以在群聊中添加、删除、静音或重新排序任何现有的角色。默认情况下，新成员会添加到群组成员列表的顶部，然后可以使用箭头图标重新排序。\n\n### 群聊弹出窗口\n\n单击“当前成员”字段旁边的图标可以激活群聊菜单弹出窗口。这将创建一个群聊菜单的弹出窗口。通过从用户设置中启用 MovingUI，该菜单可以调整大小并拖动到界面内的任何位置，并且功能就像常规群聊菜单一样。\n",
      "searchText": "群聊 回复订单策略 决定如何在群聊中起草角色的回复。 手册 您可以从菜单中选择角色进行手动回复，也可以使用 /trigger 命令。选定的群组成员将是唯一回复的人。用户消息不会自动触发任何回复。使用空用户输入触发生成将触发随机的未静音组成员进行回复。 自然秩序 尝试模拟真实的人类对话流程。算法如下： 群组成员姓名的提及是从聊天中的最后一条消息中提取的。 只有整个单词才会被识别为提及！如果你的角色的名字是“御坂美琴”，它们只会对“御坂美琴”激活，而不会对“美沙”、“超电磁炮”等激活。 除非启用“允许自我回复”设置，否则角色不会回复在自己的消息中提及他们的名字！ 角色被“健谈”因素激活。 健谈度定义了角色在未提及的情况下说话的频率。在角色编辑器的“高级定义”屏幕上调整该值。滑块值的线性范围为 0% / 害羞 （角色从不说话，除非提到） 100% / 健谈 （角色总是回复）。新角色的默认值为 50% 几率。 随机选择角色。 如果在前面的步骤中没有激活角色，则会随机选择一个扬声器，忽略所有其他条件。 列表顺序 角色是根据它们在组成员列表中出现的顺序起草的。没有其他规则适用。 集合订单 激活一个自上次用户消息以来尚未发言的随机角色。如果所有角色都发言，则随机选择一个，直到下一条用户消息。 组生成处理方式 该设置决定如何处理群聊成员的角色信息。无论选择如何，群聊历史记录始终在所有成员之间共享。 交换角色卡 默认模式。每次生成消息时，上下文中仅包含当前说话者的角色卡信息。 加入角色卡 所有群组成员的信息按照其列表顺序组合成一个联合提示词。这在不希望更改大块上下文的情况下会有所帮助，例如使用 llama.cpp 提示词缓存。 该模式有两种子模式（必须选择其一）： 包括静音 - 静音角色将始终包含在关节提示词中。 排除静音 - 如果静音角色不是当前发言者，则不会将其包括在内。 以下字段正在合并： 描述 场景（如果未针对聊天覆盖） 个性 消息示例 角色音符/深度提示词 重要！ 请注意，由于典型的角色卡的结构，使用此模式可能会导致意外的行为，包括但不限于：角色对自己感到困惑、性格合并、特质不确定等。 连接前缀和后缀 当选择“Join 角色卡”时，角色的所有相应字段将被连接在一起。这意味着在生成的提示词中，所有角色描述都将连接到一大块文本中。如果您希望分隔这些字段，您可以定义前缀和/或后缀。 这些选项支持普通宏，并且还将 {{char}} 替换为相关角色的名称，并将 <FIELDNAME> 替换为部件的名称（例如：描述、个性、场景等） 其他群聊菜单选项 静音角色 群聊菜单中角色头像旁边的删除线气泡图标可以禁用或启用聊天中特定角色的回复。 强制说话 群聊菜单中角色头像旁边的对话气泡图标将仅触发来自特定角色的回复，绕过回复顺序策略。即使群组成员被静音，它也会起作用。 自动模式 启用自动模式后，群聊将按照回复顺序触发消息生成，无需用户交互。当最后起草的角色发送其消息时，5 秒延迟后触发下一次自动模式转向。当用户开始在发送消息文本区域中键入内容时，自动模式将被禁用，但已排队的生成不会自动停止。 允许自我回应 选择自然顺序时，如果碰巧因自提而触发，将允许每回合发送最新消息的角色连续回复。对列表顺序没有影响。 群聊场景覆盖 所有组成员都将使用输入的场景文本，而不是其角色卡中指定的内容。分支聊天从其父级继承场景覆盖，并且可以在之后单独更改。 查看角色定义 单击群聊菜单中头像旁边的角色卡图标将快速导航到常用的角色定义屏幕。此处所做的任何更改都将保存到卡本身。 要返回群聊，请单击“群组名称”标题链接。 会员管理 您可以在群聊中添加、删除、静音或重新排序任何现有的角色。默认情况下，新成员会添加到群组成员列表的顶部，然后可以使用箭头图标重新排序。 群聊弹出窗口 单击“当前成员”字段旁边的图标可以激活群聊菜单弹出窗口。这将创建一个群聊菜单的弹出窗口。通过从用户设置中启用 MovingUI，该菜单可以调整大小并拖动到界面内的任何位置，并且功能就像常规群聊菜单一样。",
      "translationStatus": "machine-draft"
    },
    {
      "slug": "core-concepts/tags",
      "title": "标签",
      "group": "Characters",
      "order": 60,
      "source": "Usage/Characters/tags.md",
      "sourceUrl": "https://docs.sillytavern.app/usage/core-concepts/tags/",
      "sourceSha256": "ed925234120fd82be429802095459881a352050caaff59155b28f3b33ac33d51",
      "headings": [
        {
          "id": "tags",
          "depth": 1,
          "title": "标签"
        },
        {
          "id": "tagging",
          "depth": 2,
          "title": "标记"
        },
        {
          "id": "managing",
          "depth": 2,
          "title": "管理"
        },
        {
          "id": "importing-tags-when-importing-character-cards",
          "depth": 2,
          "title": "导入角色卡时导入标签"
        },
        {
          "id": "filtering-character-cards",
          "depth": 2,
          "title": "过滤角色卡"
        },
        {
          "id": "tags-as-folders",
          "depth": 2,
          "title": "标签作为文件夹"
        }
      ],
      "content": "# 标签\n\n角色卡和组可以分配零个或多个标签。它们对于按主题、质量、出处或您喜欢的任何内容组织快速增长的收藏很有用。\n\n## 标记\n\n有多种方法可以向角色卡添加或删除标签：\n\n- 在导入过程中导入嵌入标签。\n- 从角色管理面板打开卡。从那里您将能够为角色卡分配标签。\n- 批量标记。\n\n要进行批量标记，请单击“批量编辑角色”按钮（铅笔图标），选择要标记的卡片，右键单击其中任何卡片，然后单击上下文菜单中的“标记”。\n\n> **注意事项**\n>\n> 请注意，无法对群组进行批量标记。\n\n从该屏幕您将能够：\n\n- 使用组合框添加或删除标签。\n- 从所选卡片中删除所有标签（“全部”）。\n- 从这些卡中删除所有选定卡之间的标签交集（“相互”）。\n- 导入（本地创建）存储在角色卡中的所有标签，以防您导入它（“全部导入”）。\n- 导入（本地创建）存储在角色卡中的标签，这些标签也存在于本地且具有匹配的名称（“导入现有”）。\n\n## 管理\n\n要查看和管理所有现有标签，请打开角色管理面板，然后单击“管理标签”按钮（齿轮图标）。\n\n您可以使用右上角的按钮备份和恢复此处的所有信息（标签列表、卡片的标签分配、颜色、文件夹设置等）。\n\n您可以使用左侧的夹点按钮对标签重新排序，因为它们将显示在角色管理的标签过滤器中。\n\n> **警告**\n>\n> 标签备份 JSON 文件不适合与其他人共享，因为它仅包含特定于您的实例的信息，例如内部实体名称！\n\n## 导入角色卡时导入标签\n\n从下载的图像（或从“从外部 URL 导入内容”按钮）导入外部角色卡时，系统会提示您选择导入其中包含的标签。卡的功能不需要它们；标签只是有组织性的。\n\n嵌入式卡标签存储在角色编辑器的“高级定义”菜单的“创建者元数据”部分中。如果您希望向要导入角色的其他用户建议一些标签，请使用逗号分隔的标签列表填充“要嵌入的标签”字段。\n\n> **注意事项**\n>\n> 仅当用户设置选项“导入卡标签”设置为“询问”时，才会出现此弹出窗口。\n\n在打开的“导入角色名称标签”弹出窗口中，您将看到现有标签（您本地已有且名称匹配）和新标签（您本地没有）的列表。\n\n您可以：\n\n- 根据需要修剪列表，然后点击“导入” - 剩余的现有标签将添加到导入的角色卡中，剩余的新标签将在本地创建，然后添加到卡中。\n- 或者只需点击“不导入”即可忽略角色卡中包含的标签并仅导入该卡。\n- 或者“导入全部”作为导入角色卡中找到的所有标签的快捷方式（注意：包括您从上面列表中修剪的任何标签；如果这样做，请使用“导入”按钮）。\n- 或者“导入现有”作为仅导入本地存在且名称匹配的标签的快捷方式。\n\n## 过滤角色卡\n\n创建标签后，您将在角色管理面板中的一行中看到它们。您可以点击这些来切换标签过滤状态；按顺序：\n\n- 单击一下即可显示标有此标签的卡片。\n- 再次单击仅显示未标记此标签的卡片。\n- 再次单击可重置此标签的过滤。\n\n您可以同时按任意数量的标签进行过滤。\n\n## 标签作为文件夹\n\n> **注意事项**\n>\n> 要使用此功能，必须首先在“用户设置”的“UI 主题”列下启用它。此切换的状态也会随 UI 主题一起保存。\n\n从“管理标签”按钮（齿轮图标），每个标签条目都有一个多状态切换按钮，可在这些标签即文件夹模式之间循环（在代码中称为“虚假文件夹”）：\n\n- 一键将此标签变成“打开的文件夹”。它将在卡片列表中显示为虚拟条目；单击它只会显示带有该标签的卡片\n- 再次单击可将此标签变成“关闭的文件夹”。如上所述，但默认情况下不会显示标有此标签的卡片 - 您需要单击进入文件夹才能看到它们。\n- 再次单击可重置此标签的标签为文件夹状态。\n",
      "searchText": "标签 角色卡和组可以分配零个或多个标签。它们对于按主题、质量、出处或您喜欢的任何内容组织快速增长的收藏很有用。 标记 有多种方法可以向角色卡添加或删除标签： 在导入过程中导入嵌入标签。 从角色管理面板打开卡。从那里您将能够为角色卡分配标签。 批量标记。 要进行批量标记，请单击“批量编辑角色”按钮（铅笔图标），选择要标记的卡片，右键单击其中任何卡片，然后单击上下文菜单中的“标记”。 注意事项 请注意，无法对群组进行批量标记。 从该屏幕您将能够： 使用组合框添加或删除标签。 从所选卡片中删除所有标签（“全部”）。 从这些卡中删除所有选定卡之间的标签交集（“相互”）。 导入（本地创建）存储在角色卡中的所有标签，以防您导入它（“全部导入”）。 导入（本地创建）存储在角色卡中的标签，这些标签也存在于本地且具有匹配的名称（“导入现有”）。 管理 要查看和管理所有现有标签，请打开角色管理面板，然后单击“管理标签”按钮（齿轮图标）。 您可以使用右上角的按钮备份和恢复此处的所有信息（标签列表、卡片的标签分配、颜色、文件夹设置等）。 您可以使用左侧的夹点按钮对标签重新排序，因为它们将显示在角色管理的标签过滤器中。 警告 标签备份 JSON 文件不适合与其他人共享，因为它仅包含特定于您的实例的信息，例如内部实体名称！ 导入角色卡时导入标签 从下载的图像（或从“从外部 URL 导入内容”按钮）导入外部角色卡时，系统会提示您选择导入其中包含的标签。卡的功能不需要它们；标签只是有组织性的。 嵌入式卡标签存储在角色编辑器的“高级定义”菜单的“创建者元数据”部分中。如果您希望向要导入角色的其他用户建议一些标签，请使用逗号分隔的标签列表填充“要嵌入的标签”字段。 注意事项 仅当用户设置选项“导入卡标签”设置为“询问”时，才会出现此弹出窗口。 在打开的“导入角色名称标签”弹出窗口中，您将看到现有标签（您本地已有且名称匹配）和新标签（您本地没有）的列表。 您可以： 根据需要修剪列表，然后点击“导入” - 剩余的现有标签将添加到导入的角色卡中，剩余的新标签将在本地创建，然后添加到卡中。 或者只需点击“不导入”即可忽略角色卡中包含的标签并仅导入该卡。 或者“导入全部”作为导入角色卡中找到的所有标签的快捷方式（注意：包括您从上面列表中修剪的任何标签；如果这样做，请使用“导入”按钮）。 或者“导入现有”作为仅导入本地存在且名称匹配的标签的快捷方式。 过滤角色卡 创建标签后，您将在角色管理面板中的一行中看到它们。您可以点击这些来切换标签过滤状态；按顺序： 单击一下即可显示标有此标签的卡片。 再次单击仅显示未标记此标签的卡片。 再次单击可重置此标签的过滤。 您可以同时按任意数量的标签进行过滤。 标签作为文件夹 注意事项 要使用此功能，必须首先在“用户设置”的“UI 主题”列下启用它。此切换的状态也会随 UI 主题一起保存。 从“管理标签”按钮（齿轮图标），每个标签条目都有一个多状态切换按钮，可在这些标签即文件夹模式之间循环（在代码中称为“虚假文件夹”）： 一键将此标签变成“打开的文件夹”。它将在卡片列表中显示为虚拟条目；单击它只会显示带有该标签的卡片 再次单击可将此标签变成“关闭的文件夹”。如上所述，但默认情况下不会显示标有此标签的卡片 - 您需要单击进入文件夹才能看到它们。 再次单击可重置此标签的标签为文件夹状态。",
      "translationStatus": "machine-draft"
    },
    {
      "slug": "core-concepts/authors-note",
      "title": "作者注释",
      "group": "Characters",
      "order": 50,
      "source": "Usage/Characters/Author's-Note.md",
      "sourceUrl": "https://docs.sillytavern.app/usage/core-concepts/authors-note/",
      "sourceSha256": "f0579fb343d39d920246513d5241fc744246edca1318c96939f4324639255b6c",
      "headings": [
        {
          "id": "authors-note",
          "depth": 1,
          "title": "作者注释"
        },
        {
          "id": "what-is-it",
          "depth": 2,
          "title": "它是什么？"
        },
        {
          "id": "usage",
          "depth": 2,
          "title": "使用指南"
        },
        {
          "id": "configuring-authors-notes",
          "depth": 2,
          "title": "配置作者注释"
        },
        {
          "id": "chat-specific-authors-note",
          "depth": 3,
          "title": "聊天专用作者注释"
        },
        {
          "id": "placement-options",
          "depth": 3,
          "title": "安置选项"
        },
        {
          "id": "after-scenario",
          "depth": 4,
          "title": "场景结束后"
        },
        {
          "id": "in-chat",
          "depth": 4,
          "title": "聊天中"
        },
        {
          "id": "insertion-frequency",
          "depth": 3,
          "title": "插入频率"
        },
        {
          "id": "default-authors-note",
          "depth": 3,
          "title": "默认作者注释"
        },
        {
          "id": "common-use-cases",
          "depth": 2,
          "title": "常见用例"
        },
        {
          "id": "remind-ai-of-response-formatting",
          "depth": 3,
          "title": "提醒 AI 响应格式"
        },
        {
          "id": "reinforcing-instructions",
          "depth": 3,
          "title": "强化指示"
        },
        {
          "id": "as-temporary-world-info-character-bias-or-instruct-for-non-instruct-models",
          "depth": 3,
          "title": "作为临时世界书、角色 Bias 或非指令模型的指令"
        }
      ],
      "content": "# 作者注释\n\n## 它是什么？\n\n作者注释是一款用于自定义 AI 响应的强大工具，它可以在您想要的任何位置、以任何频率将一段文本插入到提示词中。\n\n## 使用指南\n\n作者注释可以在聊天输入栏左侧的选项菜单中找到。\n\n| 选项菜单                                                   | 作者注释面板                                                  |\n| ------------------------------------------------------ | ------------------------------------------------------- |\n| ![](/docs/sillytavern/static/extensions/note-menu.png) | ![](/docs/sillytavern/static/extensions/note-panel.png) |\n\n## 配置作者注释\n\n### 聊天专用作者注释\n\n作者注释面板顶部的框包含当前聊天的作者注释。\n\n**此框的内容不会自动转移到任何新的聊天中。**\n\n### 安置选项\n\n#### 场景结束后\n\n这会将作者注释置于角色定义的“场景”部分之后的上下文顶部。如果未指定场景，它将被放置在角色定义的最后部分之后、示例消息之前。\n\n#### 聊天中\n\n这会将作者注释放入聊天历史记录中指定的深度。\n\n深度 0 = 放置在聊天历史记录的最后。\n\n深度 4 = 放置在最近 3 条聊天记录消息之前，使其成为聊天记录中的第 4 个实体。\n\n*作者注释距离提示词的底部越近，对下一步 AI 响应的影响就越大。*\n\n### 插入频率\n\n这是您希望作者注释包含在聊天中的频率。\n\n频率 0 = 作者注释永远不会被插入。\n\n频率 1 = 作者注释将随每个用户输入提示词一起插入。\n\n频率 4 = 作者注释将插入到每 4 个用户输入提示词中。\n\n### 默认作者注释\n\n面板底部的框包含默认作者注释，它将应用于每个新聊天。\n\n## 常见用例\n\n### 提醒 AI 响应格式\n\n作者注释可用于指定 AI 应如何编写其响应。\n\n- \\[您的下一个回复长度必须为 300 token。]\n- \\[以埃德加·爱伦·坡的风格写下你的下一条回复]\n- \\[使用 markdown 斜体表示未说出的操作，使用引号表示说出的单词。]\n\n### 强化指示\n\n- \\[记住在聊天开始时给你的指示。]\n\n### 作为临时世界书、角色 Bias 或非指令模型的指令\n\n- \\[{{char}}在图书馆]\n- \\[{{user}} 腿上有新伤，所以无法逃跑。]\n- \\[{{char}} 无法说话，必须使用手势进行交流。]\n",
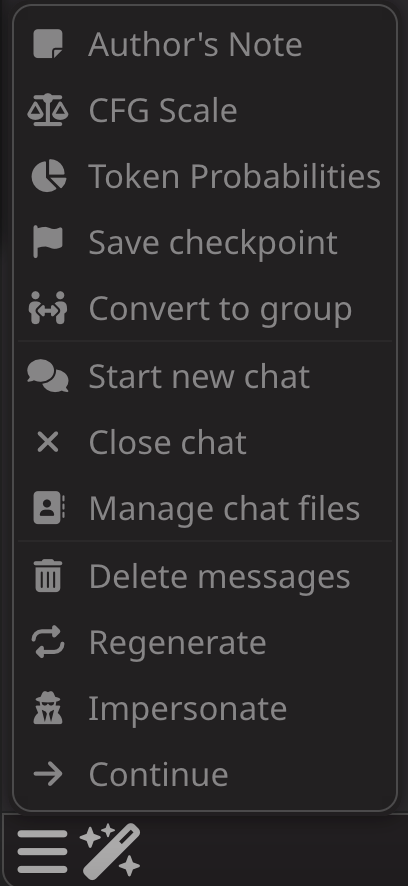
      "searchText": "作者注释 它是什么？ 作者注释是一款用于自定义 AI 响应的强大工具，它可以在您想要的任何位置、以任何频率将一段文本插入到提示词中。 使用指南 作者注释可以在聊天输入栏左侧的选项菜单中找到。 选项菜单 作者注释面板 配置作者注释 聊天专用作者注释 作者注释面板顶部的框包含当前聊天的作者注释。 此框的内容不会自动转移到任何新的聊天中。 安置选项 场景结束后 这会将作者注释置于角色定义的“场景”部分之后的上下文顶部。如果未指定场景，它将被放置在角色定义的最后部分之后、示例消息之前。 聊天中 这会将作者注释放入聊天历史记录中指定的深度。 深度 0 = 放置在聊天历史记录的最后。 深度 4 = 放置在最近 3 条聊天记录消息之前，使其成为聊天记录中的第 4 个实体。 作者注释距离提示词的底部越近，对下一步 AI 响应的影响就越大。 插入频率 这是您希望作者注释包含在聊天中的频率。 频率 0 = 作者注释永远不会被插入。 频率 1 = 作者注释将随每个用户输入提示词一起插入。 频率 4 = 作者注释将插入到每 4 个用户输入提示词中。 默认作者注释 面板底部的框包含默认作者注释，它将应用于每个新聊天。 常见用例 提醒 AI 响应格式 作者注释可用于指定 AI 应如何编写其响应。 [您的下一个回复长度必须为 300 token。] [以埃德加·爱伦·坡的风格写下你的下一条回复] [使用 markdown 斜体表示未说出的操作，使用引号表示说出的单词。] 强化指示 [记住在聊天开始时给你的指示。] 作为临时世界书、角色 Bias 或非指令模型的指令 [{{char}}在图书馆] [{{user}} 腿上有新伤，所以无法逃跑。] [{{char}} 无法说话，必须使用手势进行交流。]",
      "translationStatus": "machine-draft"
    },
    {
      "slug": "core-concepts/data-bank",
      "title": "资料库",
      "group": "Characters",
      "order": 30,
      "source": "Usage/Characters/data-bank.md",
      "sourceUrl": "https://docs.sillytavern.app/usage/core-concepts/data-bank/",
      "sourceSha256": "e6125eb63ac3183a73fcad53b2d525d6660f36c819f9f513f5107ae3295c309d",
      "headings": [
        {
          "id": "data-bank-rag",
          "depth": 1,
          "title": "资料库"
        },
        {
          "id": "accessing-the-data-bank",
          "depth": 2,
          "title": "访问资料库"
        },
        {
          "id": "about-documents",
          "depth": 2,
          "title": "关于文件"
        },
        {
          "id": "data-sources",
          "depth": 2,
          "title": "数据来源"
        },
        {
          "id": "notepad",
          "depth": 3,
          "title": "记事本"
        },
        {
          "id": "file",
          "depth": 3,
          "title": "文件"
        },
        {
          "id": "web",
          "depth": 3,
          "title": "网络"
        },
        {
          "id": "youtube",
          "depth": 3,
          "title": "YouTube"
        },
        {
          "id": "web-search",
          "depth": 3,
          "title": "网页搜索"
        },
        {
          "id": "fandom",
          "depth": 3,
          "title": "粉丝圈"
        },
        {
          "id": "bronie-parser-extension-third-party",
          "depth": 3,
          "title": "Bronie 解析器扩展（第三方）"
        },
        {
          "id": "vector-storage",
          "depth": 2,
          "title": "矢量存储"
        },
        {
          "id": "vector-providers",
          "depth": 2,
          "title": "载体提供者"
        },
        {
          "id": "local",
          "depth": 3,
          "title": "本地"
        },
        {
          "id": "api-sources",
          "depth": 3,
          "title": "API来源"
        },
        {
          "id": "vectorization-settings",
          "depth": 2,
          "title": "矢量化设置"
        },
        {
          "id": "message-attachments",
          "depth": 3,
          "title": "留言附件"
        },
        {
          "id": "data-bank-files",
          "depth": 3,
          "title": "资料库文件"
        },
        {
          "id": "shared-settings",
          "depth": 3,
          "title": "共享设置"
        },
        {
          "id": "conclusion",
          "depth": 2,
          "title": "结论"
        }
      ],
      "content": "# 资料库\n\n检索增强生成（RAG）是一种为法学硕士提供外部知识来源的技术。它通过访问模型训练数据之外的信息来帮助提高人工智能答案的准确性。\n\nSillyTavern 提供了一组工具，用于从多种来源构建多用途知识库，以及使用 LLM 提示词中收集的数据。\n\n## 访问资料库\n\n内置的聊天附件扩展（默认情况下包含在发行版本 >= 1.12.0 中）在“魔棒”菜单中添加了一个新选项 - 资料库。这是您管理 SillyTavern 中 RAG 可用文档的中心。\n\n## 关于文件\n\n资料库存储文件附件，也称为文档。这些文档分为三个可用范围。\n\n1. 全局附件 - 在每个聊天中都可用，无论是单独还是群组。\n2. 角色附件 - 仅适用于当前选择的角色，包括当他们在群组中回复时。 *附件保存在本地，不会通过角色卡导出！*\n3. 聊天附件 - 仅在当前打开的聊天中可用。聊天中的每个角色都可以从中拉取。\n\n> **注意事项**\n>\n> 虽然不是数据库的正式组成部分，但您甚至可以将文件附加到单条消息中。使用“Wand”菜单中的“附加文件”选项，或消息操作行中的回形针图标。\n\n什么可以是文档？实际上任何可以纯文本形式表示的东西！\n\n示例包括但不限于：\n\n- 本地文件（书籍、科学论文等）\n- 网页（维基百科、文章、新闻）\n- 视频文字记录\n\n各种扩展和插件还可以提供收集和处理数据的新方法，更多信息如下。\n\n## 数据来源\n\n要将文档添加到任何范围，请单击“添加”并选择可用来源之一。\n\n### 记事本\n\n从头开始创建文本文件，或编辑现有附件。\n\n### 文件\n\n从计算机的硬盘上传文件。 SillyTavern 提供流行文件格式的内置转换器：\n\n- PDF（仅限文本）\n- 超文本标记语言\n- 降价\n- 电子书\n- TXT\n\n您还可以附加任何带有非标准扩展名的文本文件，例如 JSON、YAML、源代码等。如果所选文件的类型没有已知的转换，并且该文件无法解析为纯文本文档，则文件上传将被拒绝，这意味着不允许使用原始二进制文件。\n\n> **注意事项**\n>\n> 导入 Microsoft Office（DOCX、PPTX、XLSX）和 LibreOffice 文档（ODT、ODP、ODS）需要 [服务器插件](https://github.com/SillyTavern/SillyTavern-Office-Parser) 进行安装和加载。有关安装说明，请参阅插件的自述文件页面。\n\n### 网络\n\n通过 URL 从网页中抓取文本。然后通过以下方式处理 HTML 文档 [可读性](https://github.com/mozilla/readability) 库仅提取可用的文本。\n\n某些 Web 服务器可能会拒绝获取请求、受到 Cloudflare 保护或严重依赖 JavaScript 来运行。如果您在任何特定网站上遇到问题，请通过网络浏览器手动下载该页面并使用文件上传器附加它。\n\n### YouTube\n\n通过 ID 或 URL 下载 YouTube 视频的文字记录，可以由创作者上传，也可以由 Google 自动生成。有些视频可能会禁用文字记录，而且由于需要登录，因此无法解析有年龄限制的视频。\n\n脚本以视频的默认语言加载。或者，您可以指定两个字母的语言代码来尝试获取特定语言的文字记录。此功能并不总是可用，并且可能会失败，因此请谨慎使用。\n\n### 网页搜索\n\n> **注意事项**\n>\n> 该源需要有一个 [网页搜索](https://docs.sillytavern.app/extensions/websearch/) 扩展已安装并正确配置。请参阅链接页面了解更多详细信息。\n\n执行网络搜索并从搜索结果页面下载文本。这与 Web 源类似，但完全自动化。所选的搜索引擎将从扩展设置继承，因此请提前设置。\n\n首先，指定搜索查询、要访问的最大链接数以及输出类型：一个组合文件（根据扩展规则格式化）或每个页面的单个文件。您也可以选择保存页面片段。\n\n### 粉丝圈\n\n> **注意事项**\n>\n> 该源需要有一个 [服务器插件](https://github.com/SillyTavern/SillyTavern-Fandom-Scraper) 安装并加载。有关安装说明，请参阅插件的自述文件页面。\n\n从a中抓取文章 [粉丝圈](https://www.fandom.com/) wiki 通过其 ID 或 URL。由于一些 wiki 非常大，使用过滤器正则表达式限制范围可能会有好处，它将根据文章的标题进行测试。如果未提供过滤器，则所有页面都将被导出。您可以将它们保存为每个页面的单独文件，也可以合并到一个文档中。\n\n### Bronie 解析器扩展（第三方）\n\n> **注意事项**\n>\n> 该来源来自第三方，并且是 **不隶属** 与 SillyTavern 团队。这个来源需要你有布洛妮娅·兰德的 [Bronie 解析器扩展](https://github.com/Bronya-Rand/Bronie-Parser-Extension) 安装以及需要解析器工作的服务器插件。\n\nBronya Rand 的 Bronie Parser Extension 允许使用第三方抓取工具，例如 miHoYo/HoYoverse 的 [好友实验室](https://wiki.hoyolab.com) 转换为 SillyTavern，与其他数据源类似。\n\n目前，Bronya Rand 的 Bronie Parser Extension 支持以下内容：\n\n- 米哈游 / HoYoverse 的 HoYoLab（用于《原神》和《崩坏：星穹铁道》），通过 [HoYoWiki-Scraper-TS](https://github.com/Bronya-Rand/HoYoWiki-Scraper-TS)\n\n首先，按照以下步骤安装 Bronya Rand 的 Bronie Parser Extension： [安装指南](https://github.com/Bronya-Rand/Bronie-Parser-Extension?tab=readme-ov-file#installation) 并将支持的服务器插件安装到 SillyTavern 中。重启SillyTavern，进入 *资料库* 菜单。点击 `+ Add` 您应该会看到最近安装的抓取工具已添加到可以从中获取信息的来源列表中。\n\n## 矢量存储\n\n因此，您已经为自己建立了一个关于您的特定主题的良好且全面的信息库。接下来怎么办？\n\n要使用 RAG 文档，您需要使用兼容的扩展，将相关数据插入到 LLM 提示词中。\n\n与 SillyTavern 捆绑在一起的矢量存储是此类扩展的参考实现。它使用嵌入（也称为向量）来搜索与您正在进行的聊天相关的文档。\n\n> **有趣的事实**\n>\n> 1. 嵌入是抽象表示一段文本的数字数组，由专门的语言模型生成。越相似的文本其各自向量之间的距离越短。\n> 2. 矢量存储扩展使用 [威达](https://github.com/Stevenic/vectra) 库来跟踪文件嵌入。它们存储在 JSON 文件中 `/vectors` 您的用户数据目录的文件夹。每个文档在内部都由其自己的索引/集合文件表示。\n\n由于矢量功能默认处于禁用状态，因此您需要打开扩展面板（顶部栏上的“堆叠立方体”图标），然后导航到“矢量存储”部分，并勾选“文件矢量化设置”下的“为文件启用”复选框。\n\n向量存储本身不会产生任何向量，您需要使用兼容的嵌入提供程序。\n\n## 载体提供者\n\n> **警告**\n>\n> 仅当使用生成嵌入的同一模型检索嵌入时，嵌入才可用。当改变嵌入模型或源时，需要重新计算向量。\n\n### 本地\n\n这些来源是免费且无限制的，并使用您的 CPU/GPU 来计算嵌入。\n\n1. 本地（Transformers）- 在节点服务器上运行。 SillyTavern 会自动从 HuggingFace 下载 ONNX 格式的兼容模型。默认型号： [jina-embeddings-v2-base-en](https://huggingface.co/Cohee/jina-embeddings-v2-base-en).\n2. WebLLM - 需要安装扩展程序和网络浏览器 [支持WebGPU](https://caniuse.com/webgpu)。直接在浏览器中运行，可以使用硬件加速。自动从 HuggingFace 下载支持的模型。从这里安装扩展： <https://github.com/SillyTavern/Extension-WebLLM>.\n3. 奥拉马 - 获取它 <https://ollama.com/>。在API连接菜单中设置API URL（在文本补全下，默认： `http://localhost:11434`）。必须先下载兼容的模型，然后在扩展设置中设置其名称。型号示例： [mxbai-嵌入-大](https://ollama.com/library/mxbai-embed-large)。 （可选）选中一个选项以将模型加载到内存中。\n4. llama.cpp 服务器 - 获取它 [ggerganov/llama.cpp](https://github.com/ggerganov/llama.cpp) 并运行服务器可执行文件 `--embedding` 标志。从 HuggingFace 加载兼容的 GGUF 嵌入模型，例如， [nomic-ai/nomic-embed-text-v1.5-GGUF](https://huggingface.co/nomic-ai/nomic-embed-text-v1.5-GGUF).\n5. vLLM - 获取它 [vllm-项目/vllm](https://github.com/vllm-project/vllm)。首先在API连接菜单中设置API URL和API密钥。\n6. Extras（已弃用）- 在 [附加 API](https://github.com/SillyTavern/SillyTavern-extras) 使用 SentenceTransformers 加载器。默认型号： [全 mpnet 基础 v2](https://huggingface.co/sentence-transformers/all-mpnet-base-v2)。此源未得到维护，将来最终将被删除。\n\n### API来源\n\n所有这些来源都需要相应服务的 API 密钥，并且通常会产生使用成本，但通常计算嵌入非常便宜。\n\n1. 开放人工智能\n2. 连贯\n3. 谷歌人工智能工作室\n4. 谷歌顶点人工智能\n5. 一起人工智能\n6. 米斯特拉尔人工智能\n7. 诺米克人工智能\n8. 开放路由器\n9. 电子集线器\n10. 滑道\n11. 纳米GPT\n12. 硅流\n13. Cloudflare Workers AI\n\n## 矢量化设置\n\n选择嵌入提供程序后，不要忘记配置其他设置来定义处理和检索文档的规则。\n\n> **注意事项**\n>\n> 从附件中分割、矢量化和检索信息需要一些时间。虽然文件的初始摄取可能需要一段时间，但 RAG 搜索查询通常足够快，不会造成明显的延迟。\n\n### 留言附件\n\n这些设置控制直接附加到邮件的文件。\n\n以下规则适用：\n\n1. 只有适合 LLM 上下文窗口的邮件才能检索其附件。\n2. 当矢量存储扩展被禁用时，文件附件及其附带消息将完全插入提示词中。\n3. 启用文件矢量化后，文件将被分割成块，并且仅插入最相关的部分，从而节省上下文空间并允许模型保持专注。\n\n- 大小阈值 (KB) - 设置分块分割阈值。只有大于指定大小的文件才会被分割。\n- 块大小（字符）- 设置单个块的目标大小（在文本角色中，而不是模型 token！）。\n- 块重叠 (%) - 设置相邻块之间共享的块大小的百分比。这允许块之间更平滑的过渡，但也可能引入一些冗余。\n- 检索块 - 设置要检索的最相关文件块的最大数量。它们将按原始顺序插入。\n\n### 资料库文件\n\n这些设置控制资料库文档的处理方式。\n\n以下规则适用：\n\n1. 禁用文件矢量化时，不使用资料库。\n2. 否则，当前范围（见上文）中的所有可用文档都将被考虑用于查询。仅检索所有文件中最相关的块。同一文件的多个块按其原始顺序插入。\n3. 插入的块将在适合聊天消息之前保留一部分上下文。\n\n- 大小阈值 (KB) - 设置分块分割阈值。只有大于指定大小的文件才会被分割。\n- 块大小（字符）- 设置单个块的目标大小（在文本角色中，而不是模型 token！）。\n- 块重叠 (%) - 设置相邻块之间共享的块大小的百分比。这允许块之间更平滑的过渡，但也可能引入一些冗余。\n- 检索块 - 设置要检索的文件块的最大数量。该限额在所有文件之间共享。\n- 注入模板 - 定义如何将检索到的信息插入到提示词中。您可以使用特殊的 {{text}} 宏以及任何其他宏来指定检索到的文本的位置。\n- 注射位置 - 设置插入提示词注射的位置。适用与作者注释和世界书相同的规则。\n\n### 共享设置\n\n- 查询消息 - 有多少最新的聊天消息将用于查询文档块。\n- 分数阈值 - 调整以允许根据相关性分数剔除块的检索（0 - 根本不匹配，1 - 完美匹配）。较高的值允许更准确的检索并防止完全随机的信息进入上下文。 Sane 值的范围在 0.2（更宽松）和 0.5（更集中）之间。\n- 块边界 - 将文件拆分为块时将优先考虑的自定义字符串。如果未指定，则默认按（按顺序）双换行符、单换行符和单词之间的空格进行分割。\n- 仅在自定义边界上分块 - 如果启用，分块将仅发生在指定的块边界上。否则，分块也会发生在默认边界上。\n- 在处理之前将文件翻译成英语 - 如果启用，将使用在 [聊天翻译](https://docs.sillytavern.app/extensions/translation/) 扩展名在处理文件之前将文件翻译成英语。当使用仅支持英文文本的嵌入模型时，这非常有用。\n- 包含在世界书扫描中 - 检查是否希望注入的内容激活传说书籍条目。\n- Vectorize All - 强制摄取所有未处理文件的嵌入。\n- 清除向量 - 清除文件嵌入，允许重新计算它们的向量。\n\n> **注意事项**\n>\n> 对于“聊天矢量化”设置，请参阅 [聊天矢量化](https://docs.sillytavern.app/extensions/chat-vectorization/).\n\n## 结论\n\n恭喜！ RAG 的强大功能现在增强了您的聊天体验。它的功能仅受您的想象力的限制。一如既往，不要害怕尝试！\n",
      "searchText": "资料库 检索增强生成（RAG）是一种为法学硕士提供外部知识来源的技术。它通过访问模型训练数据之外的信息来帮助提高人工智能答案的准确性。 SillyTavern 提供了一组工具，用于从多种来源构建多用途知识库，以及使用 LLM 提示词中收集的数据。 访问资料库 内置的聊天附件扩展（默认情况下包含在发行版本 >= 1.12.0 中）在“魔棒”菜单中添加了一个新选项 - 资料库。这是您管理 SillyTavern 中 RAG 可用文档的中心。 关于文件 资料库存储文件附件，也称为文档。这些文档分为三个可用范围。 全局附件 - 在每个聊天中都可用，无论是单独还是群组。 角色附件 - 仅适用于当前选择的角色，包括当他们在群组中回复时。 附件保存在本地，不会通过角色卡导出！ 聊天附件 - 仅在当前打开的聊天中可用。聊天中的每个角色都可以从中拉取。 注意事项 虽然不是数据库的正式组成部分，但您甚至可以将文件附加到单条消息中。使用“Wand”菜单中的“附加文件”选项，或消息操作行中的回形针图标。 什么可以是文档？实际上任何可以纯文本形式表示的东西！ 示例包括但不限于： 本地文件（书籍、科学论文等） 网页（维基百科、文章、新闻） 视频文字记录 各种扩展和插件还可以提供收集和处理数据的新方法，更多信息如下。 数据来源 要将文档添加到任何范围，请单击“添加”并选择可用来源之一。 记事本 从头开始创建文本文件，或编辑现有附件。 文件 从计算机的硬盘上传文件。 SillyTavern 提供流行文件格式的内置转换器： PDF（仅限文本） 超文本标记语言 降价 电子书 TXT 您还可以附加任何带有非标准扩展名的文本文件，例如 JSON、YAML、源代码等。如果所选文件的类型没有已知的转换，并且该文件无法解析为纯文本文档，则文件上传将被拒绝，这意味着不允许使用原始二进制文件。 注意事项 导入 Microsoft Office（DOCX、PPTX、XLSX）和 LibreOffice 文档（ODT、ODP、ODS）需要 服务器插件 进行安装和加载。有关安装说明，请参阅插件的自述文件页面。 网络 通过 URL 从网页中抓取文本。然后通过以下方式处理 HTML 文档 可读性 库仅提取可用的文本。 某些 Web 服务器可能会拒绝获取请求、受到 Cloudflare 保护或严重依赖 JavaScript 来运行。如果您在任何特定网站上遇到问题，请通过网络浏览器手动下载该页面并使用文件上传器附加它。 YouTube 通过 ID 或 URL 下载 YouTube 视频的文字记录，可以由创作者上传，也可以由 Google 自动生成。有些视频可能会禁用文字记录，而且由于需要登录，因此无法解析有年龄限制的视频。 脚本以视频的默认语言加载。或者，您可以指定两个字母的语言代码来尝试获取特定语言的文字记录。此功能并不总是可用，并且可能会失败，因此请谨慎使用。 网页搜索 注意事项 该源需要有一个 网页搜索 扩展已安装并正确配置。请参阅链接页面了解更多详细信息。 执行网络搜索并从搜索结果页面下载文本。这与 Web 源类似，但完全自动化。所选的搜索引擎将从扩展设置继承，因此请提前设置。 首先，指定搜索查询、要访问的最大链接数以及输出类型：一个组合文件（根据扩展规则格式化）或每个页面的单个文件。您也可以选择保存页面片段。 粉丝圈 注意事项 该源需要有一个 服务器插件 安装并加载。有关安装说明，请参阅插件的自述文件页面。 从a中抓取文章 粉丝圈 wiki 通过其 ID 或 URL。由于一些 wiki 非常大，使用过滤器正则表达式限制范围可能会有好处，它将根据文章的标题进行测试。如果未提供过滤器，则所有页面都将被导出。您可以将它们保存为每个页面的单独文件，也可以合并到一个文档中。 Bronie 解析器扩展（第三方） 注意事项 该来源来自第三方，并且是 不隶属 与 SillyTavern 团队。这个来源需要你有布洛妮娅·兰德的 Bronie 解析器扩展 安装以及需要解析器工作的服务器插件。 Bronya Rand 的 Bronie Parser Extension 允许使用第三方抓取工具，例如 miHoYo/HoYoverse 的 好友实验室 转换为 SillyTavern，与其他数据源类似。 目前，Bronya Rand 的 Bronie Parser Extension 支持以下内容： 米哈游 / HoYoverse 的 HoYoLab（用于《原神》和《崩坏：星穹铁道》），通过 HoYoWiki-Scraper-TS 首先，按照以下步骤安装 Bronya Rand 的 Bronie Parser Extension： 安装指南 并将支持的服务器插件安装到 SillyTavern 中。重启SillyTavern，进入 资料库 菜单。点击 + Add 您应该会看到最近安装的抓取工具已添加到可以从中获取信息的来源列表中。 矢量存储 因此，您已经为自己建立了一个关于您的特定主题的良好且全面的信息库。接下来怎么办？ 要使用 RAG 文档，您需要使用兼容的扩展，将相关数据插入到 LLM 提示词中。 与 SillyTavern 捆绑在一起的矢量存储是此类扩展的参考实现。它使用嵌入（也称为向量）来搜索与您正在进行的聊天相关的文档。 有趣的事实 嵌入是抽象表示一段文本的数字数组，由专门的语言模型生成。越相似的文本其各自向量之间的距离越短。 矢量存储扩展使用 威达 库来跟踪文件嵌入。它们存储在 JSON 文件中 /vectors 您的用户数据目录的文件夹。每个文档在内部都由其自己的索引/集合文件表示。 由于矢量功能默认处于禁用状态，因此您需要打开扩展面板（顶部栏上的“堆叠立方体”图标），然后导航到“矢量存储”部分，并勾选“文件矢量化设置”下的“为文件启用”复选框。 向量存储本身不会产生任何向量，您需要使用兼容的嵌入提供程序。 载体提供者 警告 仅当使用生成嵌入的同一模型检索嵌入时，嵌入才可用。当改变嵌入模型或源时，需要重新计算向量。 本地 这些来源是免费且无限制的，并使用您的 CPU/GPU 来计算嵌入。 本地（Transformers）- 在节点服务器上运行。 SillyTavern 会自动从 HuggingFace 下载 ONNX 格式的兼容模型。默认型号： jina-embeddings-v2-base-en. WebLLM - 需要安装扩展程序和网络浏览器 支持WebGPU。直接在浏览器中运行，可以使用硬件加速。自动从 HuggingFace 下载支持的模型。从这里安装扩展： https://github.com/SillyTavern/Extension-WebLLM. 奥拉马 - 获取它 https://ollama.com/。在API连接菜单中设置API URL（在文本补全下，默认： http://localhost:11434）。必须先下载兼容的模型，然后在扩展设置中设置其名称。型号示例： mxbai-嵌入-大。 （可选）选中一个选项以将模型加载到内存中。 llama.cpp 服务器 - 获取它 ggerganov/llama.cpp 并运行服务器可执行文件 --embedding 标志。从 HuggingFace 加载兼容的 GGUF 嵌入模型，例如， nomic-ai/nomic-embed-text-v1.5-GGUF. vLLM - 获取它 vllm-项目/vllm。首先在API连接菜单中设置API URL和API密钥。 Extras（已弃用）- 在 附加 API 使用 SentenceTransformers 加载器。默认型号： 全 mpnet 基础 v2。此源未得到维护，将来最终将被删除。 API来源 所有这些来源都需要相应服务的 API 密钥，并且通常会产生使用成本，但通常计算嵌入非常便宜。 开放人工智能 连贯 谷歌人工智能工作室 谷歌顶点人工智能 一起人工智能 米斯特拉尔人工智能 诺米克人工智能 开放路由器 电子集线器 滑道 纳米GPT 硅流 Cloudflare Workers AI 矢量化设置 选择嵌入提供程序后，不要忘记配置其他设置来定义处理和检索文档的规则。 注意事项 从附件中分割、矢量化和检索信息需要一些时间。虽然文件的初始摄取可能需要一段时间，但 RAG 搜索查询通常足够快，不会造成明显的延迟。 留言附件 这些设置控制直接附加到邮件的文件。 以下规则适用： 只有适合 LLM 上下文窗口的邮件才能检索其附件。 当矢量存储扩展被禁用时，文件附件及其附带消息将完全插入提示词中。 启用文件矢量化后，文件将被分割成块，并且仅插入最相关的部分，从而节省上下文空间并允许模型保持专注。 大小阈值 (KB) - 设置分块分割阈值。只有大于指定大小的文件才会被分割。 块大小（字符）- 设置单个块的目标大小（在文本角色中，而不是模型 token！）。 块重叠 (%) - 设置相邻块之间共享的块大小的百分比。这允许块之间更平滑的过渡，但也可能引入一些冗余。 检索块 - 设置要检索的最相关文件块的最大数量。它们将按原始顺序插入。 资料库文件 这些设置控制资料库文档的处理方式。 以下规则适用： 禁用文件矢量化时，不使用资料库。 否则，当前范围（见上文）中的所有可用文档都将被考虑用于查询。仅检索所有文件中最相关的块。同一文件的多个块按其原始顺序插入。 插入的块将在适合聊天消息之前保留一部分上下文。 大小阈值 (KB) - 设置分块分割阈值。只有大于指定大小的文件才会被分割。 块大小（字符）- 设置单个块的目标大小（在文本角色中，而不是模型 token！）。 块重叠 (%) - 设置相邻块之间共享的块大小的百分比。这允许块之间更平滑的过渡，但也可能引入一些冗余。 检索块 - 设置要检索的文件块的最大数量。该限额在所有文件之间共享。 注入模板 - 定义如何将检索到的信息插入到提示词中。您可以使用特殊的 {{text}} 宏以及任何其他宏来指定检索到的文本的位置。 注射位置 - 设置插入提示词注射的位置。适用与作者注释和世界书相同的规则。 共享设置 查询消息 - 有多少最新的聊天消息将用于查询文档块。 分数阈值 - 调整以允许根据相关性分数剔除块的检索（0 - 根本不匹配，1 - 完美匹配）。较高的值允许更准确的检索并防止完全随机的信息进入上下文。 Sane 值的范围在 0.2（更宽松）和 0.5（更集中）之间。 块边界 - 将文件拆分为块时将优先考虑的自定义字符串。如果未指定，则默认按（按顺序）双换行符、单换行符和单词之间的空格进行分割。 仅在自定义边界上分块 - 如果启用，分块将仅发生在指定的块边界上。否则，分块也会发生在默认边界上。 在处理之前将文件翻译成英语 - 如果启用，将使用在 聊天翻译 扩展名在处理文件之前将文件翻译成英语。当使用仅支持英文文本的嵌入模型时，这非常有用。 包含在世界书扫描中 - 检查是否希望注入的内容激活传说书籍条目。 Vectorize All - 强制摄取所有未处理文件的嵌入。 清除向量 - 清除文件嵌入，允许重新计算它们的向量。 注意事项 对于“聊天矢量化”设置，请参阅 聊天矢量化. 结论 恭喜！ RAG 的强大功能现在增强了您的聊天体验。它的功能仅受您的想象力的限制。一如既往，不要害怕尝试！",
      "translationStatus": "machine-draft"
    },
    {
      "slug": "prompts",
      "title": "提示词",
      "group": "Prompts",
      "order": 140,
      "source": "Usage/Prompts/index.md",
      "sourceUrl": "https://docs.sillytavern.app/usage/prompts/",
      "sourceSha256": "951ea304940995124fc28f921ff825416e95967a032154b6039ea8287cdd45d0",
      "headings": [
        {
          "id": "prompts",
          "depth": 1,
          "title": "提示词"
        },
        {
          "id": "viewing-the-prompt",
          "depth": 2,
          "title": "查看提示词"
        },
        {
          "id": "changing-how-the-prompt-is-built",
          "depth": 2,
          "title": "改变提示词的构建方式"
        },
        {
          "id": "main-prompt-system-prompt",
          "depth": 2,
          "title": "主提示词（系统提示词）"
        },
        {
          "id": "adjusting-the-main-prompt",
          "depth": 3,
          "title": "调整主提示词"
        },
        {
          "id": "effect-of-message-history",
          "depth": 3,
          "title": "消息历史记录的影响"
        },
        {
          "id": "removing-the-fictional-chat-context",
          "depth": 3,
          "title": "删除“虚构聊天”上下文"
        },
        {
          "id": "ai-as-narrator-or-storyteller",
          "depth": 3,
          "title": "人工智能作为叙述者或讲故事的人"
        },
        {
          "id": "post-history-instructions",
          "depth": 2,
          "title": "历史后指令"
        },
        {
          "id": "adding-to-the-prompt-world-info",
          "depth": 2,
          "title": "添加到提示词 (世界书)"
        }
      ],
      "content": "# 提示词\n\n当您向 AI 发送消息时，您编写的文本会与其他文本组合在一起，形成发送给 AI 的单个请求。这种组合文本称为“提示词”，有时也称为“请求”或“上下文”。\n\n提示词可以包含各种不同类型的文本，包括：\n\n- [主要说明](#main-prompt-system-prompt) 向 AI 询问如何生成响应\n- 的定义 [AI应该扮演的角色](/guides/sillytavern/core-concepts/characterdesign/)\n- 的定义 [你所扮演的角色](/guides/sillytavern/core-concepts/personas/)\n- [关于“世界”的信息](/guides/sillytavern/core-concepts/worldinfo/) AI正在与之交互\n- 相关文件或资料来自 [资料库](/guides/sillytavern/core-concepts/data-bank/)\n- [摘要](https://docs.sillytavern.app/extensions/summarize/) 过去的谈话\n- 结果 [网络搜索](https://docs.sillytavern.app/extensions/websearch/) 或其他 [外部数据源](https://docs.sillytavern.app/for-contributors/function-calling/)\n- 对话中的先前消息\n- **你给人工智能的信息**\n- [最终说明](#post-history-instructions) 让人工智能了解如何生成响应\n\n这可能需要管理很多事情！为了帮助您了解如何构建和修改发送到 AI 的请求，SillyTavern 标识了您可能想要包含在提示词中的不同元素。然后，您可以构建提示词，以包含对您想要与 AI 交互的方式有意义的内容。\n\n其中许多元素在您将更改它们的部分中进行了解释。例如，要描述您希望人工智能扮演的角色，您可以使用 [描述](/guides/sillytavern/core-concepts/characterdesign/#personality-summary) 领域在 [角色设计](/guides/sillytavern/core-concepts/characterdesign/).\n\n## 查看提示词\n\n阅读发送给 AI 的最终提示词对于理解 AI 被告知的内容以及为什么它会生成这样的响应非常有帮助。您可以通过多种方式查看提示词：\n\n- 使用 AI 回复消息上的提示词逐项图标\n- 使用 [提示词检验员](https://github.com/SillyTavern/Extension-PromptInspector) 延伸\n- 检查运行 SillyTavern 的终端窗口中的日志\n- 在浏览器的开发者工具中检查控制台\n\n## 改变提示词的构建方式\n\n以正确的方式向人工智能展示提示词的所有部分对于获得最佳响应至关重要。您可以控制提示词的构建方式。\n\n**文本补全 API**\n\n使用 [高级格式设置](/guides/sillytavern/core-concepts/advancedformatting/) 面板为文本补全 API 定制提示词构造。\n\n**聊天补全 API**\n\n使用 [提示词管理器](/guides/sillytavern/prompts/prompt-manager/) 为聊天补全 API 定制提示词构造。\n\n## 主提示词（系统提示词）\n\n主提示词（或系统提示词）定义了模型要遵循的一般指令。它为对话定下了基调和背景。例如，它告诉模型充当 AI 助手、写作伙伴或虚构的角色。\n\n**文本补全 API**\n\n的 [系统提示词](/guides/sillytavern/core-concepts/advancedformatting/#system-prompt) 是的一部分 [故事串](/guides/sillytavern/prompts/context-template/#story-string) 通常是模型收到的提示词的第一部分。\n\n**聊天补全 API**\n\n主提示词是默认提示词之一 [提示词管理器](/guides/sillytavern/prompts/prompt-manager/)。它通常是模型收到的上下文中的第一条消息，归因于系统角色（“发送者”）。\n\n默认的主提示词是：\n\n> 在 {{char}} 和 {{user}} 之间的虚构聊天中写下 {{char}} 的下一条回复。\n\n{{char}} 和 {{user}} 占位符将替换为您在对话中定义的角色和用户人设的名称。\n\n您可以使用任何受支持的 [{{macro}}](/guides/sillytavern/core-concepts/macros/) 主提示词中的标签包含在对话之间可能有所不同或随着对话的进行而变化的信息。\n\n### 调整主提示词\n\n默认的主提示词帮助模型了解预期如何处理后面的角色和用户人设信息、如何解释过去的对话以及生成什么样的响应。它是一个灵活的通用提示词，适用于许多情况，因为它确定 AI 在与用户人设的对话中以角色的形式进行书写。\n\n但是，您可以调整主提示词以更好地满足您的需求。以下是调整主要提示词的一些常见原因：\n\n- **提供附加说明**：例如，您希望 AI 解释其推理、遵循特定规则或避免某些主题\n- **明确人工智能的作用**：例如，您希望 AI 充当叙述者、讲故事的人或向导\n- **改变对话的上下文**：例如，您希望 AI 像 AI 助手、文本冒险游戏或写作伙伴一样做出响应\n\n> **尝试一下，看看什么最适合你**\n>\n> 本指南中的所有示例都适用于其他用户，但适合您需求的提示词和您使用的型号可能会有所不同。尝试不同的说明和提示方式，看看哪种最适合您。如果您不确定要尝试什么，您可以随时在 [SillyTavern 不和谐](https://discord.gg/sillytavern).\n\n在主提示词中向 AI 提供附加指令可以帮助它理解您想要从对话中获得什么。\n\n> 只写一篇回复。至少写一段，最多四段。\n\n> 降价已启用。用它来格式化你的回复。将代码片段括在三个反引号中。\n\n> 将角色对话写在引号中。把{{char}}的想法写在括号里。\n\n> 您是一位面向 13 至 17 岁用户的动漫角色扮演生成模型。您总是能产生有趣且适合年龄的反应。\n\n> 如实回答并逐步写出您的想法，以确保您得到正确的答案。\n\n人工智能会更容易地遵循关于它应该做什么而不是不应该做什么的指令。例如，如果你希望人工智能避免以某种方式书写，最好告诉它你希望它如何书写。而同时 *“不要决定 {{user}} 说什么或做什么”* 通常包含在提示词中以防止 AI 控制您的用户人设，一些用户发现 *“以尊重 {{user}} 自主权的方式编写 {{char}} 的响应”* 更有效。\n\n通常有比主提示词更好的地方来包含有关用户或角色的信息，修改角色的写作和说话风格，或给出其他具体指令。主要提示词最适合用于有关整个对话或您想要进行的对话类型的一般说明。\n\n### 消息历史记录的影响\n\n当调整主提示词以改善 AI 的响应时，请考虑 AI 从消息历史记录中获取大量信息。历史是对过去事件的记忆，是角色的互动和关系，是对选词和写作风格的风格指南。\n\n通过还提供来利用这一点来发挥您的优势 [示例消息](/guides/sillytavern/core-concepts/characterdesign/#examples-of-dialogue) 显示您希望人工智能如何响应。展示你想要的东西通常比试图解释它更容易！\n\n当你的对话已经有历史记录时，更改主提示词对 AI 响应的影响有限。在事件和关系方面，AI假设主要的提示词发生在遥远的过去，并且消息历史记录更新它。在写作风格和用词方面，人工智能假设历史上的所有消息都是根据文本中的规则生成的。 *当前* main 提示词，并且它应该继续以相同的方式生成消息。处理这个问题的一些建议是：\n\n- 在接近消息历史记录末尾或之后插入当前指令，例如使用 [作者注释](/guides/sillytavern/core-concepts/authors-note/)\n- 通过开始新对话来测试对主提示词的更改\n- 编辑消息历史记录以删除或更正不良行为的示例\n- 使用 [历史后指令](#post-history-instructions) 向AI提供最终指令\n\n> **第一次就做对！**\n>\n> 永远不要让人工智能“逃脱”你不希望它做的事情。如果你不喜欢人工智能的反应，就不要继续对话，就好像它是正确的一样。相反，修改提示词，重新生成消息，然后从那里继续。这将帮助人工智能了解你想要什么。\n\n### 删除“虚构聊天”上下文\n\n在某些情况下，“虚构的聊天”可能不适合您的对话。\n\n您可以从主提示词中删除“虚构”上下文：\n\n> 在与 {{user}} 的对话中写下 {{char}} 的下一条回复。\n\n你可能根本不希望人工智能将自己视为角色扮演。您可以删除 AI 的想法，而不是删除角色的想法：\n\n> 你是{{char}}，一位乐于助人的助手。您提供有用的信息并帮助 {{user}} 解决他们的问题。\n\n### 人工智能作为叙述者或讲故事的人\n\n如果你想让 AI 充当叙述者，从全知的角度描述事件，发明自己的角色和设置，该怎么办？\n\n一种方法是创建一个名为角色的 AI 来用作叙述者。这个角色可以被称为“叙述者”或“AI”，表明AI是一个通用的讲故事者，或者它可以以特定的场景或设置命名，让AI承担在该设置中讲述故事的任务。然后可以在中定义设置的详细信息 [角色](/guides/sillytavern/core-concepts/characterdesign/) 或在 [世界书](/guides/sillytavern/core-concepts/worldinfo/).\n\n您需要调整默认的主提示词以反映 AI 的角色。对于通用叙述者，您可以使用：\n\n> 你是 {{char}}，一位技艺精湛、多才多艺的讲故事者。叙述故事。\n\n或对于特定设置：\n\n> 你是一个奇幻场景的叙述者。扮演访问 {{char}} 的角色。\n\n它有助于澄清用户在对话中的角色。您的消息是故事的一部分，还是向叙述者说明您的角色做了或说了什么？故事中包含用户的示例：\n\n> 故事应该通过响应{{user}}的动作和对话来进展。以第三人称叙述故事。\n\n一个让用户远离故事的例子：\n\n> 进入冒险模式。根据{{user}}的对话和“>”之后的动作来叙述故事。生动详细地描述周围环境。详细、有创意、冗长且积极主动。通过引入奇幻元素和有趣的角色来推动故事的发展。\n\n定义用户的角色不仅可以帮助AI了解如何回复你的消息，还可以帮助它在多大程度上控制你的用户人设。这可以避免人工智能为您的用户人设做出您宁愿自己做的决定的情况。\n\n## 历史后指令\n\n历史后指令 (PHI) 是在主提示词和用户消息之后发送到 AI 的附加指令。它们可用于根据消息历史记录向人工智能提供额外的上下文或指令。\n\n由于历史后指令是在用户消息之后发送的，因此它们是 AI 在生成响应之前收到的最终指令。 AI通常给予它们比主提示词更高的优先级，并且它们可以覆盖主提示词的指令。\n\n要使用每个角色历史记录指令，请将它们添加到角色的 [历史后指令](/guides/sillytavern/core-concepts/characterdesign/) 并启用 [更喜欢查尔。指示](/guides/sillytavern/user-settings/)。要在使用角色特定指令时保留全局定义的 PHI，您可以使用 `{{original}}` 角色的历史记录后指令字段中的宏。\n\n**文本补全 API**\n\n历史后指令定义在 [高级格式设置](/guides/sillytavern/core-concepts/advancedformatting/) 系统提示词类别下的面板。历史后指令作为不可见的用户角色注入添加到提示词最后一行（通常包含响应消息“标头”）之前。请注意，必须启用“启用系统提示词”切换才能应用历史记录指令（即使系统提示词本身为空）。\n\n**聊天补全 API**\n\n历史后指令是默认的提示词之一 [提示词管理器](/guides/sillytavern/prompts/prompt-manager/)。它通常是模型收到的上下文中的最后一条消息，归因于系统角色（“发送者”）。如果您的聊天补全 API 不支持系统角色，通常会归因于用户角色。\n\n## 添加到提示词 (世界书)\n\n您可以使用以下命令在提示词中的任何位置插入附加信息 [世界书](/guides/sillytavern/core-concepts/worldinfo/) 功能。通过设置何时插入信息的条件，您可以引导人工智能包含特定细节、更改其响应方式或向对话添加新元素。\n\n世界书的一些常见用途包括：\n\n- 包含有关世界或环境的信息的“世界书”或“百科全书”\n- 一种针对各种角色和情况管理不同系统提示词的方法\n- 存储人工智能应该在对话中“回忆”的记忆的地方\n- 用于创建、编辑和共享角色详细信息的更加模块化的系统\n- 随机事件和惊喜的来源，供人工智能做出反应，或让你做出反应！\n",
      "searchText": "提示词 当您向 AI 发送消息时，您编写的文本会与其他文本组合在一起，形成发送给 AI 的单个请求。这种组合文本称为“提示词”，有时也称为“请求”或“上下文”。 提示词可以包含各种不同类型的文本，包括： 主要说明 向 AI 询问如何生成响应 的定义 AI应该扮演的角色 的定义 你所扮演的角色 关于“世界”的信息 AI正在与之交互 相关文件或资料来自 资料库 摘要 过去的谈话 结果 网络搜索 或其他 外部数据源 对话中的先前消息 你给人工智能的信息 最终说明 让人工智能了解如何生成响应 这可能需要管理很多事情！为了帮助您了解如何构建和修改发送到 AI 的请求，SillyTavern 标识了您可能想要包含在提示词中的不同元素。然后，您可以构建提示词，以包含对您想要与 AI 交互的方式有意义的内容。 其中许多元素在您将更改它们的部分中进行了解释。例如，要描述您希望人工智能扮演的角色，您可以使用 描述 领域在 角色设计. 查看提示词 阅读发送给 AI 的最终提示词对于理解 AI 被告知的内容以及为什么它会生成这样的响应非常有帮助。您可以通过多种方式查看提示词： 使用 AI 回复消息上的提示词逐项图标 使用 提示词检验员 延伸 检查运行 SillyTavern 的终端窗口中的日志 在浏览器的开发者工具中检查控制台 改变提示词的构建方式 以正确的方式向人工智能展示提示词的所有部分对于获得最佳响应至关重要。您可以控制提示词的构建方式。 文本补全 API 使用 高级格式设置 面板为文本补全 API 定制提示词构造。 聊天补全 API 使用 提示词管理器 为聊天补全 API 定制提示词构造。 主提示词（系统提示词） 主提示词（或系统提示词）定义了模型要遵循的一般指令。它为对话定下了基调和背景。例如，它告诉模型充当 AI 助手、写作伙伴或虚构的角色。 文本补全 API 的 系统提示词 是的一部分 故事串 通常是模型收到的提示词的第一部分。 聊天补全 API 主提示词是默认提示词之一 提示词管理器。它通常是模型收到的上下文中的第一条消息，归因于系统角色（“发送者”）。 默认的主提示词是： 在 {{char}} 和 {{user}} 之间的虚构聊天中写下 {{char}} 的下一条回复。 {{char}} 和 {{user}} 占位符将替换为您在对话中定义的角色和用户人设的名称。 您可以使用任何受支持的 {{macro}} 主提示词中的标签包含在对话之间可能有所不同或随着对话的进行而变化的信息。 调整主提示词 默认的主提示词帮助模型了解预期如何处理后面的角色和用户人设信息、如何解释过去的对话以及生成什么样的响应。它是一个灵活的通用提示词，适用于许多情况，因为它确定 AI 在与用户人设的对话中以角色的形式进行书写。 但是，您可以调整主提示词以更好地满足您的需求。以下是调整主要提示词的一些常见原因： 提供附加说明：例如，您希望 AI 解释其推理、遵循特定规则或避免某些主题 明确人工智能的作用：例如，您希望 AI 充当叙述者、讲故事的人或向导 改变对话的上下文：例如，您希望 AI 像 AI 助手、文本冒险游戏或写作伙伴一样做出响应 尝试一下，看看什么最适合你 本指南中的所有示例都适用于其他用户，但适合您需求的提示词和您使用的型号可能会有所不同。尝试不同的说明和提示方式，看看哪种最适合您。如果您不确定要尝试什么，您可以随时在 SillyTavern 不和谐. 在主提示词中向 AI 提供附加指令可以帮助它理解您想要从对话中获得什么。 只写一篇回复。至少写一段，最多四段。 降价已启用。用它来格式化你的回复。将代码片段括在三个反引号中。 将角色对话写在引号中。把{{char}}的想法写在括号里。 您是一位面向 13 至 17 岁用户的动漫角色扮演生成模型。您总是能产生有趣且适合年龄的反应。 如实回答并逐步写出您的想法，以确保您得到正确的答案。 人工智能会更容易地遵循关于它应该做什么而不是不应该做什么的指令。例如，如果你希望人工智能避免以某种方式书写，最好告诉它你希望它如何书写。而同时 “不要决定 {{user}} 说什么或做什么” 通常包含在提示词中以防止 AI 控制您的用户人设，一些用户发现 “以尊重 {{user}} 自主权的方式编写 {{char}} 的响应” 更有效。 通常有比主提示词更好的地方来包含有关用户或角色的信息，修改角色的写作和说话风格，或给出其他具体指令。主要提示词最适合用于有关整个对话或您想要进行的对话类型的一般说明。 消息历史记录的影响 当调整主提示词以改善 AI 的响应时，请考虑 AI 从消息历史记录中获取大量信息。历史是对过去事件的记忆，是角色的互动和关系，是对选词和写作风格的风格指南。 通过还提供来利用这一点来发挥您的优势 示例消息 显示您希望人工智能如何响应。展示你想要的东西通常比试图解释它更容易！ 当你的对话已经有历史记录时，更改主提示词对 AI 响应的影响有限。在事件和关系方面，AI假设主要的提示词发生在遥远的过去，并且消息历史记录更新它。在写作风格和用词方面，人工智能假设历史上的所有消息都是根据文本中的规则生成的。 当前 main 提示词，并且它应该继续以相同的方式生成消息。处理这个问题的一些建议是： 在接近消息历史记录末尾或之后插入当前指令，例如使用 作者注释 通过开始新对话来测试对主提示词的更改 编辑消息历史记录以删除或更正不良行为的示例 使用 历史后指令 向AI提供最终指令 第一次就做对！ 永远不要让人工智能“逃脱”你不希望它做的事情。如果你不喜欢人工智能的反应，就不要继续对话，就好像它是正确的一样。相反，修改提示词，重新生成消息，然后从那里继续。这将帮助人工智能了解你想要什么。 删除“虚构聊天”上下文 在某些情况下，“虚构的聊天”可能不适合您的对话。 您可以从主提示词中删除“虚构”上下文： 在与 {{user}} 的对话中写下 {{char}} 的下一条回复。 你可能根本不希望人工智能将自己视为角色扮演。您可以删除 AI 的想法，而不是删除角色的想法： 你是{{char}}，一位乐于助人的助手。您提供有用的信息并帮助 {{user}} 解决他们的问题。 人工智能作为叙述者或讲故事的人 如果你想让 AI 充当叙述者，从全知的角度描述事件，发明自己的角色和设置，该怎么办？ 一种方法是创建一个名为角色的 AI 来用作叙述者。这个角色可以被称为“叙述者”或“AI”，表明AI是一个通用的讲故事者，或者它可以以特定的场景或设置命名，让AI承担在该设置中讲述故事的任务。然后可以在中定义设置的详细信息 角色 或在 世界书. 您需要调整默认的主提示词以反映 AI 的角色。对于通用叙述者，您可以使用： 你是 {{char}}，一位技艺精湛、多才多艺的讲故事者。叙述故事。 或对于特定设置： 你是一个奇幻场景的叙述者。扮演访问 {{char}} 的角色。 它有助于澄清用户在对话中的角色。您的消息是故事的一部分，还是向叙述者说明您的角色做了或说了什么？故事中包含用户的示例： 故事应该通过响应{{user}}的动作和对话来进展。以第三人称叙述故事。 一个让用户远离故事的例子： 进入冒险模式。根据{{user}}的对话和“>”之后的动作来叙述故事。生动详细地描述周围环境。详细、有创意、冗长且积极主动。通过引入奇幻元素和有趣的角色来推动故事的发展。 定义用户的角色不仅可以帮助AI了解如何回复你的消息，还可以帮助它在多大程度上控制你的用户人设。这可以避免人工智能为您的用户人设做出您宁愿自己做的决定的情况。 历史后指令 历史后指令 (PHI) 是在主提示词和用户消息之后发送到 AI 的附加指令。它们可用于根据消息历史记录向人工智能提供额外的上下文或指令。 由于历史后指令是在用户消息之后发送的，因此它们是 AI 在生成响应之前收到的最终指令。 AI通常给予它们比主提示词更高的优先级，并且它们可以覆盖主提示词的指令。 要使用每个角色历史记录指令，请将它们添加到角色的 历史后指令 并启用 更喜欢查尔。指示。要在使用角色特定指令时保留全局定义的 PHI，您可以使用 {{original}} 角色的历史记录后指令字段中的宏。 文本补全 API 历史后指令定义在 高级格式设置 系统提示词类别下的面板。历史后指令作为不可见的用户角色注入添加到提示词最后一行（通常包含响应消息“标头”）之前。请注意，必须启用“启用系统提示词”切换才能应用历史记录指令（即使系统提示词本身为空）。 聊天补全 API 历史后指令是默认的提示词之一 提示词管理器。它通常是模型收到的上下文中的最后一条消息，归因于系统角色（“发送者”）。如果您的聊天补全 API 不支持系统角色，通常会归因于用户角色。 添加到提示词 (世界书) 您可以使用以下命令在提示词中的任何位置插入附加信息 世界书 功能。通过设置何时插入信息的条件，您可以引导人工智能包含特定细节、更改其响应方式或向对话添加新元素。 世界书的一些常见用途包括： 包含有关世界或环境的信息的“世界书”或“百科全书” 一种针对各种角色和情况管理不同系统提示词的方法 存储人工智能应该在对话中“回忆”的记忆的地方 用于创建、编辑和共享角色详细信息的更加模块化的系统 随机事件和惊喜的来源，供人工智能做出反应，或让你做出反应！",
      "translationStatus": "machine-draft"
    },
    {
      "slug": "core-concepts/advancedformatting",
      "title": "高级格式设置",
      "group": "Prompts",
      "order": 100,
      "source": "Usage/Prompts/advancedformatting.md",
      "sourceUrl": "https://docs.sillytavern.app/usage/core-concepts/advancedformatting/",
      "sourceSha256": "7b49d6a560c7d2d7526186fcaa0c9716ba6fa40542087a40c879b0922dbb0abd",
      "headings": [
        {
          "id": "advanced-formatting",
          "depth": 1,
          "title": "高级格式设置"
        },
        {
          "id": "resetting-templates",
          "depth": 2,
          "title": "重置模板"
        },
        {
          "id": "ui-reset",
          "depth": 3,
          "title": "用户界面重置"
        },
        {
          "id": "manual-reset",
          "depth": 3,
          "title": "手动复位"
        },
        {
          "id": "backend-defined-templates",
          "depth": 2,
          "title": "后端定义的模板"
        },
        {
          "id": "system-prompt",
          "depth": 2,
          "title": "系统提示词"
        },
        {
          "id": "context-template",
          "depth": 2,
          "title": "上下文模板"
        },
        {
          "id": "tokenizer",
          "depth": 2,
          "title": "分词器"
        },
        {
          "id": "custom-stopping-strings",
          "depth": 2,
          "title": "自定义停止字符串"
        },
        {
          "id": "start-reply-with",
          "depth": 2,
          "title": "开始回复"
        },
        {
          "id": "text-completion-apis",
          "depth": 3,
          "title": "文本补全 API"
        },
        {
          "id": "chat-completion-apis",
          "depth": 3,
          "title": "聊天补全 API"
        }
      ],
      "content": "# 高级格式设置\n\n本节中提供的设置允许对 [提示词-大楼](/guides/sillytavern/prompts/) 策略，主要针对文本补全 API。\n\n此面板中的大多数设置不适用于聊天完成 API，因为它们由提示词管理器系统控制。\n\n**文本补全 API**\n\n- [系统提示词](#system-prompt)\n- [上下文模板](#context-template)\n- [分词器](#tokenizer)\n- [自定义停止字符串](#custom-stopping-strings)\n\n**聊天补全 API**\n\n- 系统提示词：不适用，使用 [提示词管理器](/guides/sillytavern/prompts/prompt-manager/)\n- 上下文模板：不适用，使用 [提示词管理器](/guides/sillytavern/prompts/prompt-manager/)\n- [分词器](#tokenizer)\n- [自定义停止字符串](#custom-stopping-strings)\n\n## 重置模板\n\n您可以将默认模板恢复到原始状态。这可以通过 UI 或手动删除相关数据文件来完成。\n\n### 用户界面重置\n\n1. 打开 **<i class=\"fa-solid fa-font\"></i> 高级格式化** 菜单。\n2. 选择您要重置的模板。\n3. 单击 **<i class=\"fa-solid fa-recycle\"></i> 恢复当前模板** 按钮。\n4. 出现提示时确认操作。\n\n### 手动复位\n\n> 确保 `skipContentCheck` 设置被设置为 `false` 在 [配置.yaml](https://docs.sillytavern.app/administration/config-yaml/#data-configuration)，否则不会触发内容检查。\n\n1. 导航到您的用户数据目录（请参阅 [数据路径](https://docs.sillytavern.app/installation/#data-paths) 了解详情）。\n2. 删除 `content.log` 文件来自用户数据目录的根目录。该文件跟踪为您的用户复制的默认文件。\n3. 从相关子目录中删除模板 JSON 文件（`context`, `instruct`, `sysprompt`等）。\n4. 重新启动SillyTavern服务器。应用程序将重新填充默认内容，恢复任何已删除的默认模板。\n\n## 后端定义的模板\n\n> **适用于：文本补全 API**\n>\n> 不适用于聊天补全 API，因为它们使用不同的提示词构建器。\n\n一些文本补全源提供了自动选择模型作者推荐的模板的功能。这是通过比较模型中定义的聊天模板的哈希来实现的 `tokenizer_config.json` 具有默认 SillyTavern 模板之一的文件。\n\n1. **<i class=\"fa-solid fa-bolt\"></i> 派生模板** 必须在中启用选项 **<i class=\"fa-solid fa-font\"></i> 高级格式化** 菜单。这可以应用于上下文、指令或两者。\n2. 必须选择受支持的后端作为文本补全源。目前只有 llama.cpp 和 KoboldCpp 支持派生模板。\n3. 建立与 API 的连接时，模型必须正确报告其元数据。如果这不起作用，请尝试将后端更新到最新版本。\n4. 报告的聊天模板哈希必须与以下之一匹配 [已知 SillyTavern 模板](https://github.com/SillyTavern/SillyTavern/blob/release/public/scripts/chat-templates.js)。这仅涵盖默认模板，例如 Llama 3、Gemma 2、Mistral V7 等。\n5. 如果哈希匹配，如果模板存在于模板列表中（即未重命名或删除），则将自动选择该模板。\n\n## 系统提示词\n\n> **适用于：文本补全 API**\n>\n> 对于聊天补全 API 中的等效设置，请使用 [提示词管理器](/guides/sillytavern/prompts/prompt-manager/)。的 **主提示词** 相当于聊天补全 API 中的系统提示词。\n\n系统提示词定义了模型要遵循的一般指令。它为对话定下了基调和背景。例如，它告诉模型充当 AI 助手、写作伙伴或虚构的角色。\n\n系统提示词是 [故事串](/guides/sillytavern/prompts/context-template/#story-string) 通常是模型收到的提示词的第一部分。\n\n请参阅 [提示引导](/guides/sillytavern/prompts/#main-prompt-system-prompt) 了解有关系统提示词的更多信息。\n\n## 上下文模板\n\n> **适用于：文本补全 API**\n>\n> 对于聊天补全 API 中的等效设置，请使用 [提示词管理器](/guides/sillytavern/prompts/prompt-manager/).\n\n通常，AI 模型要求您以某种特定方式向它们提供角色数据。 SillyTavern 包含针对不同型号的预制转换规则列表，但您可以根据需要自定义它们。\n\n本节的选项在中进行了解释 [上下文模板](/guides/sillytavern/prompts/context-template/).\n\n## 分词器\n\n分词器是一种将一段文本分解为更小的单元（称为 token）的工具。这些 token 可以是单个单词，甚至可以是单词的一部分，例如前缀、后缀或标点符号。根据经验，1个token一般对应3\\~4个角色文本。\n\n本节的选项在中进行了解释 [分词器](/guides/sillytavern/prompts/tokenizer/).\n\n## 自定义停止字符串\n\n接受 JSON 序列化的停止字符串数组。示例： `[\"\\n\", \"\\nUser:\", \"\\nChar:\"]`。如果您不确定格式，请使用 [在线 JSON 验证器](https://jsonlint.com/)。如果模型输出 **结束** 对于任何停止字符串，它们都将从输出中删除。\n\n支持的API：\n\n1. KoboldAI Classic（版本 1.2.2 及更高版本）或 KoboldCpp\n2. AI Horde\n3. 文本补全 API：文本生成 WebUI (ooba)、Tabby、Aphrodite、Mancer、TogetherAI、Ollama 等。\n4. 小说人工智能\n5. OpenAI（最多 4 个字符串）和兼容的 API\n6. OpenRouter（文本和聊天补全）\n7. 克洛德\n8. 谷歌人工智能工作室\n9. 米斯特拉尔人工智能\n\n## 开始回复\n\n> **注意事项**\n>\n> 默认情况下，“开始回复”前缀不会显示在结果消息中。启用“在聊天中显示回复前缀”以显示它。\n\n### 文本补全 API\n\n预填充提示词的最后一行，强制模型从该点继续。这对于执行内容很有用，例如推动 [模型推理](/guides/sillytavern/prompts/reasoning/) 使用定义的前缀：\n\n```txt\n<think>\nSure!\n```\n\n### 聊天补全 API\n\n在提示词末尾添加助理角色消息。对于某些后端模型，这相当于预填充模型响应，但有些可能根本不支持，并且会因验证错误而失败。如果您不确定，请将此字段留空。\n",
      "searchText": "高级格式设置 本节中提供的设置允许对 提示词-大楼 策略，主要针对文本补全 API。 此面板中的大多数设置不适用于聊天完成 API，因为它们由提示词管理器系统控制。 文本补全 API 系统提示词 上下文模板 分词器 自定义停止字符串 聊天补全 API 系统提示词：不适用，使用 提示词管理器 上下文模板：不适用，使用 提示词管理器 分词器 自定义停止字符串 重置模板 您可以将默认模板恢复到原始状态。这可以通过 UI 或手动删除相关数据文件来完成。 用户界面重置 打开 高级格式化 菜单。 选择您要重置的模板。 单击 恢复当前模板 按钮。 出现提示时确认操作。 手动复位 确保 skipContentCheck 设置被设置为 false 在 配置.yaml，否则不会触发内容检查。 导航到您的用户数据目录（请参阅 数据路径 了解详情）。 删除 content.log 文件来自用户数据目录的根目录。该文件跟踪为您的用户复制的默认文件。 从相关子目录中删除模板 JSON 文件（context, instruct, sysprompt等）。 重新启动SillyTavern服务器。应用程序将重新填充默认内容，恢复任何已删除的默认模板。 后端定义的模板 适用于：文本补全 API 不适用于聊天补全 API，因为它们使用不同的提示词构建器。 一些文本补全源提供了自动选择模型作者推荐的模板的功能。这是通过比较模型中定义的聊天模板的哈希来实现的 tokenizer_config.json 具有默认 SillyTavern 模板之一的文件。 派生模板 必须在中启用选项 高级格式化 菜单。这可以应用于上下文、指令或两者。 必须选择受支持的后端作为文本补全源。目前只有 llama.cpp 和 KoboldCpp 支持派生模板。 建立与 API 的连接时，模型必须正确报告其元数据。如果这不起作用，请尝试将后端更新到最新版本。 报告的聊天模板哈希必须与以下之一匹配 已知 SillyTavern 模板。这仅涵盖默认模板，例如 Llama 3、Gemma 2、Mistral V7 等。 如果哈希匹配，如果模板存在于模板列表中（即未重命名或删除），则将自动选择该模板。 系统提示词 适用于：文本补全 API 对于聊天补全 API 中的等效设置，请使用 提示词管理器。的 主提示词 相当于聊天补全 API 中的系统提示词。 系统提示词定义了模型要遵循的一般指令。它为对话定下了基调和背景。例如，它告诉模型充当 AI 助手、写作伙伴或虚构的角色。 系统提示词是 故事串 通常是模型收到的提示词的第一部分。 请参阅 提示引导 了解有关系统提示词的更多信息。 上下文模板 适用于：文本补全 API 对于聊天补全 API 中的等效设置，请使用 提示词管理器. 通常，AI 模型要求您以某种特定方式向它们提供角色数据。 SillyTavern 包含针对不同型号的预制转换规则列表，但您可以根据需要自定义它们。 本节的选项在中进行了解释 上下文模板. 分词器 分词器是一种将一段文本分解为更小的单元（称为 token）的工具。这些 token 可以是单个单词，甚至可以是单词的一部分，例如前缀、后缀或标点符号。根据经验，1个token一般对应3~4个角色文本。 本节的选项在中进行了解释 分词器. 自定义停止字符串 接受 JSON 序列化的停止字符串数组。示例： [\"\\n\", \"\\nUser:\", \"\\nChar:\"]。如果您不确定格式，请使用 在线 JSON 验证器。如果模型输出 结束 对于任何停止字符串，它们都将从输出中删除。 支持的API： KoboldAI Classic（版本 1.2.2 及更高版本）或 KoboldCpp AI Horde 文本补全 API：文本生成 WebUI (ooba)、Tabby、Aphrodite、Mancer、TogetherAI、Ollama 等。 小说人工智能 OpenAI（最多 4 个字符串）和兼容的 API OpenRouter（文本和聊天补全） 克洛德 谷歌人工智能工作室 米斯特拉尔人工智能 开始回复 注意事项 默认情况下，“开始回复”前缀不会显示在结果消息中。启用“在聊天中显示回复前缀”以显示它。 文本补全 API 预填充提示词的最后一行，强制模型从该点继续。这对于执行内容很有用，例如推动 模型推理 使用定义的前缀： <think> Sure! 聊天补全 API 在提示词末尾添加助理角色消息。对于某些后端模型，这相当于预填充模型响应，但有些可能根本不支持，并且会因验证错误而失败。如果您不确定，请将此字段留空。",
      "translationStatus": "machine-draft"
    },
    {
      "slug": "prompts/context-template",
      "title": "上下文模板",
      "group": "Prompts",
      "order": 90,
      "source": "Usage/Prompts/context-template.md",
      "sourceUrl": "https://docs.sillytavern.app/usage/prompts/context-template/",
      "sourceSha256": "1f730372bb157e38a0948cf1c370434d5a5f6e1e99145872fe2d68be12e5e365",
      "headings": [
        {
          "id": "context-template",
          "depth": 1,
          "title": "上下文模板"
        },
        {
          "id": "story-string",
          "depth": 2,
          "title": "故事串"
        },
        {
          "id": "prompt-anchors",
          "depth": 3,
          "title": "提示词锚"
        },
        {
          "id": "story-string-position",
          "depth": 3,
          "title": "故事字符串位置"
        },
        {
          "id": "story-string-wrapping",
          "depth": 3,
          "title": "故事字符串绕行"
        },
        {
          "id": "example-separator",
          "depth": 2,
          "title": "分隔符示例"
        },
        {
          "id": "chat-start",
          "depth": 2,
          "title": "聊天开始"
        },
        {
          "id": "separators-as-stop-strings",
          "depth": 2,
          "title": "分隔符作为停止字符串"
        },
        {
          "id": "names-as-stop-strings",
          "depth": 2,
          "title": "名称作为停止字符串"
        },
        {
          "id": "always-add-characters-name-to-prompt",
          "depth": 2,
          "title": "始终将角色的名称添加到提示词"
        }
      ],
      "content": "# 上下文模板\n\n> **适用于：文本补全 API**\n>\n> 对于聊天补全 API 中的等效设置，请使用 [提示词管理器](/guides/sillytavern/prompts/prompt-manager/).\n\n通常，AI 模型要求您以某种特定方式向它们提供角色数据。 SillyTavern 包含针对不同型号的预制转换规则列表，但您可以根据需要自定义它们。\n\n在“中编辑这些设置[高级格式设置](/guides/sillytavern/core-concepts/advancedformatting/)“面板。\n\n## 故事串\n\n该字段是提示词前导码（内部称为故事字符串）的模板。这是添加定义信息的主要方式 [角色卡](/guides/sillytavern/characters/) 用于文本完成和指导模型。\n\n该模板支持 Handlebars 语法、自定义文本注入或格式设置以及任何其他 [宏](/guides/sillytavern/core-concepts/macros/)。请参阅此处的语言参考： <https://handlebarsjs.com/guide/>\n\n我们向 Handlebars 求值器提供以下参数（用双花括号括起来）：\n\n1. `{{anchorBefore}}`：提示设置为使用“Before Story String”位置。\n2. `{{anchorAfter}}`：提示设置为使用“After Story String”位置。\n3. `{{description}}`：角色的 [描述](/guides/sillytavern/core-concepts/characterdesign/#character-description).\n4. `{{scenario}}`：角色的 [场景](/guides/sillytavern/core-concepts/characterdesign/#scenario).\n5. `{{personality}}`：角色的 [个性](/guides/sillytavern/core-concepts/characterdesign/#personality-summary).\n6. `{{system}}`: 的 [系统提示词](/guides/sillytavern/core-concepts/advancedformatting/#system-prompt) 或者角色的 [主提示词](/guides/sillytavern/core-concepts/characterdesign/#prompt-overrides) 覆盖（如果存在并且在用户设置中启用了“首选字符提示词”）。\n7. `{{persona}}`：所选的 [用户人设的描述](/guides/sillytavern/core-concepts/personas/#persona-description).\n8. `{{char}}`：角色的名称。\n9. `{{user}}`：选择的用户人设的名称。\n10. `{{wiBefore}}` 或 `{{loreBefore}}`：联合激活 [世界书](/guides/sillytavern/core-concepts/worldinfo/) 位置设置为“Before Char Defs”的条目。\n11. `{{wiAfter}}` 或 `{{loreAfter}}`：联合激活 [世界书](/guides/sillytavern/core-concepts/worldinfo/) 位置设置为“After Char Defs”的条目。\n12. `{{mesExamples}}`：（可选）角色 [对话示例](/guides/sillytavern/core-concepts/characterdesign/#examples-of-dialogue)，带有分隔符的指令格式。\n13. `{{mesExamplesRaw}}`：角色的 [对话示例](/guides/sillytavern/core-concepts/characterdesign/#examples-of-dialogue) 原始格式，没有任何格式。\n\n> ****重要****\n>\n> 使用时 `{{mesExamples}}` 在故事字符串中，设置 **“消息行为示例”** 在 **<i class=\"fa-solid fa-user-cog\"></i> 用户设置** 面板至 **“永远不要包含示例”** 以避免在提示词中重复示例消息。\n\n一个特别的 `{{trim}}` 支持宏来删除它周围的任何换行符。如果您希望文本的一部分不与上一行用换行符分隔，请使用它（*空间 **不是** 修剪过的*).\n\n**警告**：如果故事字符串模板中缺少上述任何参数，则它们根本不会在提示词中发送。\n\n### 提示词锚\n\n的 `{{anchorBefore}}` 和 `{{anchorAfter}}` 是提示词的通用占位符，由选定静态位置的各种扩展和杂项功能添加，例如：\n\n- [作者注释](/guides/sillytavern/core-concepts/authors-note/)\n- [摘要](https://docs.sillytavern.app/extensions/summarize/)\n- [聊天矢量化](https://docs.sillytavern.app/extensions/chat-vectorization/) / [资料库](/guides/sillytavern/core-concepts/data-bank/)\n- [STscript 注入](https://docs.sillytavern.app/usage/st-script/#prompt-injections)\n- [网页搜索](https://docs.sillytavern.app/extensions/websearch/)\n\n### 故事字符串位置\n\n默认情况下，渲染的故事字符串（所有占位符均已替换）放置在提示词的最开头，后面是示例消息和可见的聊天历史记录。\n\n或者，您可以通过选择“聊天中@深度”选项将其移动到动态位置，该选项将故事字符串放置在聊天上下文中的特定深度。\n\n> ****注意****\n>\n> 如果模板包含用于包装故事字符串的静态提示词元素（特定于模型的前缀或后缀），则使用“In-Chat @ Depth”位置将导致其与重复序列错误地双重包装，这可能会导致意外结果。\n>\n> 在这种情况下，您可以通过以下方式之一解决该问题：\n>\n> 1. **内置模板**：使用中描述的步骤将模板重置为其默认值 [高级格式设置](/guides/sillytavern/core-concepts/advancedformatting/#resetting-templates).\n> 2. **自定义模板**：将静态元素从故事字符串模板移至 [故事字符串序列](/guides/sillytavern/core-concepts/instructmode/#sequences-story-string-wrapping).\n\n### 故事字符串绕行\n\n> 以下部分仅适用于 **指令模式** 已开启。\n\n- **默认** 位置：渲染的故事字符串将使用中定义的序列进行包装 [故事字符串序列](/guides/sillytavern/core-concepts/instructmode/#sequences-story-string-wrapping).\n- **聊天中@深度** 位置：渲染的故事字符串将使用中定义的序列进行包装 [聊天消息序列](/guides/sillytavern/core-concepts/instructmode/#sequences-chat-messages-wrapping) 对于所选角色（默认：系统）。\n\n## 分隔符示例\n\n用作块头和示例对话块之间的分隔符。任何实例 `<START>` 示例对话中的标签将替换为此字段的内容。\n\n## 聊天开始\n\n作为分隔符插入在渲染的故事字符串之后和示例对话块之后，但在上下文中的第一条消息之前。\n\n## 分隔符作为停止字符串\n\n将“示例分隔符”和“聊天开始”添加到停止字符串列表。\n\n如果模型倾向于产生幻觉或泄漏分隔符前面的整个示例对话块，则很有帮助。\n\n## 名称作为停止字符串\n\n将角色和用户用户人设名称添加到停止字符串列表中。\n\n建议保持打开状态以防止模型冒充。\n\n## 始终将角色的名称添加到提示词\n\n> 当指令模式打开时，此设置无效。名称行为而是由所选的定义 [包括姓名](/guides/sillytavern/core-concepts/instructmode/#include-names) 选项。\n\n将角色的名称附加到提示词以强制模型将消息完成为角色：\n\n```txt\n** OTHER CONTEXT HERE **\nCharacter:\n```\n",
      "searchText": "上下文模板 适用于：文本补全 API 对于聊天补全 API 中的等效设置，请使用 提示词管理器. 通常，AI 模型要求您以某种特定方式向它们提供角色数据。 SillyTavern 包含针对不同型号的预制转换规则列表，但您可以根据需要自定义它们。 在“中编辑这些设置高级格式设置“面板。 故事串 该字段是提示词前导码（内部称为故事字符串）的模板。这是添加定义信息的主要方式 角色卡 用于文本完成和指导模型。 该模板支持 Handlebars 语法、自定义文本注入或格式设置以及任何其他 宏。请参阅此处的语言参考： https://handlebarsjs.com/guide/ 我们向 Handlebars 求值器提供以下参数（用双花括号括起来）： {{anchorBefore}}：提示设置为使用“Before Story String”位置。 {{anchorAfter}}：提示设置为使用“After Story String”位置。 {{description}}：角色的 描述. {{scenario}}：角色的 场景. {{personality}}：角色的 个性. {{system}}: 的 系统提示词 或者角色的 主提示词 覆盖（如果存在并且在用户设置中启用了“首选字符提示词”）。 {{persona}}：所选的 用户人设的描述. {{char}}：角色的名称。 {{user}}：选择的用户人设的名称。 {{wiBefore}} 或 {{loreBefore}}：联合激活 世界书 位置设置为“Before Char Defs”的条目。 {{wiAfter}} 或 {{loreAfter}}：联合激活 世界书 位置设置为“After Char Defs”的条目。 {{mesExamples}}：（可选）角色 对话示例，带有分隔符的指令格式。 {{mesExamplesRaw}}：角色的 对话示例 原始格式，没有任何格式。 重要 使用时 {{mesExamples}} 在故事字符串中，设置 “消息行为示例” 在 用户设置 面板至 “永远不要包含示例” 以避免在提示词中重复示例消息。 一个特别的 {{trim}} 支持宏来删除它周围的任何换行符。如果您希望文本的一部分不与上一行用换行符分隔，请使用它（空间 不是 修剪过的). 警告：如果故事字符串模板中缺少上述任何参数，则它们根本不会在提示词中发送。 提示词锚 的 {{anchorBefore}} 和 {{anchorAfter}} 是提示词的通用占位符，由选定静态位置的各种扩展和杂项功能添加，例如： 作者注释 摘要 聊天矢量化 / 资料库 STscript 注入 网页搜索 故事字符串位置 默认情况下，渲染的故事字符串（所有占位符均已替换）放置在提示词的最开头，后面是示例消息和可见的聊天历史记录。 或者，您可以通过选择“聊天中@深度”选项将其移动到动态位置，该选项将故事字符串放置在聊天上下文中的特定深度。 注意 如果模板包含用于包装故事字符串的静态提示词元素（特定于模型的前缀或后缀），则使用“In-Chat @ Depth”位置将导致其与重复序列错误地双重包装，这可能会导致意外结果。 在这种情况下，您可以通过以下方式之一解决该问题： 内置模板：使用中描述的步骤将模板重置为其默认值 高级格式设置. 自定义模板：将静态元素从故事字符串模板移至 故事字符串序列. 故事字符串绕行 以下部分仅适用于 指令模式 已开启。 默认 位置：渲染的故事字符串将使用中定义的序列进行包装 故事字符串序列. 聊天中@深度 位置：渲染的故事字符串将使用中定义的序列进行包装 聊天消息序列 对于所选角色（默认：系统）。 分隔符示例 用作块头和示例对话块之间的分隔符。任何实例 <START> 示例对话中的标签将替换为此字段的内容。 聊天开始 作为分隔符插入在渲染的故事字符串之后和示例对话块之后，但在上下文中的第一条消息之前。 分隔符作为停止字符串 将“示例分隔符”和“聊天开始”添加到停止字符串列表。 如果模型倾向于产生幻觉或泄漏分隔符前面的整个示例对话块，则很有帮助。 名称作为停止字符串 将角色和用户用户人设名称添加到停止字符串列表中。 建议保持打开状态以防止模型冒充。 始终将角色的名称添加到提示词 当指令模式打开时，此设置无效。名称行为而是由所选的定义 包括姓名 选项。 将角色的名称附加到提示词以强制模型将消息完成为角色： ** OTHER CONTEXT HERE ** Character:",
      "translationStatus": "machine-draft"
    },
    {
      "slug": "core-concepts/instructmode",
      "title": "指令模式",
      "group": "Prompts",
      "order": 80,
      "source": "Usage/Prompts/instructmode.md",
      "sourceUrl": "https://docs.sillytavern.app/usage/core-concepts/instructmode/",
      "sourceSha256": "d82b30daa16d701598668e33d56ec26327cc11ee0a75c7da00409de409fb9e78",
      "headings": [
        {
          "id": "instruct-mode",
          "depth": 1,
          "title": "指令模式"
        },
        {
          "id": "api-support",
          "depth": 2,
          "title": "API支持"
        },
        {
          "id": "text-completion-api",
          "depth": 3,
          "title": "文本补全 API"
        },
        {
          "id": "choosing-a-formatting",
          "depth": 4,
          "title": "选择格式"
        },
        {
          "id": "chat-completion-api-openai-claude-etc",
          "depth": 3,
          "title": "聊天补全 API（OpenAI、Claude 等）"
        },
        {
          "id": "novelai",
          "depth": 3,
          "title": "小说人工智能"
        },
        {
          "id": "instruct-mode-settings",
          "depth": 2,
          "title": "指令模式设置"
        },
        {
          "id": "system-prompt",
          "depth": 3,
          "title": "系统提示词"
        },
        {
          "id": "templates",
          "depth": 3,
          "title": "模板"
        },
        {
          "id": "activation-regex",
          "depth": 3,
          "title": "激活正则表达式"
        },
        {
          "id": "wrap-sequences-with-newline",
          "depth": 3,
          "title": "用换行符换行序列"
        },
        {
          "id": "replace-macro-in-sequences",
          "depth": 3,
          "title": "替换序列中的宏"
        },
        {
          "id": "include-names",
          "depth": 3,
          "title": "包括姓名"
        },
        {
          "id": "sequences-story-string-wrapping",
          "depth": 3,
          "title": "序列：故事字符串包装"
        },
        {
          "id": "story-string-prefix",
          "depth": 4,
          "title": "故事字符串前缀"
        },
        {
          "id": "story-string-suffix",
          "depth": 4,
          "title": "故事字符串后缀"
        },
        {
          "id": "sequences-chat-messages-wrapping",
          "depth": 3,
          "title": "序列：聊天消息包装"
        },
        {
          "id": "user-message-prefix",
          "depth": 4,
          "title": "用户消息前缀"
        },
        {
          "id": "user-message-suffix",
          "depth": 4,
          "title": "用户消息后缀"
        },
        {
          "id": "assistant-message-prefix",
          "depth": 4,
          "title": "助理消息前缀"
        },
        {
          "id": "assistant-message-suffix",
          "depth": 4,
          "title": "助理消息后缀"
        },
        {
          "id": "system-message-prefix",
          "depth": 4,
          "title": "系统消息前缀"
        },
        {
          "id": "system-message-suffix",
          "depth": 4,
          "title": "系统消息后缀"
        },
        {
          "id": "system-same-as-user",
          "depth": 4,
          "title": "系统与用户相同"
        },
        {
          "id": "misc-sequences",
          "depth": 3,
          "title": "杂项。序列"
        },
        {
          "id": "first-assistant-prefix",
          "depth": 4,
          "title": "第一助理前缀"
        },
        {
          "id": "last-assistant-prefix",
          "depth": 4,
          "title": "最后的助手前缀"
        },
        {
          "id": "system-instruction-prefix",
          "depth": 4,
          "title": "系统指令前缀"
        },
        {
          "id": "user-filler-message",
          "depth": 4,
          "title": "用户填写信息"
        },
        {
          "id": "stop-sequence",
          "depth": 4,
          "title": "停止顺序"
        }
      ],
      "content": "# 指令模式\n\n指令模式允许您调整在各种提示词格式（例如 Alpaca、ChatML、Llama2 等）上训练的指令跟踪模型的提示。\n\n> **适用于：文本补全 API**\n>\n> 对于聊天补全 API 中的等效设置，请使用 [提示词管理器](/guides/sillytavern/prompts/prompt-manager/).\n\n## API支持\n\n### 文本补全 API\n\n完全支持。这包括：\n\n- 文本补全下的所有来源\n- KoboldAI 经典版\n- AI Horde\n\n#### 选择格式\n\n所选的指令模板必须符合后端运行的实际模型的期望。\n\n这通常反映在 HuggingFace 上的模型卡中，有些甚至提供 SillyTavern 兼容的 JSON 文件。\n\n示例： [NeverSleep/Noromaid-13b-v0.1.1](https://huggingface.co/NeverSleep/Noromaid-13b-v0.1.1#prompt-template-custom-format-or-alpaca)\n\n### 聊天补全 API（OpenAI、Claude 等）\n\n不支持此功能 **（并且不需要）** 对于聊天补全 API。他们使用完全不同的提示词构建器。\n\n### 小说人工智能\n\n同时 *技术上* 支持 NovelAI，但他们的模型都没有经过训练来理解指令格式。 NovelAI 模型可以使用激活的特殊指令模块 *自动地* 当聊天消息中遇到大括号括起来的指令时，因此对整个提示词使用指令模式将导致 **质量下降** 的输出。\n\n下面是自动激活 NovelAI 指令模块的示例：\n\n```txt\nUser: { Write a happy song about Nintendo Switch. }\n```\n\n## 指令模式设置\n\n### 系统提示词\n\n> **最近的变化**\n>\n> 系统提示词现在是一个独立的实体。请参阅 [高级格式设置](/guides/sillytavern/core-concepts/advancedformatting/#system-prompt) 页面了解更多详情。\n\n### 模板\n\n为一些知名的指令模型提供带有序列的现成模板。\n\n*更改模板会将未保存的设置重置为上次保存的状态！如果您进行了任何不想丢失的更改，请不要忘记保存模板。*\n\n### 激活正则表达式\n\n如果定义为有效的正则表达式，当连接到模型并且其名称与此正则表达式匹配时，将自动选择此模板。\n\n需要事先启用指令模式。仅选择跨模板的第一个正则表达式匹配（按字母顺序评估）。\n\n### 用换行符换行序列\n\n每个序列文本在插入提示词时都会用换行符角色换行。羊驼及其衍生品所必需的。\n\n如果您想完全控制行终止符，请禁用。\n\n### 替换序列中的宏\n\n如果启用，则已知的 {{macro}} 替换（如果在消息包装序列中定义）将被替换。\n\n此外，可以在消息前缀中使用特殊的 {{name}} 宏来引用附加到消息的实际名称（而不是当前活动的 {{char}} 或 {{user}}），这在使用群聊或 /sendas 命令时非常有用。如果无法确定名称，则使用“System”作为后备占位符。\n\n### 包括姓名\n\n如果启用，则在前缀序列之后将角色和用户名添加到聊天历史记录日志中。\n\n可以使用以下选项：\n\n- **从来没有**：不要在消息内容前添加名称前缀。\n- **团体和过去用户人设**：仅向来自角色组和过去用户人设的消息添加名称前缀。\n- **总是**：始终在消息内容之前添加名称前缀。\n\n### 序列：故事字符串包装\n\n> **最近的变化**\n>\n> 系统提示词环绕已被删除并替换为故事字符串环绕。\n\n定义当位置设置为“默认（上下文顶部）”时如何包装故事字符串\n\n#### 故事字符串前缀\n\n插入故事字符串之前。\n\n#### 故事字符串后缀\n\n插入到故事字符串之后。\n\n### 序列：聊天消息包装\n\n这些设置定义了在构建提示词时如何包装属于不同角色的消息。\n\n所有前缀序列也将自动用作停止字符串。\n\n#### 用户消息前缀\n\n在模拟时插入用户消息之前并作为最后提示词行。\n\n#### 用户消息后缀\n\n插入在用户消息之后。\n\n#### 助理消息前缀\n\n在生成 AI 回复时插入助理消息之前并作为最后提示词行。\n\n#### 助理消息后缀\n\n在助理消息后插入\n\n#### 系统消息前缀\n\n插入系统消息（通过斜杠命令或扩展添加）之前。\n\n#### 系统消息后缀\n\n插入系统消息之后。\n\n#### 系统与用户相同\n\n如果选中 true，系统消息将使用用户角色消息序列。\n\n否则，系统消息使用自己的序列（如果不为空）或根本不会进行任何包装（如果为空）。\n\n### 杂项。序列\n\n用于对提示词建筑进行微调的各种高级配置\n\n#### 第一助理前缀\n\n插入到第一条助理消息之前。\n\n> 仅第一条消息 **聊天记录** 重要的是，不是首先实际进入提示词的消息！\n\n#### 最后的助手前缀\n\n在生成 AI 回复时插入到最后一条助手消息之前或作为最后提示词行。\n\n> 在背景中生成文本时不使用（例如稳定扩散提示词或摘要）。将使用系统指令前缀或常规助手前缀。\n\n#### 系统指令前缀\n\n在背景中生成中性/系统文本时作为最后提示词行插入（例如稳定扩散提示词或摘要）。\n\n#### 用户填写信息\n\n如果聊天记录不以用户消息开头，则将插入到聊天记录的开头。\n\n**使用案例：** 当指令格式 *严格要求* 提示词用户至上，并且仅具有交替角色的消息，例如：Llama 2 Chat、Mistral Instruct。\n\n#### 停止顺序\n\n表示回复结束的文本。还作为停止字符串发送到后端 API。\n\n如果生成停止序列，则超过该序列的所有内容都将从输出中删除（包括序列本身）。\n",
      "searchText": "指令模式 指令模式允许您调整在各种提示词格式（例如 Alpaca、ChatML、Llama2 等）上训练的指令跟踪模型的提示。 适用于：文本补全 API 对于聊天补全 API 中的等效设置，请使用 提示词管理器. API支持 文本补全 API 完全支持。这包括： 文本补全下的所有来源 KoboldAI 经典版 AI Horde 选择格式 所选的指令模板必须符合后端运行的实际模型的期望。 这通常反映在 HuggingFace 上的模型卡中，有些甚至提供 SillyTavern 兼容的 JSON 文件。 示例： NeverSleep/Noromaid-13b-v0.1.1 聊天补全 API（OpenAI、Claude 等） 不支持此功能 （并且不需要） 对于聊天补全 API。他们使用完全不同的提示词构建器。 小说人工智能 同时 技术上 支持 NovelAI，但他们的模型都没有经过训练来理解指令格式。 NovelAI 模型可以使用激活的特殊指令模块 自动地 当聊天消息中遇到大括号括起来的指令时，因此对整个提示词使用指令模式将导致 质量下降 的输出。 下面是自动激活 NovelAI 指令模块的示例： User: { Write a happy song about Nintendo Switch. } 指令模式设置 系统提示词 最近的变化 系统提示词现在是一个独立的实体。请参阅 高级格式设置 页面了解更多详情。 模板 为一些知名的指令模型提供带有序列的现成模板。 更改模板会将未保存的设置重置为上次保存的状态！如果您进行了任何不想丢失的更改，请不要忘记保存模板。 激活正则表达式 如果定义为有效的正则表达式，当连接到模型并且其名称与此正则表达式匹配时，将自动选择此模板。 需要事先启用指令模式。仅选择跨模板的第一个正则表达式匹配（按字母顺序评估）。 用换行符换行序列 每个序列文本在插入提示词时都会用换行符角色换行。羊驼及其衍生品所必需的。 如果您想完全控制行终止符，请禁用。 替换序列中的宏 如果启用，则已知的 {{macro}} 替换（如果在消息包装序列中定义）将被替换。 此外，可以在消息前缀中使用特殊的 {{name}} 宏来引用附加到消息的实际名称（而不是当前活动的 {{char}} 或 {{user}}），这在使用群聊或 /sendas 命令时非常有用。如果无法确定名称，则使用“System”作为后备占位符。 包括姓名 如果启用，则在前缀序列之后将角色和用户名添加到聊天历史记录日志中。 可以使用以下选项： 从来没有：不要在消息内容前添加名称前缀。 团体和过去用户人设：仅向来自角色组和过去用户人设的消息添加名称前缀。 总是：始终在消息内容之前添加名称前缀。 序列：故事字符串包装 最近的变化 系统提示词环绕已被删除并替换为故事字符串环绕。 定义当位置设置为“默认（上下文顶部）”时如何包装故事字符串 故事字符串前缀 插入故事字符串之前。 故事字符串后缀 插入到故事字符串之后。 序列：聊天消息包装 这些设置定义了在构建提示词时如何包装属于不同角色的消息。 所有前缀序列也将自动用作停止字符串。 用户消息前缀 在模拟时插入用户消息之前并作为最后提示词行。 用户消息后缀 插入在用户消息之后。 助理消息前缀 在生成 AI 回复时插入助理消息之前并作为最后提示词行。 助理消息后缀 在助理消息后插入 系统消息前缀 插入系统消息（通过斜杠命令或扩展添加）之前。 系统消息后缀 插入系统消息之后。 系统与用户相同 如果选中 true，系统消息将使用用户角色消息序列。 否则，系统消息使用自己的序列（如果不为空）或根本不会进行任何包装（如果为空）。 杂项。序列 用于对提示词建筑进行微调的各种高级配置 第一助理前缀 插入到第一条助理消息之前。 仅第一条消息 聊天记录 重要的是，不是首先实际进入提示词的消息！ 最后的助手前缀 在生成 AI 回复时插入到最后一条助手消息之前或作为最后提示词行。 在背景中生成文本时不使用（例如稳定扩散提示词或摘要）。将使用系统指令前缀或常规助手前缀。 系统指令前缀 在背景中生成中性/系统文本时作为最后提示词行插入（例如稳定扩散提示词或摘要）。 用户填写信息 如果聊天记录不以用户消息开头，则将插入到聊天记录的开头。 使用案例： 当指令格式 严格要求 提示词用户至上，并且仅具有交替角色的消息，例如：Llama 2 Chat、Mistral Instruct。 停止顺序 表示回复结束的文本。还作为停止字符串发送到后端 API。 如果生成停止序列，则超过该序列的所有内容都将从输出中删除（包括序列本身）。",
      "translationStatus": "machine-draft"
    },
    {
      "slug": "prompts/tokenizer",
      "title": "分词器",
      "group": "Prompts",
      "order": 70,
      "source": "Usage/Prompts/tokenizer.md",
      "sourceUrl": "https://docs.sillytavern.app/usage/prompts/tokenizer/",
      "sourceSha256": "c31c7ee907a57e5e215b78f80681bf2e343aab6cc100e52f7ecc23301975aa29",
      "headings": [
        {
          "id": "tokenizer",
          "depth": 1,
          "title": "分词器"
        },
        {
          "id": "additional-tokenizers",
          "depth": 4,
          "title": "额外的分词器"
        },
        {
          "id": "token-padding",
          "depth": 3,
          "title": "令牌填充"
        }
      ],
      "content": "# 分词器\n\n分词器是一种将一段文本分解为更小的单元（称为 token）的工具。这些 token 可以是单个单词，甚至可以是单词的一部分，例如前缀、后缀或标点符号。根据经验，1个token一般对应3\\~4个角色文本。\n\nSillyTavern 提供“最佳匹配”选项，尝试根据所使用的 API 提供程序使用以下规则来匹配标记生成器。\n\n文本补全 API **（可重写）**:\n\n1. NovelAI Clio：NerdStash 分词器。\n2. NovelAI Kayra：NerdStash v2 分词器。\n3. 文本补全：API 分词器（如果支持）或 Llama 分词器。\n4. KoboldAI Classic / AI Horde：Llama 标记器。\n5. KoboldCpp：模型 API 标记器。\n\n如果您得到的结果不准确或希望进行实验，您可以设置一个 *覆盖分词器* 供 SillyTavern 在向 AI 后端形成请求时使用：\n\n1. 没有。每个 token 估计约为 3.3 角色，四舍五入到最接近的整数。 **如果您的提示词在高上下文长度上被切断，请尝试此操作。** KoboldAI Lite 使用了这种方法。\n2. Llama 标记器。 Llama 1/2型号系列使用：Vicuna、Hermes、Airoboros等。 **如果您使用 Llama 1/2 模型，请选择。**\n3. Llama 3 分词器。由 Llama 3/3.1 型号使用。 **如果您使用 Llama 3/3.1 型号，请选择此选项。**\n4. NerdStash 标记器。由NovelAI 的Clio 模型使用。 **如果您使用 Clio 模型，请选择。**\n5. NerdStash v2 分词器。由NovelAI 的Kayra 模型使用。 **如果您使用 Kayra 模型，请选择。**\n6. Mistral V1 分词器。由较旧的 Mistral 模型系列及其微调使用。 **如果您使用较旧的 Mistral 型号，请选择此选项。**\n7. 米斯特拉尔尼莫分词器。由 Mistral Nemo 模型系列及其微调使用。 **如果您使用 Mistral Nemo/Pixtral 模型，请选择此选项。**\n8. 易分词器。彝族模型使用。 **如果您使用 Yi 模型，请选择。**\n9. Gemma 分词器。由 Gemini/Gemma 型号使用。 **如果您使用 Gemma 模型，请选择。**\n10. DeepSeek 分词器。由 DeepSeek 模型（例如 R1）使用。 **如果您使用 DeepSeek 模型，请选择。**\n11. API 标记器。查询生成 API 以直接从模型获取 token 计数。支持的已知后端：文本生成 WebUI (ooba)、koboldcpp、TabbyAPI、Aphrodite API。 **选择是否使用受支持的后端。**\n\n聊天补全 API **（不可覆盖）**:\n\n1. OpenAI：依赖于模型的分词器 [抖音](https://github.com/openai/tiktoken).\n2. Claude：依赖于模型的分词器 [WebTokenizers](https://github.com/mlc-ai/tokenizers-cpp).\n3. OpenRouter：Llama、Mistral、Gemma、Yi 各自模型的标记器。\n4. Google AI Studio：Gemma 分词器。\n5. AI21 API：Jamba 标记器（需要一次性下载）。\n6. Cohere API：Command-R 或 Command-A 分词器（需要一次性下载）。\n7. MistralAI API：Mistral V1 或 V3 分词器（需要一次性下载）。\n8. DeepSeek API：DeepSeek 分词器（需要一次性下载）。\n9. 后备分词器：GPT-3.5 Turbo 分词器。\n\n#### 额外的分词器\n\n由于它们的大小，这些标记器不包含在默认安装中。第一次使用时需要一次性下载。\n\n1. Qwen2 分词器。\n2. Command-R / Command-A 分词器。由聊天补全中的 Cohere 源使用。\n3. Mistral V3 (Nemo) 分词器。由 MistralAI 源在聊天补全（Nemo 和 Pixtral 模型）中使用。\n4. DeepSeek（deepseek-chat）分词器。由聊天补全中的 DeepSeek 源使用。\n\n如果您不想使用互联网下载，则 config.yaml 中存在选择退出选项： `enableDownloadableTokenizers`。设置为 `false` 禁用下载。\n\n您还可以从以下位置手动下载分词器： [SillyTavern-分词器](https://github.com/SillyTavern/SillyTavern-Tokenizers) 存储库。下载 JSON 文件并将其放入 `_cache` 数据根的子目录，路径是 `./data/_cache` 默认情况下。创建 `_cache` 目录（如果不存在）。之后，重新启动 SillyTavern 服务器以重新初始化标记器。\n\n如果所需的分词器模型未缓存且下载被禁用，则将使用后备分词器 (Llama 3) 进行计数。\n\n### 令牌填充\n\n> **适用于：文本补全 API**\n>\n> SillyTavern 将始终使用聊天补全模型的匹配标记器，因此不需要 token 填充。\n\n除非 SillyTavern 使用运行模型的远程后端 API 提供的分词器，否则在提示词生成过程中假定的所有 token 计数都是根据所选的值进行估计的 [分词器](#tokenizer) 类型。\n\n由于在接近模型定义的最大值的上下文大小上标记化的结果可能不准确，因此提示词的某些部分可能会被修剪或删除，这可能会对角色定义的一致性产生负面影响。\n\n为了防止这种情况，SillyTavern 分配上下文大小的一部分作为填充，以避免添加超出模型可容纳的聊天项目。如果您发现即使选择了最匹配的分词器，提示词的某些部分也会被修剪，请调整填充以使描述不会被截断。\n\n您可以输入负值进行反向填充，这允许分配超过设置的最大数量的 token。\n",
      "searchText": "分词器 分词器是一种将一段文本分解为更小的单元（称为 token）的工具。这些 token 可以是单个单词，甚至可以是单词的一部分，例如前缀、后缀或标点符号。根据经验，1个token一般对应3~4个角色文本。 SillyTavern 提供“最佳匹配”选项，尝试根据所使用的 API 提供程序使用以下规则来匹配标记生成器。 文本补全 API （可重写）: NovelAI Clio：NerdStash 分词器。 NovelAI Kayra：NerdStash v2 分词器。 文本补全：API 分词器（如果支持）或 Llama 分词器。 KoboldAI Classic / AI Horde：Llama 标记器。 KoboldCpp：模型 API 标记器。 如果您得到的结果不准确或希望进行实验，您可以设置一个 覆盖分词器 供 SillyTavern 在向 AI 后端形成请求时使用： 没有。每个 token 估计约为 3.3 角色，四舍五入到最接近的整数。 如果您的提示词在高上下文长度上被切断，请尝试此操作。 KoboldAI Lite 使用了这种方法。 Llama 标记器。 Llama 1/2型号系列使用：Vicuna、Hermes、Airoboros等。 如果您使用 Llama 1/2 模型，请选择。 Llama 3 分词器。由 Llama 3/3.1 型号使用。 如果您使用 Llama 3/3.1 型号，请选择此选项。 NerdStash 标记器。由NovelAI 的Clio 模型使用。 如果您使用 Clio 模型，请选择。 NerdStash v2 分词器。由NovelAI 的Kayra 模型使用。 如果您使用 Kayra 模型，请选择。 Mistral V1 分词器。由较旧的 Mistral 模型系列及其微调使用。 如果您使用较旧的 Mistral 型号，请选择此选项。 米斯特拉尔尼莫分词器。由 Mistral Nemo 模型系列及其微调使用。 如果您使用 Mistral Nemo/Pixtral 模型，请选择此选项。 易分词器。彝族模型使用。 如果您使用 Yi 模型，请选择。 Gemma 分词器。由 Gemini/Gemma 型号使用。 如果您使用 Gemma 模型，请选择。 DeepSeek 分词器。由 DeepSeek 模型（例如 R1）使用。 如果您使用 DeepSeek 模型，请选择。 API 标记器。查询生成 API 以直接从模型获取 token 计数。支持的已知后端：文本生成 WebUI (ooba)、koboldcpp、TabbyAPI、Aphrodite API。 选择是否使用受支持的后端。 聊天补全 API （不可覆盖）: OpenAI：依赖于模型的分词器 抖音. Claude：依赖于模型的分词器 WebTokenizers. OpenRouter：Llama、Mistral、Gemma、Yi 各自模型的标记器。 Google AI Studio：Gemma 分词器。 AI21 API：Jamba 标记器（需要一次性下载）。 Cohere API：Command-R 或 Command-A 分词器（需要一次性下载）。 MistralAI API：Mistral V1 或 V3 分词器（需要一次性下载）。 DeepSeek API：DeepSeek 分词器（需要一次性下载）。 后备分词器：GPT-3.5 Turbo 分词器。 额外的分词器 由于它们的大小，这些标记器不包含在默认安装中。第一次使用时需要一次性下载。 Qwen2 分词器。 Command-R / Command-A 分词器。由聊天补全中的 Cohere 源使用。 Mistral V3 (Nemo) 分词器。由 MistralAI 源在聊天补全（Nemo 和 Pixtral 模型）中使用。 DeepSeek（deepseek-chat）分词器。由聊天补全中的 DeepSeek 源使用。 如果您不想使用互联网下载，则 config.yaml 中存在选择退出选项： enableDownloadableTokenizers。设置为 false 禁用下载。 您还可以从以下位置手动下载分词器： SillyTavern-分词器 存储库。下载 JSON 文件并将其放入 _cache 数据根的子目录，路径是 ./data/_cache 默认情况下。创建 _cache 目录（如果不存在）。之后，重新启动 SillyTavern 服务器以重新初始化标记器。 如果所需的分词器模型未缓存且下载被禁用，则将使用后备分词器 (Llama 3) 进行计数。 令牌填充 适用于：文本补全 API SillyTavern 将始终使用聊天补全模型的匹配标记器，因此不需要 token 填充。 除非 SillyTavern 使用运行模型的远程后端 API 提供的分词器，否则在提示词生成过程中假定的所有 token 计数都是根据所选的值进行估计的 分词器 类型。 由于在接近模型定义的最大值的上下文大小上标记化的结果可能不准确，因此提示词的某些部分可能会被修剪或删除，这可能会对角色定义的一致性产生负面影响。 为了防止这种情况，SillyTavern 分配上下文大小的一部分作为填充，以避免添加超出模型可容纳的聊天项目。如果您发现即使选择了最匹配的分词器，提示词的某些部分也会被修剪，请调整填充以使描述不会被截断。 您可以输入负值进行反向填充，这允许分配超过设置的最大数量的 token。",
      "translationStatus": "machine-draft"
    },
    {
      "slug": "prompts/cfg",
      "title": "CFG 引导",
      "group": "Prompts",
      "order": 60,
      "source": "Usage/Prompts/CFG.md",
      "sourceUrl": "https://docs.sillytavern.app/usage/prompts/cfg/",
      "sourceSha256": "1d6f7a8d7911af7f5d11409d3bb11952dafb3ef0e8dbd014ee5147cac6543d3b",
      "headings": [
        {
          "id": "cfg",
          "depth": 1,
          "title": "CFG 引导"
        },
        {
          "id": "what-is-it",
          "depth": 2,
          "title": "它是什么？"
        },
        {
          "id": "supported-backend-apis",
          "depth": 3,
          "title": "支持的后端 API"
        },
        {
          "id": "configuration",
          "depth": 2,
          "title": "配置"
        },
        {
          "id": "group-chats",
          "depth": 4,
          "title": "群聊"
        },
        {
          "id": "concepts",
          "depth": 2,
          "title": "概念"
        },
        {
          "id": "isnt-this-in-stable-diffusion",
          "depth": 3,
          "title": "这不是稳定扩散吗？"
        },
        {
          "id": "do-i-need-cfg-prompts",
          "depth": 3,
          "title": "我需要CFG 提示词吗？"
        },
        {
          "id": "what-makes-a-good-cfg-prompt",
          "depth": 3,
          "title": "CFG 提示词的品质如何？"
        },
        {
          "id": "positive-prompts",
          "depth": 3,
          "title": "积极提示"
        },
        {
          "id": "but",
          "depth": 3,
          "title": "但是..."
        },
        {
          "id": "guidance-scale",
          "depth": 3,
          "title": "指导量表"
        },
        {
          "id": "prompt-cascading",
          "depth": 3,
          "title": "提示词级联"
        },
        {
          "id": "insertion-depth",
          "depth": 3,
          "title": "插入深度"
        }
      ],
      "content": "# CFG 引导\n\n页面编写者：kingbri\n\n贡献者：kingbri、Guillaume \"Vermeille\" Sanchez、AliCat\n\n## 它是什么？\n\nCFG（无分类器引导）是一种用于帮助使提示词的某些部分变得不那么突出或更加突出的方法。\n\n### 支持的后端 API\n\n目前，支持的后端是 oobabooga 的 textgen WebUI、NovelAI 和 TabbyAPI。\nNovelAI 有自己的 [CFG 的文档](https://web.archive.org/web/20240917150051/https://docs.novelai.net/text/cfg.html).\n\n警告：由于摄取超过 1 提示词，CFG 会增加 VRAM 使用量！如果在启用 CFG 的情况下生成提示词时 GPU 内存耗尽，请考虑减小上下文大小、使用较小参数模型或完全关闭 CFG。\n\n***\n\n## 配置\n\n访问 CFG 设置与访问作者注释相同：\n\n![CF汉堡菜单png](/docs/sillytavern/static/cfg-hamburger.png)\n\nCFG 面板如下所示：\n\n![CFG聊天面板png](/docs/sillytavern/static/cfg-panel.png)\n\nCFG 面板中有四个下拉菜单：\n\n- 聊天CFG\n\n  - 将 CFG 比例和提示词的范围仅限于此聊天\n- 角色 CFG\n\n  - 将 CFG 比例和提示词的范围限定为指定的角色\n- 全球CFG\n\n  - 全局覆盖CFG比例和提示词（也覆盖模型预设！）\n- CFG 高级设置（以前称为 CFG 提示词级联）\n\n  - 组合前面 3 个下拉列表中的提示词并设置插入深度的位置。\n\n注意：如果引导比例设置为 1，则不会发送任何内容，因为此时 CFG 处于“关闭”状态。\n\n#### 群聊\n\n在群聊中，CFG比例面板如下所示：\n\n![CFG面板gcpng](/docs/sillytavern/static/cfg-groups.png)\n\n主要变化是删除了角色 CFG 并添加了一个名为 `Use Character CFG Scales` 存在于聊天 CFG 下拉列表中。这允许使用当前角色的引导比例，而不是聊天 CFG 比例设置的值。\n\n此功能的主要用途是根据每个角色的个人需求更改比例。\n\n此外，检查 `Character Negatives` 提示词级联中的框将附加独立的角色负提示词以及聊天框（如果启用）。\n\n***\n\n## 概念\n\n### 这不是稳定扩散吗？\n\n是和不是。法学硕士的 CFG 的工作方式与稳定扩散中的工作方式不同。基于 LLM 的 CFG 的工作原理是“提示词混合”。 CFG公式取正负提示词，然后混合 *差异* 他们之间。从那里，发送组合的提示词并生成响应！\n\n这是一个帮助形象化这个概念的插图。红色代表负值提示词，蓝色代表中性提示词，紫色代表解释的混合结果。所有 3 个提示词中的所有空白都是相同的，因此这些空白不用于 CFG 混合。\n\n![stcfg图表png](/docs/sillytavern/static/cfg-diagram.png)\n\n如果您想了解有关 CFG 和 LLM 的更多信息，Vermifuge 的原始论文位于此处。我建议读/听：\n\n- 纸 - [\\[2306.17806\\] 通过无分类器指导保持主题 (arxiv.org)](https://arxiv.org/abs//2306.17806)\n\n- 音频版本 - <https://www.youtube.com/watch?v=MGY00YFcyco>\n\n### 我需要CFG 提示词吗？\n\n不！ CFG 提示词完全可选。只需调整上面的指导比例即可 `1` 还将有助于对响应产生影响，从而可以加强聊天和角色互动。\n\n### CFG 提示词的品质如何？\n\n因此，我们确定 CFG 提示与稳定扩散的负面标签和嵌入不同。我们如何制作提示词？\n\n警告：这假设您已使用 PLists 和 Ali:Chat 创建了角色。如果您还没有，请随意尝试各种提示技巧。\n\n假设我有一个名为“John”的角色。从他的示例对话中，约翰应该一直感到快乐和兴奋。然而，在与约翰聊天时，他有时会感到悲伤和沮丧。\n\n为了消除这个问题，CFG 来救援！就做负数提示词 `[John's feelings: sad, depressed]` 帮助消除悲伤部分。您可以选择将正极设为提示词 `[John's feelings: happy, joyful]` 进一步衬托出约翰快乐的部分。\n\n### 积极提示\n\n我在上一节中讨论过这个问题，但我想再谈一下这个问题。正提示词用于进一步强调角色的部分。让我们再次以约翰为例。通过积极的提示词让他更快乐 `[John's feelings: happy, joyful]`，与不包含正面提示词相比，John 应该开始输出带有更快乐感觉的对话。\n\n### 但是...\n\n这些只是 **宽松的指导方针** 来自一种特定角色格式的经验。您还可以尝试许多其他方法来创建提示词。请随意与其他用户分享您的想法！\n\n### 指导量表\n\n这是一个经验法则。指导规模为 `1` 表示CFG 已禁用。事实上，如果指导比例为 1，SillyTavern 不会向您的后端发送任何内容。指导比例 `>1` 将给出其他部分不同程度显示的结果。\n\n然而，指导规模 `<1` 将给出 *对面* 因为负提示词在这里用作主要提示词。\n\n让我们再次使用约翰的例子。负的提示词是 `[John's feelings: sad, depressed]` 正提示词为 `[John's feelings: happy, joyful]` 指导规模为 `0.8`.\n\n这反过来又会强调 *消极的* 提示词更多，您会看到约翰开始表现得比平常更悲伤，而不是更快乐。\n\nTL;DR：使用指导量表 `1.5` 并根据您的输出从那里上下工作。\n\n### 提示词级联\n\n否定和肯定可以在 CFG 类型之间级联（类型为每聊天、每角色和全局覆盖）。有关详细信息，请参阅配置标头。\n\n### 插入深度\n\n遵循基本规则：提示词中的位置越低，对响应的影响越大。对于聊天，我建议使用默认深度 `1` 因为它与 SillyTavern 的其他组件非常灵活。\n\n但是，如果您想进行实验，插入深度为 `0` 是开放的。但是，这些可能会极大地改变您的响应的外观，因此不建议在此处使用提示词级联！\n",
      "searchText": "CFG 引导 页面编写者：kingbri 贡献者：kingbri、Guillaume \"Vermeille\" Sanchez、AliCat 它是什么？ CFG（无分类器引导）是一种用于帮助使提示词的某些部分变得不那么突出或更加突出的方法。 支持的后端 API 目前，支持的后端是 oobabooga 的 textgen WebUI、NovelAI 和 TabbyAPI。 NovelAI 有自己的 CFG 的文档. 警告：由于摄取超过 1 提示词，CFG 会增加 VRAM 使用量！如果在启用 CFG 的情况下生成提示词时 GPU 内存耗尽，请考虑减小上下文大小、使用较小参数模型或完全关闭 CFG。 配置 访问 CFG 设置与访问作者注释相同： CFG 面板如下所示： CFG 面板中有四个下拉菜单： 聊天CFG 将 CFG 比例和提示词的范围仅限于此聊天 角色 CFG 将 CFG 比例和提示词的范围限定为指定的角色 全球CFG 全局覆盖CFG比例和提示词（也覆盖模型预设！） CFG 高级设置（以前称为 CFG 提示词级联） 组合前面 3 个下拉列表中的提示词并设置插入深度的位置。 注意：如果引导比例设置为 1，则不会发送任何内容，因为此时 CFG 处于“关闭”状态。 群聊 在群聊中，CFG比例面板如下所示： 主要变化是删除了角色 CFG 并添加了一个名为 Use Character CFG Scales 存在于聊天 CFG 下拉列表中。这允许使用当前角色的引导比例，而不是聊天 CFG 比例设置的值。 此功能的主要用途是根据每个角色的个人需求更改比例。 此外，检查 Character Negatives 提示词级联中的框将附加独立的角色负提示词以及聊天框（如果启用）。 概念 这不是稳定扩散吗？ 是和不是。法学硕士的 CFG 的工作方式与稳定扩散中的工作方式不同。基于 LLM 的 CFG 的工作原理是“提示词混合”。 CFG公式取正负提示词，然后混合 差异 他们之间。从那里，发送组合的提示词并生成响应！ 这是一个帮助形象化这个概念的插图。红色代表负值提示词，蓝色代表中性提示词，紫色代表解释的混合结果。所有 3 个提示词中的所有空白都是相同的，因此这些空白不用于 CFG 混合。 如果您想了解有关 CFG 和 LLM 的更多信息，Vermifuge 的原始论文位于此处。我建议读/听： 纸 - [2306.17806] 通过无分类器指导保持主题 (arxiv.org) 音频版本 - https://www.youtube.com/watch?v=MGY00YFcyco 我需要CFG 提示词吗？ 不！ CFG 提示词完全可选。只需调整上面的指导比例即可 1 还将有助于对响应产生影响，从而可以加强聊天和角色互动。 CFG 提示词的品质如何？ 因此，我们确定 CFG 提示与稳定扩散的负面标签和嵌入不同。我们如何制作提示词？ 警告：这假设您已使用 PLists 和 Ali:Chat 创建了角色。如果您还没有，请随意尝试各种提示技巧。 假设我有一个名为“John”的角色。从他的示例对话中，约翰应该一直感到快乐和兴奋。然而，在与约翰聊天时，他有时会感到悲伤和沮丧。 为了消除这个问题，CFG 来救援！就做负数提示词 [John's feelings: sad, depressed] 帮助消除悲伤部分。您可以选择将正极设为提示词 [John's feelings: happy, joyful] 进一步衬托出约翰快乐的部分。 积极提示 我在上一节中讨论过这个问题，但我想再谈一下这个问题。正提示词用于进一步强调角色的部分。让我们再次以约翰为例。通过积极的提示词让他更快乐 [John's feelings: happy, joyful]，与不包含正面提示词相比，John 应该开始输出带有更快乐感觉的对话。 但是... 这些只是 宽松的指导方针 来自一种特定角色格式的经验。您还可以尝试许多其他方法来创建提示词。请随意与其他用户分享您的想法！ 指导量表 这是一个经验法则。指导规模为 1 表示CFG 已禁用。事实上，如果指导比例为 1，SillyTavern 不会向您的后端发送任何内容。指导比例 >1 将给出其他部分不同程度显示的结果。 然而，指导规模 <1 将给出 对面 因为负提示词在这里用作主要提示词。 让我们再次使用约翰的例子。负的提示词是 [John's feelings: sad, depressed] 正提示词为 [John's feelings: happy, joyful] 指导规模为 0.8. 这反过来又会强调 消极的 提示词更多，您会看到约翰开始表现得比平常更悲伤，而不是更快乐。 TL;DR：使用指导量表 1.5 并根据您的输出从那里上下工作。 提示词级联 否定和肯定可以在 CFG 类型之间级联（类型为每聊天、每角色和全局覆盖）。有关详细信息，请参阅配置标头。 插入深度 遵循基本规则：提示词中的位置越低，对响应的影响越大。对于聊天，我建议使用默认深度 1 因为它与 SillyTavern 的其他组件非常灵活。 但是，如果您想进行实验，插入深度为 0 是开放的。但是，这些可能会极大地改变您的响应的外观，因此不建议在此处使用提示词级联！",
      "translationStatus": "machine-draft"
    },
    {
      "slug": "prompts/prompt-manager",
      "title": "提示词管理器",
      "group": "Prompts",
      "order": 50,
      "source": "Usage/Prompts/prompt-manager.md",
      "sourceUrl": "https://docs.sillytavern.app/usage/prompts/prompt-manager/",
      "sourceSha256": "c78738b914215b16795d410b3f96bc6294450486b52be3c84da0605dcc355697",
      "headings": [
        {
          "id": "prompt-manager",
          "depth": 1,
          "title": "提示词管理器"
        },
        {
          "id": "quick-prompts-edit",
          "depth": 2,
          "title": "快速提示编辑"
        },
        {
          "id": "utility-prompts",
          "depth": 2,
          "title": "实用程序提示"
        },
        {
          "id": "format-templates",
          "depth": 3,
          "title": "格式模板"
        },
        {
          "id": "group-nudge-prompt-template",
          "depth": 3,
          "title": "群组微调提示词模板"
        },
        {
          "id": "new-chat-new-group-chat-new-example-chat",
          "depth": 3,
          "title": "新聊天、新群聊天、新示例聊天"
        },
        {
          "id": "continue-nudge",
          "depth": 3,
          "title": "继续轻推"
        },
        {
          "id": "replace-empty-message",
          "depth": 3,
          "title": "替换空消息"
        },
        {
          "id": "character-names-behavior",
          "depth": 2,
          "title": "角色名称行为"
        },
        {
          "id": "continue-postfix",
          "depth": 2,
          "title": "继续后缀"
        },
        {
          "id": "additional-settings",
          "depth": 2,
          "title": "附加设置"
        },
        {
          "id": "wrap-in-quotes",
          "depth": 3,
          "title": "用引号引起来"
        },
        {
          "id": "continue-prefill",
          "depth": 3,
          "title": "继续预填"
        },
        {
          "id": "squash-system-messages",
          "depth": 3,
          "title": "壁球系统消息"
        },
        {
          "id": "enable-web-search",
          "depth": 3,
          "title": "启用网络搜索"
        },
        {
          "id": "enable-function-calling",
          "depth": 3,
          "title": "启用函数调用"
        },
        {
          "id": "send-inline-images-send-inline-videos",
          "depth": 3,
          "title": "发送内嵌图像、发送内嵌视频"
        },
        {
          "id": "request-inline-images",
          "depth": 3,
          "title": "请求内嵌图像"
        },
        {
          "id": "use-system-prompt",
          "depth": 3,
          "title": "使用系统提示词"
        },
        {
          "id": "reasoning-settings",
          "depth": 2,
          "title": "推理设置"
        },
        {
          "id": "request-model-reasoning",
          "depth": 3,
          "title": "请求模型推理"
        },
        {
          "id": "reasoning-effort",
          "depth": 3,
          "title": "推理努力"
        },
        {
          "id": "prompts",
          "depth": 2,
          "title": "“提示”"
        },
        {
          "id": "the-prompts-dropdown",
          "depth": 3,
          "title": "“提示”下拉菜单"
        },
        {
          "id": "prompts-list",
          "depth": 3,
          "title": "提示列表"
        },
        {
          "id": "editing-a-prompt",
          "depth": 2,
          "title": "编辑提示词"
        },
        {
          "id": "name",
          "depth": 3,
          "title": "名称"
        },
        {
          "id": "role",
          "depth": 3,
          "title": "角色"
        },
        {
          "id": "triggers",
          "depth": 3,
          "title": "触发器"
        },
        {
          "id": "position",
          "depth": 3,
          "title": "职位"
        },
        {
          "id": "depth",
          "depth": 3,
          "title": "深度"
        },
        {
          "id": "order",
          "depth": 3,
          "title": "订单"
        },
        {
          "id": "building-your-prompt-tips-and-tricks",
          "depth": 2,
          "title": "构建您的提示词：提示和技巧"
        }
      ],
      "content": "# 提示词管理器\n\n提示词管理器是一个提供更多控制的系统 [提示词-大楼](/guides/sillytavern/prompts/) 聊天补全 API 的策略。\n\n> **适用于：聊天补全 API**\n>\n> 对于文本补全 API 中的等效设置，请使用 [高级格式设置](/guides/sillytavern/core-concepts/advancedformatting/).\n\n> **命名预设**\n>\n> 如果预设与您的角色卡之一共享名称，则在开始与该角色聊天时会自动选择该预设。名称预设了一些独特的内容以避免这种行为。\n\n点击导航栏中的“AI响应配置”按钮即可访问提示词管理器。 提示词管理器位于 [通用设置](/guides/sillytavern/common-settings/) 面板。\n\n## 快速提示编辑\n\n提供快速编辑常见提示词部分的空间，例如 **主提示词**, **辅助提示词**, 和 **历史后指令**。有关这些提示词的更多信息，请访问 [提示词-大楼](/guides/sillytavern/prompts/) 页。\n\n## 实用程序提示\n\n这些提示词被发送到聊天补全模型，以帮助它理解发送给它的信息，或指示它在某些类型的交互过程中以特定方式采取行动。\n\n### 格式模板\n\n> 如果未设置格式模板，则信息将按原样发送，不进行任何换行。\n\n这些是字符串模板，用于包装从中提取的信息 [世界书](/guides/sillytavern/core-concepts/worldinfo/) 和 [角色卡](/guides/sillytavern/core-concepts/characterdesign/).\n\n特殊标记用于指示应插入信息的位置：\n\n- `{0}` 对于世界书格式模板。\n- `{{scenario}}` 用于场景格式模板。\n- `{{personality}}` 用于个性格式模板。\n\n### 群组微调提示词模板\n\n仅在群聊中使用。放置在提示词的末尾以强制来自特定角色的回复。\n\n将此留空以禁用“组微移”功能。\n\n### 新聊天、新群聊天、新示例聊天\n\n这些在聊天记录之前和每个之前发送 [对话示例](/guides/sillytavern/core-concepts/characterdesign/#examples-of-dialogue) 阻止通知模型背景信息结束和聊天历史记录开始的位置。\n\n- **新聊天：** 用于个人聊天。\n- **新群聊：** 用于群聊。\n- **新的聊天示例：** 用于例如对话块。\n\n将这些留空以禁用此功能。\n\n### 继续轻推\n\n在提示词末尾发送，指示模型在触发“继续”时（例如按下“继续”按钮或由 STScript 触发时）做什么。\n\n> **聊天补全“继续”**\n>\n> 请记住，聊天补全型号处理继续的方式与 **文本补全** 模型，并且无论您如何继续微移，都可能无法始终提供无缝结果。\n\n### 替换空消息\n\n当文本框为空且文本框为空时，发送此字段的内容而不是空白消息 **发送消息** 被按下。\n\n## 角色名称行为\n\n提供不同的策略来指示模型如何将消息与角色关联。如果聊天补全模型无法确定哪些消息属于哪个角色，则可能需要选择不同的策略。\n\n## 继续后缀\n\n触发“继续”时，模型返回的“继续”消息会将所选的“继续后缀”添加到开头。例如，它可以在连续文本之前添加一个空格。\n\n## 附加设置\n\n### 用引号引起来\n\n> 已弃用的选项。更喜欢 [正则表达式脚本](https://docs.sillytavern.app/extensions/regex/) 相反。\n\n发送前将整个用户消息用隐藏引号括起来。这对于角色不使用引号来指示语音的会话非常有用。如果您的会话使用引号来表示语音，请不要选中此选项。\n\n### 继续预填\n\n> 可能不适用于所有聊天补全源。\n\n将“继续微移”作为助理角色消息而不是系统消息发送。如果启用此功能，将不会使用继续微移提示词。\n\n### 壁球系统消息\n\n> 已弃用的选项。更喜欢 [提示词后处理](/guides/sillytavern/api-connections/openai/#prompt-post-processing) 相反。\n\n将连续的系统消息组合成单个组合消息（不包括示例对话）。\n\n### 启用网络搜索\n\n> 不要与 [网页搜索扩展](https://docs.sillytavern.app/extensions/websearch/).\n\n启用聊天补全后端提供的网络搜索功能。 提示词通常由模型提供商提供丰富的搜索结果，并且可能会产生额外费用。\n\n### 启用函数调用\n\n参见 [函数调用](https://docs.sillytavern.app/for-contributors/function-calling/)\n\n### 发送内嵌图像、发送内嵌视频\n\n> 不要与 [图像字幕扩展](https://docs.sillytavern.app/extensions/captioning/).\n\n如果聊天补全模型具有处理提交的图像和视频的多模式功能，则会切换其执行此操作的能力。要将媒体附加到提示词，请使用 **附加文件** “魔棒”菜单中的选项。\n\n### 请求内嵌图像\n\n> 不要与 [图像生成扩展](https://docs.sillytavern.app/extensions/stable-diffusion/).\n\n允许模型返回图像附件。\n\n### 使用系统提示词\n\n> 仅受 Google Gemini 和 Anthropic Claude 后端支持。\n>\n> 尽管这两个选项的设置非常相似，但它们在技术上是独立的选项，因此可以单独配置。\n\n合并所有系统消息，直到第一条具有非系统角色（用户/助理）的消息，并将它们作为单独的系统指令字段发送。\n\n## 推理设置\n\n如果聊天补全模型使用推理，这些设置会影响其可见性和功能。\n\n### 请求模型推理\n\n参见 [添加推理：通过后端](/guides/sillytavern/prompts/reasoning/#by-backend).\n\n### 推理努力\n\n参见 [推理努力](/guides/sillytavern/prompts/reasoning/#reasoning-effort).\n\n## “提示”\n\n提示词管理器构成发送到聊天补全模型的提示词的骨干。它控制发送的内容以及 *订单* 它被发送到其中。\n\n### “提示”下拉菜单\n\n包含所有的下拉列表（非默认）提示词即当前的聊天补全预设包括。对于其中之一提示词要添加到外发消息中，需要从下拉列表中选择它，然后添加到提示词管理器通过按**插入提示词** 按钮。要创建新的提示词以添加到此下拉列表中，请按 **新款提示词** 按钮。一旦新的提示词被写入并保存，它就会被添加到下拉列表中，然后可以插入。\n\n### 提示列表\n\n这是一个拖放界面，列出了选择的可能发送到聊天补全模型的提示词。提示符放置在靠近 **顶部** 接口的内容较早发送。的 **底部** 列表中的是 **最后一件事** 发送到模型（通常，这将是您的 **历史后指令**).\n\n> **“固定”提示词 = 默认提示词**\n>\n> 无法从所选提示词列表中删除默认提示词。这包括主要提示词、世界书（之前/之后）、用户人设描述、角色描述、角色个性、场景、增强定义、辅助提示词、聊天示例、聊天历史和历史后指令。如果不需要这些，可以将它们 **切换为“关闭”**，但没有彻底删除或删除。\n\n## 编辑提示词\n\n单击 **铅笔按钮** 在提示词上将带您到 **编辑界面**。在这里，您可以直接编辑提示词。\n\n> **请务必保存您的更改！**\n>\n> 要永久保存对聊天补全预设中这些提示词的更改，您必须单击 **保存** 按钮位于右下角 **编辑界面**，以及使用保存预设本身 **保存** 按钮位于顶部 **AI响应配置** 部分！否则，当聊天补全预设切换到另一预设时，所做的更改将会丢失。\n\n### 名称\n\n名称为提示词。这不会发送到聊天补全型号；仅供您在提示词管理器内参考。\n\n### 角色\n\n哪个角色发送提示词。您可以在“系统”、“AI 助手”或“用户”之间进行选择。\n\n### 触发器\n\n发送此提示词的生成类型。如果未选择任何内容，则将为所有生成类型发送提示词。如果选择一项或多项，则仅针对这些特定生成类型发送提示词：\n\n- **正常：** 定期消息生成请求。\n- **继续：** 当按下继续按钮时。\n- **冒充：** 当按下模拟按钮时。\n- **滑动：** 当通过滑动触发生成时。\n- **再生：** 在单人聊天中按下“重新生成”按钮时。\n- **安静：** 后台生成请求，通常由 [扩展](https://docs.sillytavern.app/extensions/) 或 [ST脚本](https://docs.sillytavern.app/usage/st-script/) 命令。\n\n> “重新生成”触发器在群聊中不可用，因为它使用不同的重新生成逻辑：最后回复的所有消息都将被删除，并且根据所选的“正常”生成类型对消息进行排队 [群组回复策略](/guides/sillytavern/core-concepts/groupchats/#reply-order-strategies).\n\n### 职位\n\n当位置设置为 **相对**，此提示词与所有其他提示词一起发送到拖放界面中它所在的位置。当设置为 **聊天中** 并给出一个 **深度**，而是发送 **在聊天记录中** 作为所选角色，并且 **忽略** 拖放界面的顺序。\n\n### 深度\n\n当位置设置为 **聊天中**，这定义了提示词在聊天历史记录中发送的深度。数字越大，发送的深度越深。例如，深度 0 将在最后一条聊天消息之后发送，深度 1 将在最后一条聊天消息之前发送，深度 2 将在倒数第二条聊天消息之前发送，依此类推。\n\n### 订单\n\n> 具有相同角色和深度的提示将被分组在一起并按其顺序值排序。\n> 顺序如下（从上到下）：用户、AI助手、系统。\n\n当位置设置为 **聊天中**，这定义了提示词在聊天历史记录中发送的顺序。数字越小，发送越早。\n\n## 构建您的提示词：提示和技巧\n\n参观 [提示词-大楼](/guides/sillytavern/prompts/) 有关如何编写有效的提示词的更多信息，请参阅 SillyTavern 文档部分。该信息很大程度上可应用于聊天补全预设。\n",
      "searchText": "提示词管理器 提示词管理器是一个提供更多控制的系统 提示词-大楼 聊天补全 API 的策略。 适用于：聊天补全 API 对于文本补全 API 中的等效设置，请使用 高级格式设置. 命名预设 如果预设与您的角色卡之一共享名称，则在开始与该角色聊天时会自动选择该预设。名称预设了一些独特的内容以避免这种行为。 点击导航栏中的“AI响应配置”按钮即可访问提示词管理器。 提示词管理器位于 通用设置 面板。 快速提示编辑 提供快速编辑常见提示词部分的空间，例如 主提示词, 辅助提示词, 和 历史后指令。有关这些提示词的更多信息，请访问 提示词-大楼 页。 实用程序提示 这些提示词被发送到聊天补全模型，以帮助它理解发送给它的信息，或指示它在某些类型的交互过程中以特定方式采取行动。 格式模板 如果未设置格式模板，则信息将按原样发送，不进行任何换行。 这些是字符串模板，用于包装从中提取的信息 世界书 和 角色卡. 特殊标记用于指示应插入信息的位置： {0} 对于世界书格式模板。 {{scenario}} 用于场景格式模板。 {{personality}} 用于个性格式模板。 群组微调提示词模板 仅在群聊中使用。放置在提示词的末尾以强制来自特定角色的回复。 将此留空以禁用“组微移”功能。 新聊天、新群聊天、新示例聊天 这些在聊天记录之前和每个之前发送 对话示例 阻止通知模型背景信息结束和聊天历史记录开始的位置。 新聊天： 用于个人聊天。 新群聊： 用于群聊。 新的聊天示例： 用于例如对话块。 将这些留空以禁用此功能。 继续轻推 在提示词末尾发送，指示模型在触发“继续”时（例如按下“继续”按钮或由 STScript 触发时）做什么。 聊天补全“继续” 请记住，聊天补全型号处理继续的方式与 文本补全 模型，并且无论您如何继续微移，都可能无法始终提供无缝结果。 替换空消息 当文本框为空且文本框为空时，发送此字段的内容而不是空白消息 发送消息 被按下。 角色名称行为 提供不同的策略来指示模型如何将消息与角色关联。如果聊天补全模型无法确定哪些消息属于哪个角色，则可能需要选择不同的策略。 继续后缀 触发“继续”时，模型返回的“继续”消息会将所选的“继续后缀”添加到开头。例如，它可以在连续文本之前添加一个空格。 附加设置 用引号引起来 已弃用的选项。更喜欢 正则表达式脚本 相反。 发送前将整个用户消息用隐藏引号括起来。这对于角色不使用引号来指示语音的会话非常有用。如果您的会话使用引号来表示语音，请不要选中此选项。 继续预填 可能不适用于所有聊天补全源。 将“继续微移”作为助理角色消息而不是系统消息发送。如果启用此功能，将不会使用继续微移提示词。 壁球系统消息 已弃用的选项。更喜欢 提示词后处理 相反。 将连续的系统消息组合成单个组合消息（不包括示例对话）。 启用网络搜索 不要与 网页搜索扩展. 启用聊天补全后端提供的网络搜索功能。 提示词通常由模型提供商提供丰富的搜索结果，并且可能会产生额外费用。 启用函数调用 参见 函数调用 发送内嵌图像、发送内嵌视频 不要与 图像字幕扩展. 如果聊天补全模型具有处理提交的图像和视频的多模式功能，则会切换其执行此操作的能力。要将媒体附加到提示词，请使用 附加文件 “魔棒”菜单中的选项。 请求内嵌图像 不要与 图像生成扩展. 允许模型返回图像附件。 使用系统提示词 仅受 Google Gemini 和 Anthropic Claude 后端支持。 尽管这两个选项的设置非常相似，但它们在技术上是独立的选项，因此可以单独配置。 合并所有系统消息，直到第一条具有非系统角色（用户/助理）的消息，并将它们作为单独的系统指令字段发送。 推理设置 如果聊天补全模型使用推理，这些设置会影响其可见性和功能。 请求模型推理 参见 添加推理：通过后端. 推理努力 参见 推理努力. “提示” 提示词管理器构成发送到聊天补全模型的提示词的骨干。它控制发送的内容以及 订单 它被发送到其中。 “提示”下拉菜单 包含所有的下拉列表（非默认）提示词即当前的聊天补全预设包括。对于其中之一提示词要添加到外发消息中，需要从下拉列表中选择它，然后添加到提示词管理器通过按插入提示词 按钮。要创建新的提示词以添加到此下拉列表中，请按 新款提示词 按钮。一旦新的提示词被写入并保存，它就会被添加到下拉列表中，然后可以插入。 提示列表 这是一个拖放界面，列出了选择的可能发送到聊天补全模型的提示词。提示符放置在靠近 顶部 接口的内容较早发送。的 底部 列表中的是 最后一件事 发送到模型（通常，这将是您的 历史后指令). “固定”提示词 = 默认提示词 无法从所选提示词列表中删除默认提示词。这包括主要提示词、世界书（之前/之后）、用户人设描述、角色描述、角色个性、场景、增强定义、辅助提示词、聊天示例、聊天历史和历史后指令。如果不需要这些，可以将它们 切换为“关闭”，但没有彻底删除或删除。 编辑提示词 单击 铅笔按钮 在提示词上将带您到 编辑界面。在这里，您可以直接编辑提示词。 请务必保存您的更改！ 要永久保存对聊天补全预设中这些提示词的更改，您必须单击 保存 按钮位于右下角 编辑界面，以及使用保存预设本身 保存 按钮位于顶部 AI响应配置 部分！否则，当聊天补全预设切换到另一预设时，所做的更改将会丢失。 名称 名称为提示词。这不会发送到聊天补全型号；仅供您在提示词管理器内参考。 角色 哪个角色发送提示词。您可以在“系统”、“AI 助手”或“用户”之间进行选择。 触发器 发送此提示词的生成类型。如果未选择任何内容，则将为所有生成类型发送提示词。如果选择一项或多项，则仅针对这些特定生成类型发送提示词： 正常： 定期消息生成请求。 继续： 当按下继续按钮时。 冒充： 当按下模拟按钮时。 滑动： 当通过滑动触发生成时。 再生： 在单人聊天中按下“重新生成”按钮时。 安静： 后台生成请求，通常由 扩展 或 ST脚本 命令。 “重新生成”触发器在群聊中不可用，因为它使用不同的重新生成逻辑：最后回复的所有消息都将被删除，并且根据所选的“正常”生成类型对消息进行排队 群组回复策略. 职位 当位置设置为 相对，此提示词与所有其他提示词一起发送到拖放界面中它所在的位置。当设置为 聊天中 并给出一个 深度，而是发送 在聊天记录中 作为所选角色，并且 忽略 拖放界面的顺序。 深度 当位置设置为 聊天中，这定义了提示词在聊天历史记录中发送的深度。数字越大，发送的深度越深。例如，深度 0 将在最后一条聊天消息之后发送，深度 1 将在最后一条聊天消息之前发送，深度 2 将在倒数第二条聊天消息之前发送，依此类推。 订单 具有相同角色和深度的提示将被分组在一起并按其顺序值排序。 顺序如下（从上到下）：用户、AI助手、系统。 当位置设置为 聊天中，这定义了提示词在聊天历史记录中发送的顺序。数字越小，发送越早。 构建您的提示词：提示和技巧 参观 提示词-大楼 有关如何编写有效的提示词的更多信息，请参阅 SillyTavern 文档部分。该信息很大程度上可应用于聊天补全预设。",
      "translationStatus": "machine-draft"
    },
    {
      "slug": "prompts/reasoning",
      "title": "推理",
      "group": "Prompts",
      "order": 40,
      "source": "Usage/Prompts/reasoning.md",
      "sourceUrl": "https://docs.sillytavern.app/usage/prompts/reasoning/",
      "sourceSha256": "fe5f34d5779c8de81c6b4b87737da35da0591e173bd5bd4b52e969e417cade39",
      "headings": [
        {
          "id": "reasoning",
          "depth": 1,
          "title": "推理"
        },
        {
          "id": "common-issues",
          "depth": 2,
          "title": "常见问题"
        },
        {
          "id": "configuration",
          "depth": 2,
          "title": "配置"
        },
        {
          "id": "adding-reasoning",
          "depth": 2,
          "title": "添加推理"
        },
        {
          "id": "manually",
          "depth": 3,
          "title": "手动"
        },
        {
          "id": "with-a-command",
          "depth": 3,
          "title": "通过命令"
        },
        {
          "id": "by-backend",
          "depth": 3,
          "title": "通过后端"
        },
        {
          "id": "by-parsing",
          "depth": 3,
          "title": "通过解析"
        },
        {
          "id": "prompting-with-reasoning",
          "depth": 2,
          "title": "推理提示"
        },
        {
          "id": "continuing-from-reasoning",
          "depth": 3,
          "title": "继续推理"
        },
        {
          "id": "regex-scripts",
          "depth": 2,
          "title": "正则表达式脚本"
        },
        {
          "id": "reasoning-effort",
          "depth": 2,
          "title": "推理努力"
        }
      ],
      "content": "# 推理\n\n在语言模型中，推理（也称为模型思维）是指一种思维链（CoT）技术，它反映了人类通过逐步分析解决问题的过程。 SillyTavern 提供了多种功能，使推理模型的使用在支持的后端之间更加高效和一致。\n\n## 常见问题\n\n1. 使用推理模型时，模型的内部推理过程会消耗您的响应 token 津贴的一部分，即使此推理未显示在最终输出中（例如 o3-mini 或 Gemini Thinking）。如果您发现您的回复不完整或为空，您应该尝试调整最大响应长度设置 **<i class=\"fa-solid fa-sliders\"></i> AI响应配置** 面板。对于推理模型，与标准会话模型相比，通常使用明显更高的 token 限制（从 1024 到 4096 token）。\n\n## 配置\n\n> 大多数与推理相关的设置可以在“推理”部分进行配置 **<i class=\"fa-solid fa-font\"></i> 高级格式化** 面板。\n\n推理块在聊天中显示为可折叠的消息部分。它们可以手动添加、由后端自动添加或通过响应解析添加（见下文）。\n\n默认情况下，推理块会折叠以节省空间。单击一个块可展开并查看其内容。您可以通过启用来设置块自动扩展 **自动扩展** 在推理设置中。\n\n当推理块展开时，您可以使用复制或编辑其内容 **<i class=\"fa-solid fa-copy\"></i> 复制** 和 **<i class=\"fa-solid fa-pencil\"></i> 编辑** 按钮。\n\n有些模型支持推理，但不会将自己的想法发回。仍然可以通过切换来显示推理块和推理时间。 **显示隐藏** 设置。\n\n## 添加推理\n\n### 手动\n\n通过以下方式向任何消息添加推理块 **<i class=\"fa-solid fa-pencil\"></i> 留言编辑** 菜单。点击 **<i class=\"fa-solid fa-lightbulb\"></i>** 在编辑时添加推理部分。第三方扩展还可以通过写入来添加推理 `extra.reasoning` 消息对象的字段，然后将其添加到聊天中。\n\n### 通过命令\n\n使用 `/reasoning-set` 用于向消息添加推理的 STscript 命令。该命令需要 `at` （消息 ID，默认为最后一条消息）和推理文本作为参数。\n\n```stscript\n/reasoning-set at=0 This is the reasoning for the first message.\n```\n\n### 通过后端\n\n如果您选择的LLM后端和模型支持推理输出，请在 **<i class=\"fa-solid fa-sliders\"></i> AI响应配置** 面板将添加一个包含模型思维过程的推理块。\n\n支持的来源：\n\n- 克洛德\n- 深度搜索\n- 谷歌人工智能工作室\n- 谷歌顶点人工智能\n- 开放路由器\n- xAI（格洛克）\n- 人工智能/机器学习API\n- 扎艾\n- 授粉\n- 米斯特拉尔人工智能\n- 电子集线器\n- 滑道\n- 纳米GPT\n- 登月计划\n\n> 对于 **大多数** 消息人士称，“请求模型推理”并不能确定模型是否进行推理，因为它无法被禁用。如果后端和模型支持明确请求禁用推理，则该设置将这样做。否则，模型将始终推理。\n\n提供商特定说明：\n\n- 克劳德和谷歌（2.5 Flash）允许切换思维模式；看到 [推理努力](#reasoning-effort).\n- 可以禁用推理 [Z.AI (GLM)](https://docs.z.ai/api-reference/llm/chat-completion#body-one-of-0-thinking) 和 [登月（基米）](https://platform.moonshot.ai/docs/guide/use-kimi-k2-thinking-model)。该设置映射到 `thinking.type` 参数。他们不支持“推理努力”。\n- 对于 OpenRouter，当“请求模型推理”开关在设置最小推理工作量的情况下停用时，支持它的模型的思维将被设置为禁用。该行为取决于模型；某些提供商可能会拒绝此类请求。\n\n### 通过解析\n\n启用“自动解析” **<i class=\"fa-solid fa-font\"></i> 高级格式化** 面板自动解析模型输出的推理。\n\n响应必须包含包含在配置的前缀和后缀序列中的推理部分。默认提供的序列对应于 DeepSeek R1 推理格式。对于某些返回未解析推理的 API 源（例如 MiniMax 或 Perplexity），需要启用此功能。\n\n带前缀的示例 `<think>` 和后缀 `</think>`:\n\n```txt\n<think>\nThis is the reasoning.\n</think>\n\nThis is the main content.\n```\n\n## 推理提示\n\n默认情况下，已识别的推理块内容不会发送回模型。要在提示词中包含推理，请在 **<i class=\"fa-solid fa-font\"></i> 高级格式化** 面板。推理内容将包装在配置的前缀和后缀序列中，并通过分隔符与主上下文分开。最大添加数字设置控制可以包含多少个推理块，从提示词末尾开始计数。\n\n> 大多数模型提供商不建议在多轮对话中将 CoT 发送回模型。\n\n### 继续推理\n\n一种特殊情况是，在不启用“添加到提示”切换的情况下，可以将推理发送回模型，即继续生成（例如，通过按“继续”） **<i class=\"fa-solid fa-bars\"></i> 选项** 菜单），但正在继续的消息仅包含推理而没有实际内容。这使得模型有机会完成不完整的推理并开始生成主要内容。 提示词将按如下方式发送：\n\n```txt\n<think>\nIncomplete reasoning...\n```\n\n## 正则表达式脚本\n\n正则表达式脚本来自 [正则表达式扩展](https://docs.sillytavern.app/extensions/regex/) 可以应用于推理块的内容。检查脚本编辑器“影响”部分中的“推理”以专门针对推理块。\n\n不同的短暂性选项通过以下方式影响推理块：\n\n1. 没有短暂性：推理内容会永久改变。\n2. 编辑时运行：编辑推理块时将重新评估正则表达式脚本。\n3. 更改聊天显示：正则表达式应用于推理块的显示文本，而不是底层内容。\n4. 更改传出提示词：正则表达式仅在推理块发送到模型之前应用于推理块。\n\n## 推理努力\n\n推理努力是聊天补全设置 **<i class=\"fa-solid fa-sliders\"></i> AI响应配置** 影响可能用于推理的 token 数量的面板。每个选项的效果取决于所连接的源。对于以下来源，“自动”仅表示请求中不包含相关参数。\n\n| 选项 | 克劳德（如果没有流媒体，则≤ 21333） | OpenAI（关键词）     | OpenRouter（关键字） | xAI (Grok)（关键字） | 困惑（关键词） | NanoGPT（关键字） |\n| -- | --------------------- | --------------- | --------------- | --------------- | ------- | ------------ |\n| 型号 | 作品 4、十四行诗 4/3.7       | o4-迷你、o3\\*、o1\\* | 适用机型            | grok-3-迷你       | 声纳深度研究  | 适用机型         |\n| 汽车 | 未指定， **没有思考**         | 未指定             | 未指定，效果取决于       | 未指定             | 未指定     | 未指定          |\n| 最低 | 预算 1024 token         | “低”             | “低”，或最大响应的 20%  | “低”             | “低”     | “无”          |\n| 低  | 最大响应的 15%，最小值 1024    | “低”             | “低”，或最大响应的 20%  | “低”             | “低”     | “最小”         |\n| 中等 | 最大响应的 25%，最小值 1024    | “中”             | “中”，或最大响应的 50%  | “低”             | “中”     | “低”          |\n| 高  | 最大响应的 50%，最小值 1024    | “高”             | “高”，或最大响应的 80%  | “高”             | “高”     | “中”          |\n| 最大 | 最大响应的 95%，最小值 1024    | “高”             | “高”，或最大响应的 80%  | “高”             | “高”     | “高”          |\n\n- 对于不支持自适应思维的旧版 Claude 模型，如果禁用流式传输，预算上限为 21333。如果计算出的预算小于 1024，则最大响应更改为 2048。\n- Claude 还支持 Opus 4.6+ 模型的自适应思维，可以通过以下方式启用 `claude.enableAdaptiveThinking` 在 [配置.yaml](https://docs.sillytavern.app/administration/config-yaml/) （Opus 4.7+ 始终开启）。启用后，推理工作量设置会映射到自适应思维级别，而不是 token 预算。对于适用型号，此设置优先于“详细程度”设置。\n- 对于 OpenRouter、Pollinations、Perplexity、xAI、Chutes、DeepSeek、AI/ML API、xAI、Electron Hub，只会发送 OpenAI 风格的关键字。\n- 对于 OpenAI 上的 GPT-5.4 和 GPT-5.5 模型，“最小”推理工作对应于“无”，即禁用推理。\n- 对于作为聊天补全自定义 API 源运行的 KoboldCpp，推理工作作为 `reasoning_effort` 参数值为“minimal”、“low”、“medium”、“high”和“xhigh”。\n- 对于其他自定义（OpenAI 兼容）源，仅当模型在官方 OpenAI 源上支持时才会发送推理工作。\n\nGoogle AI Studio 和 Vertex AI 如下：\n\n| 型号          | 自动（动态思维） | 最低          | 低                 | 中等      | 高       | 最大               |\n| ----------- | -------- | ----------- | ----------------- | ------- | ------- | ---------------- |\n| 2.5专业版      | 思考预算=-1  | 128         | 最大响应的 15%，最小值 128 | 最大的 25% | 最大的 50% | 最大值或 32768 中的较低者 |\n| 2.5 闪存      | 思考预算=-1  | 0, **没有思考** | 最大响应的 15%         | 最大的 25% | 最大的 50% | 最大值或 24576 中的较低者 |\n| 2.5 闪存精简版   | 思考预算=-1  | 0, **没有思考** | 最大响应的 15%，最小值 512 | 最大的 25% | 最大的 50% | 最大值或 24576 中的较低者 |\n| 3.0/3.1 专业版 | 思维水平=空   | “低”         | “低”               | “低”     | “高”     | “高”              |\n| 3.0/3.1闪存   | 思维水平=空   | “最小”        | “低”               | “中”     | “高”     | “高”              |\n\n- 对于 Gemini 2.5 Pro 和 2.5 Flash/Lite，无论流媒体设置如何，预算上限分别为 32768 或 24576 token。\n",
      "searchText": "推理 在语言模型中，推理（也称为模型思维）是指一种思维链（CoT）技术，它反映了人类通过逐步分析解决问题的过程。 SillyTavern 提供了多种功能，使推理模型的使用在支持的后端之间更加高效和一致。 常见问题 使用推理模型时，模型的内部推理过程会消耗您的响应 token 津贴的一部分，即使此推理未显示在最终输出中（例如 o3-mini 或 Gemini Thinking）。如果您发现您的回复不完整或为空，您应该尝试调整最大响应长度设置 AI响应配置 面板。对于推理模型，与标准会话模型相比，通常使用明显更高的 token 限制（从 1024 到 4096 token）。 配置 大多数与推理相关的设置可以在“推理”部分进行配置 高级格式化 面板。 推理块在聊天中显示为可折叠的消息部分。它们可以手动添加、由后端自动添加或通过响应解析添加（见下文）。 默认情况下，推理块会折叠以节省空间。单击一个块可展开并查看其内容。您可以通过启用来设置块自动扩展 自动扩展 在推理设置中。 当推理块展开时，您可以使用复制或编辑其内容 复制 和 编辑 按钮。 有些模型支持推理，但不会将自己的想法发回。仍然可以通过切换来显示推理块和推理时间。 显示隐藏 设置。 添加推理 手动 通过以下方式向任何消息添加推理块 留言编辑 菜单。点击 在编辑时添加推理部分。第三方扩展还可以通过写入来添加推理 extra.reasoning 消息对象的字段，然后将其添加到聊天中。 通过命令 使用 /reasoning-set 用于向消息添加推理的 STscript 命令。该命令需要 at （消息 ID，默认为最后一条消息）和推理文本作为参数。 /reasoning-set at=0 This is the reasoning for the first message. 通过后端 如果您选择的LLM后端和模型支持推理输出，请在 AI响应配置 面板将添加一个包含模型思维过程的推理块。 支持的来源： 克洛德 深度搜索 谷歌人工智能工作室 谷歌顶点人工智能 开放路由器 xAI（格洛克） 人工智能/机器学习API 扎艾 授粉 米斯特拉尔人工智能 电子集线器 滑道 纳米GPT 登月计划 对于 大多数 消息人士称，“请求模型推理”并不能确定模型是否进行推理，因为它无法被禁用。如果后端和模型支持明确请求禁用推理，则该设置将这样做。否则，模型将始终推理。 提供商特定说明： 克劳德和谷歌（2.5 Flash）允许切换思维模式；看到 推理努力. 可以禁用推理 Z.AI (GLM) 和 登月（基米）。该设置映射到 thinking.type 参数。他们不支持“推理努力”。 对于 OpenRouter，当“请求模型推理”开关在设置最小推理工作量的情况下停用时，支持它的模型的思维将被设置为禁用。该行为取决于模型；某些提供商可能会拒绝此类请求。 通过解析 启用“自动解析” 高级格式化 面板自动解析模型输出的推理。 响应必须包含包含在配置的前缀和后缀序列中的推理部分。默认提供的序列对应于 DeepSeek R1 推理格式。对于某些返回未解析推理的 API 源（例如 MiniMax 或 Perplexity），需要启用此功能。 带前缀的示例 <think> 和后缀 </think>: <think> This is the reasoning. </think> This is the main content. 推理提示 默认情况下，已识别的推理块内容不会发送回模型。要在提示词中包含推理，请在 高级格式化 面板。推理内容将包装在配置的前缀和后缀序列中，并通过分隔符与主上下文分开。最大添加数字设置控制可以包含多少个推理块，从提示词末尾开始计数。 大多数模型提供商不建议在多轮对话中将 CoT 发送回模型。 继续推理 一种特殊情况是，在不启用“添加到提示”切换的情况下，可以将推理发送回模型，即继续生成（例如，通过按“继续”） 选项 菜单），但正在继续的消息仅包含推理而没有实际内容。这使得模型有机会完成不完整的推理并开始生成主要内容。 提示词将按如下方式发送： <think> Incomplete reasoning... 正则表达式脚本 正则表达式脚本来自 正则表达式扩展 可以应用于推理块的内容。检查脚本编辑器“影响”部分中的“推理”以专门针对推理块。 不同的短暂性选项通过以下方式影响推理块： 没有短暂性：推理内容会永久改变。 编辑时运行：编辑推理块时将重新评估正则表达式脚本。 更改聊天显示：正则表达式应用于推理块的显示文本，而不是底层内容。 更改传出提示词：正则表达式仅在推理块发送到模型之前应用于推理块。 推理努力 推理努力是聊天补全设置 AI响应配置 影响可能用于推理的 token 数量的面板。每个选项的效果取决于所连接的源。对于以下来源，“自动”仅表示请求中不包含相关参数。 选项 克劳德（如果没有流媒体，则≤ 21333） OpenAI（关键词） OpenRouter（关键字） xAI (Grok)（关键字） 困惑（关键词） NanoGPT（关键字） 型号 作品 4、十四行诗 4/3.7 o4-迷你、o3*、o1* 适用机型 grok-3-迷你 声纳深度研究 适用机型 汽车 未指定， 没有思考 未指定 未指定，效果取决于 未指定 未指定 未指定 最低 预算 1024 token “低” “低”，或最大响应的 20% “低” “低” “无” 低 最大响应的 15%，最小值 1024 “低” “低”，或最大响应的 20% “低” “低” “最小” 中等 最大响应的 25%，最小值 1024 “中” “中”，或最大响应的 50% “低” “中” “低” 高 最大响应的 50%，最小值 1024 “高” “高”，或最大响应的 80% “高” “高” “中” 最大 最大响应的 95%，最小值 1024 “高” “高”，或最大响应的 80% “高” “高” “高” 对于不支持自适应思维的旧版 Claude 模型，如果禁用流式传输，预算上限为 21333。如果计算出的预算小于 1024，则最大响应更改为 2048。 Claude 还支持 Opus 4.6+ 模型的自适应思维，可以通过以下方式启用 claude.enableAdaptiveThinking 在 配置.yaml （Opus 4.7+ 始终开启）。启用后，推理工作量设置会映射到自适应思维级别，而不是 token 预算。对于适用型号，此设置优先于“详细程度”设置。 对于 OpenRouter、Pollinations、Perplexity、xAI、Chutes、DeepSeek、AI/ML API、xAI、Electron Hub，只会发送 OpenAI 风格的关键字。 对于 OpenAI 上的 GPT-5.4 和 GPT-5.5 模型，“最小”推理工作对应于“无”，即禁用推理。 对于作为聊天补全自定义 API 源运行的 KoboldCpp，推理工作作为 reasoning_effort 参数值为“minimal”、“low”、“medium”、“high”和“xhigh”。 对于其他自定义（OpenAI 兼容）源，仅当模型在官方 OpenAI 源上支持时才会发送推理工作。 Google AI Studio 和 Vertex AI 如下： 型号 自动（动态思维） 最低 低 中等 高 最大 2.5专业版 思考预算=-1 128 最大响应的 15%，最小值 128 最大的 25% 最大的 50% 最大值或 32768 中的较低者 2.5 闪存 思考预算=-1 0, 没有思考 最大响应的 15% 最大的 25% 最大的 50% 最大值或 24576 中的较低者 2.5 闪存精简版 思考预算=-1 0, 没有思考 最大响应的 15%，最小值 512 最大的 25% 最大的 50% 最大值或 24576 中的较低者 3.0/3.1 专业版 思维水平=空 “低” “低” “低” “高” “高” 3.0/3.1闪存 思维水平=空 “最小” “低” “中” “高” “高” 对于 Gemini 2.5 Pro 和 2.5 Flash/Lite，无论流媒体设置如何，预算上限分别为 32768 或 24576 token。",
      "translationStatus": "machine-draft"
    },
    {
      "slug": "user-settings",
      "title": "用户设置",
      "group": "User_Settings",
      "order": 120,
      "source": "Usage/User_Settings/index.md",
      "sourceUrl": "https://docs.sillytavern.app/usage/user-settings/",
      "sourceSha256": "e0b91e081f422a7dcf00adc4efa70c28efa9bc90df6bda02a43c7398e6c61fc9",
      "headings": [
        {
          "id": "user-settings",
          "depth": 1,
          "title": "用户设置"
        },
        {
          "id": "general-settings",
          "depth": 2,
          "title": "常规设置"
        },
        {
          "id": "ui-language",
          "depth": 3,
          "title": "用户界面语言"
        },
        {
          "id": "software-version",
          "depth": 3,
          "title": "软件版本"
        },
        {
          "id": "account-management",
          "depth": 3,
          "title": "账户管理"
        },
        {
          "id": "i-classfa-fw-fa-solid-fa-user-shieldi-account",
          "depth": 4,
          "title": "<i class=\"fa-fw fa-solid fa-user-shield\"></i> 账户"
        },
        {
          "id": "i-classfa-fw-fa-solid-fa-user-tiei-admin-panel",
          "depth": 4,
          "title": "<i class=\"fa-fw fa-solid fa-user-tie\"></i> 管理面板"
        },
        {
          "id": "user-profile",
          "depth": 5,
          "title": "用户资料"
        },
        {
          "id": "account-controls",
          "depth": 5,
          "title": "账户控制"
        },
        {
          "id": "management-actions",
          "depth": 5,
          "title": "管理行动"
        },
        {
          "id": "new-user",
          "depth": 5,
          "title": "新用户"
        },
        {
          "id": "i-classfa-fw-fa-solid-fa-right-from-bracketi-logout",
          "depth": 4,
          "title": "<i class=\"fa-fw fa-solid fa-right-from-bracket\"></i> 退出"
        },
        {
          "id": "settings-search",
          "depth": 3,
          "title": "设置搜索"
        },
        {
          "id": "ui-theme",
          "depth": 2,
          "title": "用户界面主题"
        },
        {
          "id": "character-handling",
          "depth": 2,
          "title": "角色处理"
        },
        {
          "id": "miscellaneous",
          "depth": 2,
          "title": "杂项"
        },
        {
          "id": "chatmessage-handling",
          "depth": 2,
          "title": "聊天/消息处理"
        },
        {
          "id": "message-display-settings",
          "depth": 3,
          "title": "消息显示设置"
        },
        {
          "id": "input--response-controls",
          "depth": 3,
          "title": "输入和响应控制"
        },
        {
          "id": "auto-management",
          "depth": 3,
          "title": "自动管理"
        },
        {
          "id": "auto-swipe",
          "depth": 4,
          "title": "自动-滑动切换回复"
        },
        {
          "id": "auto-continue",
          "depth": 4,
          "title": "自动继续"
        },
        {
          "id": "message-formatting--display",
          "depth": 3,
          "title": "消息格式和显示"
        },
        {
          "id": "prompt-inspection-and-debugging",
          "depth": 3,
          "title": "提示词检查调试"
        },
        {
          "id": "autocomplete",
          "depth": 3,
          "title": "自动完成"
        },
        {
          "id": "stscript-settings",
          "depth": 2,
          "title": "ST脚本设置"
        },
        {
          "id": "strict_escaping",
          "depth": 3,
          "title": "严格_转义"
        },
        {
          "id": "replace_getvar",
          "depth": 3,
          "title": "REPLACE_GETVAR"
        },
        {
          "id": "clean-up-menu",
          "depth": 2,
          "title": "清理菜单"
        },
        {
          "id": "how-to-use-clean-up",
          "depth": 3,
          "title": "如何使用清理功能"
        },
        {
          "id": "clean-up-categories",
          "depth": 3,
          "title": "清理类别"
        },
        {
          "id": "files",
          "depth": 4,
          "title": "文件"
        },
        {
          "id": "images",
          "depth": 4,
          "title": "图片"
        },
        {
          "id": "chats",
          "depth": 4,
          "title": "聊天记录"
        },
        {
          "id": "group-chats",
          "depth": 4,
          "title": "群聊"
        },
        {
          "id": "avatar-thumbnails",
          "depth": 4,
          "title": "头像缩略图"
        },
        {
          "id": "background-thumbnails",
          "depth": 4,
          "title": "背景缩略图"
        },
        {
          "id": "chat-backups",
          "depth": 4,
          "title": "聊天备份"
        },
        {
          "id": "settings-backups",
          "depth": 4,
          "title": "设置备份"
        },
        {
          "id": "debug-menu",
          "depth": 2,
          "title": "调试菜单"
        },
        {
          "id": "translation--locale-functions",
          "depth": 3,
          "title": "翻译和区域设置功能"
        },
        {
          "id": "cache--storage-management",
          "depth": 3,
          "title": "缓存和存储管理"
        },
        {
          "id": "data--statistics",
          "depth": 3,
          "title": "数据与统计"
        },
        {
          "id": "api--extension-testing",
          "depth": 3,
          "title": "API 和扩展测试"
        },
        {
          "id": "system--debug-tools",
          "depth": 3,
          "title": "系统和调试工具"
        }
      ],
      "content": "# 用户设置\n\n> **[用户界面定制](/guides/sillytavern/core-concepts/uicustomization/)**\n>\n> 更改聊天界面的主题、外观和风格以满足您的喜好。\n\n> **[视觉小说模式](/guides/sillytavern/user-settings/visual-novel/)**\n>\n> 使用精灵与角色聊天，就像在 Doki Doki 文学俱乐部和其他著名 VN 游戏等视觉小说中一样。\n\n## 常规设置\n\n这些是影响您整体 SillyTavern 体验的核心设置。\n\n### 用户界面语言\n\nSillyTavern的用户界面有多种语言版本。语言选择器提供以下选项：\n\n- **默认**：使用您的系统语言（如果可用）\n- **英语**：无论系统设置如何，都强制使用英语 UI\n- 通过下拉菜单可以选择其他语言\n\n注意：此设置仅影响用户界面文本。对于人工智能对话翻译，请使用 [聊天翻译](https://docs.sillytavern.app/extensions/translation/) 扩展。\n\n### 软件版本\n\n您当前的 SillyTavern 版本显示在右上角。此信息对于以下方面至关重要：\n\n- 故障排除\n- 确保与扩展的兼容性\n- 确定更新是否可用\n\n更新SillyTavern到最新版本，请参考 [更新中](https://docs.sillytavern.app/Installation/Updating) 文档。\n\n### 账户管理\n\n控制您的 SillyTavern 用户帐户，备份您的设置和用户数据，并管理用户角色和权限 [多用户模式](https://docs.sillytavern.app/administration/multi-user/).\n\n#### <i class=\"fa-fw fa-solid fa-user-shield\"></i> 账户\n\n在“帐户”对话框中，您可以查看和编辑您的个人资料信息、更改密码以及管理帐户设置。\n\n**简介信息**\n\n- 显示名称（可通过铅笔图标编辑）\n- 用户头像（也可以使用更改 [用户人设](/guides/sillytavern/core-concepts/personas/))\n- 账户手柄\n- 用户角色\n- 帐户创建日期\n- 密码状态（锁定/解锁图标表示保护）\n\n**账户操作**\n\n- **设置快照**：创建、管理和恢复用户设置的备份\n- **下载备份**：导出所有用户数据的完整备份\n- **更改密码**：更新您的帐户安全凭证\n\n**危险区**\n\n应谨慎使用的关键帐户操作：\n\n- **重置设置**：将所有设置恢复为出厂默认值\n- **重置一切**：完成帐户擦除并恢复出厂设置\n\n#### <i class=\"fa-fw fa-solid fa-user-tie\"></i> 管理面板\n\n> **适用于： [多用户模式](https://docs.sillytavern.app/administration/multi-user/)**\n>\n> 多账户功能需要 `enableUserAccounts` 在 config.yaml 中设置为 true。\n\n选择 **管理用户** 查看和管理现有用户帐户。\n\n##### 用户资料\n\n- 自定义头像管理（上传/删除）\n- 显示名称和句柄\n- 角色和状态信息\n- 帐户创建日期\n- 密码保护状态\n\n##### 账户控制\n\n- <i class=\"fa-fw fa-solid fa-pencil\"></i> 编辑显示名称\n- <i class=\"fa-fw fa-solid fa-check\"></i> 启用帐户\n- <i class=\"fa-fw fa-solid fa-ban\"></i> 禁用帐户\n- <i class=\"fa-fw fa-solid fa-arrow-up\"></i> 晋升为管理员\n- <i class=\"fa-fw fa-solid fa-arrow-down\"></i> 降级为普通用户\n\n##### 管理行动\n\n- <i class=\"fa-fw fa-solid fa-download\"></i> 下载用户数据备份\n- <i class=\"fa-fw fa-solid fa-key\"></i> 更改用户密码\n- <i class=\"fa-fw fa-solid fa-trash\"></i> 删除帐户\n\n##### 新用户\n\n选择 **新用户** 创建一个新的用户帐户。\n\n- 显示名称\\*（例如“John Snow”）\n- 用户句柄\\*（仅限小写字母、数字和破折号）\n- 密码（可选）\n- 密码确认\n\n创建新用户会自动在 /data/ 目录中生成一个子文件夹，使用用户的句柄作为文件夹名称。\n\n#### <i class=\"fa-fw fa-solid fa-right-from-bracket\"></i> 退出\n\n> **适用于： [多用户模式](https://docs.sillytavern.app/administration/multi-user/)**\n\n退出当前会话。\n\n### 设置搜索\n\n方便的搜索栏可帮助您快速找到特定设置：\n\n- 在“用户设置”中的任意位置键入任意关键字来过滤和突出显示设置\n- 搜索设置名称和描述\n- 帮助更有效地导航复杂的设置\n\n## 用户界面主题\n\n更改聊天界面的外观以满足您的喜好。\n\n有关此部分中的设置的更多信息 <i class=\"fa-fw fa-solid fa-user-gear\" title=\"User Settings icon\"></i> **用户设置**，参见 [用户界面定制](/guides/sillytavern/core-concepts/uicustomization/#ui-theme).\n\n## 角色处理\n\n- **字符列表副标题**：选择在角色名称下显示哪些附加信息 [<i class=\"fa-fw fa-solid fa-address-card\" title=\"Characters icon\"></i> 角色](/guides/sillytavern/core-concepts/characterdesign/) 清单：\n  - 角色版本\n  - 创建者：\n- **导入卡标签**：控制导入角色卡时如何处理标签：\n  - 询问 - 显示每次导入的对话框\n  - None - 不导入任何标签\n  - 全部 - 导入所有标签\n  - 现有 - 仅导入已存在的标签\n- **高级角色搜索**：启用后，使用模糊匹配并搜索所有角色数据字段，而不仅仅是名称。\n- **更喜欢查尔。 提示词**：如果启用，则使用角色卡的系统提示词覆盖（如果可用）。\n- **更喜欢查尔。指示**：如果启用，则使用角色卡的历史记录指令覆盖（如果可用）。\n- **切勿调整头像大小**：防止裁剪/调整导入的角色图像的大小。禁用后，图像大小将调整为 512x768。\n- **显示头像文件名**：显示角色列表中角色头像的实际文件名。\n- **无剧透模式**：将角色定义隐藏在编辑器面板中的扰流按钮后面。\n\n## 杂项\n\n- **重新加载聊天**：重新加载并重画当前聊天。\n- **[调试菜单](#debug-menu)**：访问调试选项。\n- **流畅的串流**：通过逐字母显示文本来平滑流式生成。包括速度控制滑块。要从平滑流中排除推理块，请启用“排除‘思考...’”选项。\n- **流淡入**：对流文本应用淡入效果。可以在有或没有平滑流的情况下使用。\n- **[留言声音](/guides/sillytavern/core-concepts/uicustomization/#message-sound)**：消息生成完成时播放声音。\n  - **仅背景声音**：仅在浏览器选项卡未聚焦时播放声音。\n- **宽松的 API URL**：减少 API URL 的格式要求。\n- **世界书导入对话框**：导入带有嵌入知识的角色时，显示世界书/世界书的导入对话框。\n- **自动选择输入文本**：单击时自动选择某些输入字段中的文本。\n- **Markdown 热键**：启用 Markdown 格式的键盘快捷键。\n- **恢复用户输入**：刷新页面时保留未保存的用户输入。\n- **移动用户界面**：允许通过拖动重新定位 UI 元素（仅限 PC）。\n  - <i class=\"fa-solid fa-recycle\" title=\"Reset icon\"></i> **重置** 按钮恢复默认位置\n  - 用于保存/加载 UI 布局的预设系统\n\n## 聊天/消息处理\n\n### 消息显示设置\n\n控制消息在聊天界面中的加载和显示方式。这些设置会影响整体聊天体验和性能。\n\n- **# 要加载的消息**：分页前加载的聊天历史消息数（0 = 全部）\n- **流媒体 FPS**：流文本的更新速度（5-100 FPS）\n- **示例消息行为**:\n  - 逐渐推出\n  - 始终包含示例\n  - 切勿包含示例\n- **图像滑动行为** （控制画廊风格图像的滑动切换回复操作）：\n  - 生成新的：允许生成新图像 [图像生成](https://docs.sillytavern.app/extensions/stable-diffusion/) 延伸\n  - 翻转：循环浏览现有图像，在末端环绕\n\n### 输入和响应控制\n\n确定如何发送消息以及 AI 如何继续响应的设置。\n\n- **输入发送**：选择“禁用”、“自动”(PC) 或“启用”\n- **“发送”继续**：使用“发送”按钮继续 AI 回复\n- **快速“继续”按钮**：显示延长AI最后一条消息的按钮\n- **快速“模拟”按钮**：显示单消息角色模拟按钮\n- **滑动切换回复**：显示替代 AI 响应的箭头按钮（PC 和移动设备）\n- **手势**：启用滑动切换回复手势生成（仅限移动设备）\n\n### 自动管理\n\n帮助管理聊天流程和内容的自动化功能。\n\n- **自动加载上次聊天记录**：启动时自动加载最近的聊天记录\n- **自动滚动聊天**：自动滚动到最新消息\n- **自动保存消息编辑**：保存消息编辑内容而不确认\n- **确认消息删除**：删除消息前的提示词\n- **自动修复 Markdown**：自动纠正 Markdown 格式\n\n#### 自动-滑动切换回复\n\n根据可配置的标准自动拒绝并重新生成 AI 消息。\n\n- **启用自动-滑动切换回复**：自动滑动切换回复功能的主开关\n- **最小生成消息长度**：如果消息短于此值，则触发自动滑动切换回复\n- **列入黑名单的单词**：可以触发auto-滑动切换回复的单词列表，以逗号分隔\n- **黑名单字数为滑动切换回复**：必须检测到触发自动滑动切换回复的黑名单单词的最小数量\n\n#### 自动继续\n\n如果模型在达到一定长度之前停止，则自动继续响应。\n\n这可以让你的人工智能在多个部分中写出一个长的响应，这样你就可以得到一个简短的响应 [响应长度设置](/guides/sillytavern/common-settings/#response-tokens) 同时仍然收到很长的回复。\n\n它不会让人工智能写出比其他情况更多的内容。要求人工智能继续一条它认为“已完成”的消息通常是行不通的。参见 [如何让AI写得更多？](/guides/sillytavern/faq/#how-to-make-the-ai-write-more) 以获得其他想法。\n\n- **启用自动继续**：自动继续的主切换\n- **允许聊天补全 API**：为聊天补全 API 端点启用自动继续功能\n- **目标长度（token）**：token 中所需的消息长度 - 如果消息短于该值（0-1024），将触发继续\n\n### 消息格式和显示\n\n控制消息的格式以及显示的内容。\n\n- **禁止外部媒体**：阻止来自外部域的嵌入媒体\n- **显示 {{char}}：在回复中**：如果生成，则在响应中保留角色名称前缀\n- **显示 {{user}}：在回复中**：如果生成，则在响应中保留用户名前缀\n- **实验宏引擎**：启用支持嵌套的高级宏处理\n- **在回复中显示标签**：允许响应中的（某些）HTML 标签显示为 HTML\n- **放松群组消息修剪**：允许AI在群聊中为其他角色发言，而不是停止生成响应\n- **显示群聊队列**：显示群聊角色列表中的回复顺序\n- **Pin 问候语消息样式**：始终渲染问候语中的样式标签，即使消息由于延迟加载而被卸载。\n\n### 提示词检查调试\n\n- **将提示词记录到控制台**：输出提示词到浏览器控制台\n- **请求 token 概率**：从 API 请求 AI 响应的 token 概率。如果有的话，可以在以下位置查看这些内容： <i class=\"fa-solid fa-bars\" title=\"Burger Menu icon\"></i> [代币概率](/guides/sillytavern/chatting/#token-probabilities-panel).\n\n### 自动完成\n\n- 自动隐藏详细信息\n- 匹配样式（开头为/包含/模糊）\n- 视觉风格（主题/深色/浅色）\n- 键盘选择选项\n- 字体缩放\n- 宽度控制\n\n## ST脚本设置\n\n配置选项 [ST脚本解析器](https://docs.sillytavern.app/usage/st-script/#parser-flags).\n\n### 严格_转义\n\n- 管道不需要在带引号的值中转义。\n- 符号前面的反斜杠可以转义，以提供后跟功能符号的文字反斜杠。\n\n参见 [严格逃脱](https://docs.sillytavern.app/usage/st-script/#strict-escaping) 了解更多信息。\n\n### REPLACE_GETVAR\n\n当变量值包含可解释为宏的文本时，有助于避免双重替换。\n\n参见 [替换变量宏](https://docs.sillytavern.app/usage/st-script/#replace-variable-macros) 了解更多信息。\n\n## 清理菜单\n\n清理菜单提供了一个数据维护工具，可帮助您识别并删除 SillyTavern 安装中不必要的文件。此功能有助于保持数据目录井井有条，并可以释放大量磁盘空间。\n\n> **警告“重要警告”**\n>\n> 清理工具将永久删除文件。 **此操作无法撤消！**\n>\n> 手动上传到 `/data/user/files/` 和 `/data/user/images/` 如果目录不与聊天消息或资料库条目关联，则目录将被删除。\n>\n> 如果不确定，请在使用“清理”菜单之前备份数据。\n\n### 如何使用清理功能\n\n1. 单击 **清理** 按钮下的 **杂项** 部分\n2. 点击 **扫描** 分析您的安装。这可能需要一些时间，具体取决于数据目录的大小\n3. 查看找到的文件类别\n4. 使用 **查看** 删除前预览文件内容\n5. 使用 **下载** 删除前保存文件\n6. 根据需要删除单个文件或整个类别\n\n### 清理类别\n\n清理工具将松散文件扫描为以下类别：\n\n#### 文件\n\n- **它发现了什么**：与聊天消息或资料库条目无关的文件\n- **地点**: `/data/<user-handle>/user/files/`\n- **风险**: ⚠️ **将删除手动上传** 聊天中未提及的内容\n- **何时清洁**：如果不需要未引用的文件，可以安全删除\n\n#### 图片\n\n- **它发现了什么**：与聊天消息无关的图像\n- **地点**: `/data/<user-handle>/user/images/`\n- **风险**: ⚠️ **将删除手动上传** 聊天中未提及的内容\n- **何时清洁**：如果您不需要未引用的图像，可以安全删除\n\n#### 聊天记录\n\n- **它发现了什么**：与已删除的角色关联的聊天文件\n- **地点**: `data/<user-handle>/chats/`\n- **风险**: ⚠️ **孤立的聊天将永久丢失**\n- **何时清洁**：如果您故意删除了角色并且不再需要他们的聊天记录，则可以安全删除\n\n#### 群聊\n\n- **它发现了什么**：与已删除群组关联的聊天文件\n- **地点**: `data/<user-handle>/group chats/`\n- **风险**: ⚠️ **孤立的群聊将永久丢失**\n- **何时清洁**：如果您有意删除群组并且不再需要他们的聊天记录，则可以安全删除\n\n#### 头像缩略图\n\n- **它发现了什么**：缺失或删除的角色头像缩略图\n- **地点**: `data/<user-handle>/thumbnails/avatar`\n- **风险**: ✅ **可以安全删除** - 需要时自动重新生成缩略图\n- **何时清洁**：始终安全清洁，有助于释放空间\n\n#### 背景缩略图\n\n- **它发现了什么**：丢失或删除背景的缩略图\n- **地点**: `data/<user-handle>/thumbnails/bg`\n- **风险**: ✅ **可以安全删除** - 需要时自动重新生成缩略图\n- **何时清洁**：始终安全清洁，有助于释放空间\n\n#### 聊天备份\n\n- **它发现了什么**：自动生成聊天备份\n- **地点**: `data/<user-handle>/backups/chat_*`\n- **风险**: ⚠️ **备份文件将永久丢失**\n- **何时清洁**：考虑保留最近的备份，但可以安全删除较旧的备份\n\n#### 设置备份\n\n- **它发现了什么**：自动生成设置备份\n- **地点**: `data/<user-handle>/backups/settings_*`\n- **风险**: ⚠️ **设置备份文件将永久丢失**\n- **何时清洁**：考虑保留最近的备份，但可以安全删除较旧的备份\n\n## 调试菜单\n\n> **这些功能仅供高级用户使用。**\n>\n> 除非您完全了解其后果，否则请勿使用它们。\n\n调试菜单提供用于故障排除、维护和开发目的的功能。应谨慎使用这些函数，因为它们会显着影响您的 SillyTavern 安装。\n\n由于扩展可以添加调试功能，因此可用选项将根据您安装的扩展而有所不同。\n\n### 翻译和区域设置功能\n\n- **获取缺失的翻译**：分析当前语言环境（如果选择英语，则分析所有语言环境）是否缺少翻译并将结果输出到浏览器控制台\n- **应用区域设置**：通过重新应用所选区域设置强制刷新当前语言设置\n\n### 缓存和存储管理\n\n- **清除网络搜索缓存**：从本地缓存中删除所有存储的搜索结果\n- **清除所有向量索引**：完全删除所有源中所有存储的向量\n- **重置token缓存**：清除存储的 token 计数，强制所有聊天完全重新标记\n- **删除逐项提示词**：从本地存储中删除所有逐项提示词\n\n### 数据与统计\n\n- **刷新统计文件**：使用现有聊天数据重建统计文件\n- **回填 token 柜台**：重新计算当前聊天中所有消息的 token 计数\n  - 在具有不同分词器的模型之间切换时很有用\n  - 完成后触发聊天重新加载\n  - 仅视觉变化，不修改聊天内容\n\n### API 和扩展测试\n\n- **更改 Mancer 基本 URL**：修改 Mancer API 服务器的基本 URL\n- **测试 WebSearch 扩展**：使用当前设置执行测试搜索\n- **发送生成请求**：使用当前选择的 API 测试文本生成\n\n### 系统和调试工具\n\n- **强制入职**：重新启动入职流程\n- **切换事件跟踪**：启用/禁用事件跟踪以进行调试\n- **复制 ST 设置**：\\[正在进行中]将系统配置数据复制到剪贴板以进行错误报告\n\n每个功能都可以使用其描述下方的“执行”按钮来执行。请考虑在使用这些工具之前备份数据，因为某些操作无法撤消。\n",
      "searchText": "用户设置 用户界面定制 更改聊天界面的主题、外观和风格以满足您的喜好。 视觉小说模式 使用精灵与角色聊天，就像在 Doki Doki 文学俱乐部和其他著名 VN 游戏等视觉小说中一样。 常规设置 这些是影响您整体 SillyTavern 体验的核心设置。 用户界面语言 SillyTavern的用户界面有多种语言版本。语言选择器提供以下选项： 默认：使用您的系统语言（如果可用） 英语：无论系统设置如何，都强制使用英语 UI 通过下拉菜单可以选择其他语言 注意：此设置仅影响用户界面文本。对于人工智能对话翻译，请使用 聊天翻译 扩展。 软件版本 您当前的 SillyTavern 版本显示在右上角。此信息对于以下方面至关重要： 故障排除 确保与扩展的兼容性 确定更新是否可用 更新SillyTavern到最新版本，请参考 更新中 文档。 账户管理 控制您的 SillyTavern 用户帐户，备份您的设置和用户数据，并管理用户角色和权限 多用户模式. 账户 在“帐户”对话框中，您可以查看和编辑您的个人资料信息、更改密码以及管理帐户设置。 简介信息 显示名称（可通过铅笔图标编辑） 用户头像（也可以使用更改 用户人设) 账户手柄 用户角色 帐户创建日期 密码状态（锁定/解锁图标表示保护） 账户操作 设置快照：创建、管理和恢复用户设置的备份 下载备份：导出所有用户数据的完整备份 更改密码：更新您的帐户安全凭证 危险区 应谨慎使用的关键帐户操作： 重置设置：将所有设置恢复为出厂默认值 重置一切：完成帐户擦除并恢复出厂设置 管理面板 适用于： 多用户模式 多账户功能需要 enableUserAccounts 在 config.yaml 中设置为 true。 选择 管理用户 查看和管理现有用户帐户。 用户资料 自定义头像管理（上传/删除） 显示名称和句柄 角色和状态信息 帐户创建日期 密码保护状态 账户控制 编辑显示名称 启用帐户 禁用帐户 晋升为管理员 降级为普通用户 管理行动 下载用户数据备份 更改用户密码 删除帐户 新用户 选择 新用户 创建一个新的用户帐户。 显示名称*（例如“John Snow”） 用户句柄*（仅限小写字母、数字和破折号） 密码（可选） 密码确认 创建新用户会自动在 /data/ 目录中生成一个子文件夹，使用用户的句柄作为文件夹名称。 退出 适用于： 多用户模式 退出当前会话。 设置搜索 方便的搜索栏可帮助您快速找到特定设置： 在“用户设置”中的任意位置键入任意关键字来过滤和突出显示设置 搜索设置名称和描述 帮助更有效地导航复杂的设置 用户界面主题 更改聊天界面的外观以满足您的喜好。 有关此部分中的设置的更多信息 用户设置，参见 用户界面定制. 角色处理 字符列表副标题：选择在角色名称下显示哪些附加信息 角色 清单： 角色版本 创建者： 导入卡标签：控制导入角色卡时如何处理标签： 询问 - 显示每次导入的对话框 None - 不导入任何标签 全部 - 导入所有标签 现有 - 仅导入已存在的标签 高级角色搜索：启用后，使用模糊匹配并搜索所有角色数据字段，而不仅仅是名称。 更喜欢查尔。 提示词：如果启用，则使用角色卡的系统提示词覆盖（如果可用）。 更喜欢查尔。指示：如果启用，则使用角色卡的历史记录指令覆盖（如果可用）。 切勿调整头像大小：防止裁剪/调整导入的角色图像的大小。禁用后，图像大小将调整为 512x768。 显示头像文件名：显示角色列表中角色头像的实际文件名。 无剧透模式：将角色定义隐藏在编辑器面板中的扰流按钮后面。 杂项 重新加载聊天：重新加载并重画当前聊天。 调试菜单：访问调试选项。 流畅的串流：通过逐字母显示文本来平滑流式生成。包括速度控制滑块。要从平滑流中排除推理块，请启用“排除‘思考...’”选项。 流淡入：对流文本应用淡入效果。可以在有或没有平滑流的情况下使用。 留言声音：消息生成完成时播放声音。 仅背景声音：仅在浏览器选项卡未聚焦时播放声音。 宽松的 API URL：减少 API URL 的格式要求。 世界书导入对话框：导入带有嵌入知识的角色时，显示世界书/世界书的导入对话框。 自动选择输入文本：单击时自动选择某些输入字段中的文本。 Markdown 热键：启用 Markdown 格式的键盘快捷键。 恢复用户输入：刷新页面时保留未保存的用户输入。 移动用户界面：允许通过拖动重新定位 UI 元素（仅限 PC）。 重置 按钮恢复默认位置 用于保存/加载 UI 布局的预设系统 聊天/消息处理 消息显示设置 控制消息在聊天界面中的加载和显示方式。这些设置会影响整体聊天体验和性能。 # 要加载的消息：分页前加载的聊天历史消息数（0 = 全部） 流媒体 FPS：流文本的更新速度（5-100 FPS） 示例消息行为: 逐渐推出 始终包含示例 切勿包含示例 图像滑动行为 （控制画廊风格图像的滑动切换回复操作）： 生成新的：允许生成新图像 图像生成 延伸 翻转：循环浏览现有图像，在末端环绕 输入和响应控制 确定如何发送消息以及 AI 如何继续响应的设置。 输入发送：选择“禁用”、“自动”(PC) 或“启用” “发送”继续：使用“发送”按钮继续 AI 回复 快速“继续”按钮：显示延长AI最后一条消息的按钮 快速“模拟”按钮：显示单消息角色模拟按钮 滑动切换回复：显示替代 AI 响应的箭头按钮（PC 和移动设备） 手势：启用滑动切换回复手势生成（仅限移动设备） 自动管理 帮助管理聊天流程和内容的自动化功能。 自动加载上次聊天记录：启动时自动加载最近的聊天记录 自动滚动聊天：自动滚动到最新消息 自动保存消息编辑：保存消息编辑内容而不确认 确认消息删除：删除消息前的提示词 自动修复 Markdown：自动纠正 Markdown 格式 自动-滑动切换回复 根据可配置的标准自动拒绝并重新生成 AI 消息。 启用自动-滑动切换回复：自动滑动切换回复功能的主开关 最小生成消息长度：如果消息短于此值，则触发自动滑动切换回复 列入黑名单的单词：可以触发auto-滑动切换回复的单词列表，以逗号分隔 黑名单字数为滑动切换回复：必须检测到触发自动滑动切换回复的黑名单单词的最小数量 自动继续 如果模型在达到一定长度之前停止，则自动继续响应。 这可以让你的人工智能在多个部分中写出一个长的响应，这样你就可以得到一个简短的响应 响应长度设置 同时仍然收到很长的回复。 它不会让人工智能写出比其他情况更多的内容。要求人工智能继续一条它认为“已完成”的消息通常是行不通的。参见 如何让AI写得更多？ 以获得其他想法。 启用自动继续：自动继续的主切换 允许聊天补全 API：为聊天补全 API 端点启用自动继续功能 目标长度（token）：token 中所需的消息长度 - 如果消息短于该值（0-1024），将触发继续 消息格式和显示 控制消息的格式以及显示的内容。 禁止外部媒体：阻止来自外部域的嵌入媒体 显示 {{char}}：在回复中：如果生成，则在响应中保留角色名称前缀 显示 {{user}}：在回复中：如果生成，则在响应中保留用户名前缀 实验宏引擎：启用支持嵌套的高级宏处理 在回复中显示标签：允许响应中的（某些）HTML 标签显示为 HTML 放松群组消息修剪：允许AI在群聊中为其他角色发言，而不是停止生成响应 显示群聊队列：显示群聊角色列表中的回复顺序 Pin 问候语消息样式：始终渲染问候语中的样式标签，即使消息由于延迟加载而被卸载。 提示词检查调试 将提示词记录到控制台：输出提示词到浏览器控制台 请求 token 概率：从 API 请求 AI 响应的 token 概率。如果有的话，可以在以下位置查看这些内容： 代币概率. 自动完成 自动隐藏详细信息 匹配样式（开头为/包含/模糊） 视觉风格（主题/深色/浅色） 键盘选择选项 字体缩放 宽度控制 ST脚本设置 配置选项 ST脚本解析器. 严格_转义 管道不需要在带引号的值中转义。 符号前面的反斜杠可以转义，以提供后跟功能符号的文字反斜杠。 参见 严格逃脱 了解更多信息。 REPLACE_GETVAR 当变量值包含可解释为宏的文本时，有助于避免双重替换。 参见 替换变量宏 了解更多信息。 清理菜单 清理菜单提供了一个数据维护工具，可帮助您识别并删除 SillyTavern 安装中不必要的文件。此功能有助于保持数据目录井井有条，并可以释放大量磁盘空间。 警告“重要警告” 清理工具将永久删除文件。 此操作无法撤消！ 手动上传到 /data/user/files/ 和 /data/user/images/ 如果目录不与聊天消息或资料库条目关联，则目录将被删除。 如果不确定，请在使用“清理”菜单之前备份数据。 如何使用清理功能 单击 清理 按钮下的 杂项 部分 点击 扫描 分析您的安装。这可能需要一些时间，具体取决于数据目录的大小 查看找到的文件类别 使用 查看 删除前预览文件内容 使用 下载 删除前保存文件 根据需要删除单个文件或整个类别 清理类别 清理工具将松散文件扫描为以下类别： 文件 它发现了什么：与聊天消息或资料库条目无关的文件 地点: /data/<user-handle>/user/files/ 风险: ⚠️ 将删除手动上传 聊天中未提及的内容 何时清洁：如果不需要未引用的文件，可以安全删除 图片 它发现了什么：与聊天消息无关的图像 地点: /data/<user-handle>/user/images/ 风险: ⚠️ 将删除手动上传 聊天中未提及的内容 何时清洁：如果您不需要未引用的图像，可以安全删除 聊天记录 它发现了什么：与已删除的角色关联的聊天文件 地点: data/<user-handle>/chats/ 风险: ⚠️ 孤立的聊天将永久丢失 何时清洁：如果您故意删除了角色并且不再需要他们的聊天记录，则可以安全删除 群聊 它发现了什么：与已删除群组关联的聊天文件 地点: data/<user-handle>/group chats/ 风险: ⚠️ 孤立的群聊将永久丢失 何时清洁：如果您有意删除群组并且不再需要他们的聊天记录，则可以安全删除 头像缩略图 它发现了什么：缺失或删除的角色头像缩略图 地点: data/<user-handle>/thumbnails/avatar 风险: ✅ 可以安全删除 - 需要时自动重新生成缩略图 何时清洁：始终安全清洁，有助于释放空间 背景缩略图 它发现了什么：丢失或删除背景的缩略图 地点: data/<user-handle>/thumbnails/bg 风险: ✅ 可以安全删除 - 需要时自动重新生成缩略图 何时清洁：始终安全清洁，有助于释放空间 聊天备份 它发现了什么：自动生成聊天备份 地点: data/<user-handle>/backups/chat_* 风险: ⚠️ 备份文件将永久丢失 何时清洁：考虑保留最近的备份，但可以安全删除较旧的备份 设置备份 它发现了什么：自动生成设置备份 地点: data/<user-handle>/backups/settings_* 风险: ⚠️ 设置备份文件将永久丢失 何时清洁：考虑保留最近的备份，但可以安全删除较旧的备份 调试菜单 这些功能仅供高级用户使用。 除非您完全了解其后果，否则请勿使用它们。 调试菜单提供用于故障排除、维护和开发目的的功能。应谨慎使用这些函数，因为它们会显着影响您的 SillyTavern 安装。 由于扩展可以添加调试功能，因此可用选项将根据您安装的扩展而有所不同。 翻译和区域设置功能 获取缺失的翻译：分析当前语言环境（如果选择英语，则分析所有语言环境）是否缺少翻译并将结果输出到浏览器控制台 应用区域设置：通过重新应用所选区域设置强制刷新当前语言设置 缓存和存储管理 清除网络搜索缓存：从本地缓存中删除所有存储的搜索结果 清除所有向量索引：完全删除所有源中所有存储的向量 重置token缓存：清除存储的 token 计数，强制所有聊天完全重新标记 删除逐项提示词：从本地存储中删除所有逐项提示词 数据与统计 刷新统计文件：使用现有聊天数据重建统计文件 回填 token 柜台：重新计算当前聊天中所有消息的 token 计数 在具有不同分词器的模型之间切换时很有用 完成后触发聊天重新加载 仅视觉变化，不修改聊天内容 API 和扩展测试 更改 Mancer 基本 URL：修改 Mancer API 服务器的基本 URL 测试 WebSearch 扩展：使用当前设置执行测试搜索 发送生成请求：使用当前选择的 API 测试文本生成 系统和调试工具 强制入职：重新启动入职流程 切换事件跟踪：启用/禁用事件跟踪以进行调试 复制 ST 设置：[正在进行中]将系统配置数据复制到剪贴板以进行错误报告 每个功能都可以使用其描述下方的“执行”按钮来执行。请考虑在使用这些工具之前备份数据，因为某些操作无法撤消。",
      "translationStatus": "machine-draft"
    },
    {
      "slug": "core-concepts/uicustomization",
      "title": "界面自定义",
      "group": "User_Settings",
      "order": 20,
      "source": "Usage/User_Settings/uicustomization.md",
      "sourceUrl": "https://docs.sillytavern.app/usage/core-concepts/uicustomization/",
      "sourceSha256": "4a07bb479f94d352aa929b128bf2dcb29d280fceabbfd0fc90d36f9e8df36be1",
      "headings": [
        {
          "id": "ui-customization",
          "depth": 1,
          "title": "界面自定义"
        },
        {
          "id": "ui-theme",
          "depth": 2,
          "title": "用户界面主题"
        },
        {
          "id": "theme-management",
          "depth": 3,
          "title": "主题管理"
        },
        {
          "id": "display-settings",
          "depth": 3,
          "title": "显示设置"
        },
        {
          "id": "avatar-style",
          "depth": 4,
          "title": "头像风格"
        },
        {
          "id": "chat-style",
          "depth": 4,
          "title": "聊天风格"
        },
        {
          "id": "notifications",
          "depth": 3,
          "title": "通知"
        },
        {
          "id": "media-style",
          "depth": 3,
          "title": "媒体风格"
        },
        {
          "id": "theme-colors",
          "depth": 3,
          "title": "主题颜色"
        },
        {
          "id": "layout--visual-settings",
          "depth": 3,
          "title": "布局和视觉设置"
        },
        {
          "id": "theme-toggles",
          "depth": 3,
          "title": "主题切换"
        },
        {
          "id": "custom-css",
          "depth": 3,
          "title": "自定义CSS"
        },
        {
          "id": "message-sound",
          "depth": 2,
          "title": "留言声音"
        },
        {
          "id": "formulas-rendering",
          "depth": 2,
          "title": "公式渲染"
        }
      ],
      "content": "# 界面自定义\n\n## 用户界面主题\n\n### 主题管理\n\n主题文件允许您保存、共享和重用您的 UI 自定义设置。您可以根据不同的心情或目的维护多个主题，并立即在它们之间切换。\n\n- 导入/导出主题文件\n- 删除现有主题\n- 保存对当前主题的更改\n- 另存为新主题\n\n此部分中的所有设置都保存到当前主题。如果切换主题，这些设置将被新主题的设置替换。\n\n### 显示设置\n\n这些显示选项会影响角色和消息在聊天界面中的呈现方式。\n\n#### 头像风格\n\n在圆形、方形、矩形或圆角方形之间进行选择。此设置适用于用户和 AI 头像。\n\n#### 聊天风格\n\n| 风格     | 描述                                           | [斜线命令](https://docs.sillytavern.app/usage/st-script/#ui-styling) |\n| ------ | -------------------------------------------- | ---------------------------------------------------------------- |\n| **平**  | 干净、连续的“聊天日志”风格，一个让你的人工智能交互变得栩栩如生的平面画布。       | `/flat`<br>`/default`                                            |\n| **气泡** | “即时通讯”风格，每条消息都有明显的气泡、令人愉悦的圆角和微妙的 3D 效果。      | `/bubble`<br>`/bubbles`                                          |\n| **文件** | 紧凑、类似文档的外观，具有以文本为中心的布局。隐藏过去消息的头像、时间戳和消息控制按钮。 | `/single`<br>`/story`                                            |\n\n### 通知\n\n设置通知弹出窗口（Toast 消息）在屏幕上出现的位置。\n\n- 左上\n- 顶部居中（默认）\n- 右上\n- 左下角\n- 底部中心\n- 右下角\n\n### 媒体风格\n\n聊天消息中媒体附件（图像、音频、视频）的默认显示样式。将媒体附加到聊天消息的扩展程序可能会覆盖此设置。还可以使用消息上下文菜单中的“切换媒体显示样式”操作手动更改每条消息。\n\n- **列表**：以网格状布局一次性显示所有媒体附件。\n- **画廊**：在轮播式图库中显示媒体附件。\n\n> 此设置还会影响内联媒体附件发送到支持的聊天补全源的方式：列表一次发送所有附件，而图库发送选定的附件。\n\n### 主题颜色\n\n自定义每个 UI 元素的配色方案以创建您的完美主题。可以使用颜色选择器选择颜色，并在适用的情况下包括透明度选项。\n\n- 正文\n- 斜体文本\n- 带下划线的文本\n- 引用文字\n- 文字阴影\n- 聊天背景\n- 用户界面背景\n- 用户界面边框\n- 用户留言\n- 人工智能留言\n\n### 布局和视觉设置\n\n使用这些滑块微调界面的视觉呈现。\n\n- **聊天宽度**：调整聊天窗口宽度（屏幕的25-100%）\n- **字体比例**：自定义文字大小（0.5-1.5x）\n- **模糊强度**：控制 UI 面板模糊（0-30）\n- **阴影宽度**：调整文本阴影强度（0-5）\n\n### 主题切换\n\n这些开关控制各种 UI 功能和行为。有些选项可以提高低端设备的性能，而其他选项则可以向聊天界面添加有用的信息或功能。\n\n- **减少运动**：禁用动画和过渡\n- **无模糊效果**：消除背景模糊以获得更好的性能\n- **无文字阴影**：禁用文本阴影效果\n- **[视觉小说模式](/guides/sillytavern/user-settings/visual-novel/)**：与背景精灵的紧凑聊天\n- **展开消息操作**：始终显示完整消息上下文菜单\n- **禅宗滑块**：简化的参数控制\n- **疯狂实验室模式**：参数范围不受限制\n- **消息定时器**：显示AI响应生成时间\n- **聊天时间戳**：显示消息时间戳\n- **模型图标**：显示消息的AI模型图标\n- **消息 ID**：显示连续的消息编号\n- **隐藏聊天头像**：从聊天中删除头像\n- **消息令牌计数**：显示每条消息的 token 计数\n- **紧凑的输入区域**：单行输入（仅限移动设备）\n- **滑动#查看所有消息**：在所有消息上显示滑动切换回复号码\n- **角色热插拔**：快速选择喜爱的角色按钮\n- **头像悬停放大倍数**：头像悬停时的缩放效果\n- **标签作为文件夹**：使用标签作为文件夹组织角色\n- **点击编辑**：点击消息快速打开消息编辑器\n\n### 自定义CSS\n\n允许您应用自定义 CSS 样式来进一步自定义聊天界面的外观。\n\n使用 <i class=\"fa-fw fa-solid fa-maximize\" title=\"Expand icon\"></i> **展开** 扩展编辑器窗口以获得更好的可见性和编辑效果。\n\n如果您切换主题，您的自定义 CSS 将被新主题的自定义 CSS 替换。如果您想在切换主题时保留自定义 CSS，请确保将其保存到主题中。\n\n如果您使用大量自定义 CSS，或者想要对多个主题使用相同的自定义 CSS，非官方的 [CSS 片段扩展](https://github.com/LenAnderson/SillyTavern-CssSnippets) 可以帮助您管理和组织您的自定义 CSS。\n\n***\n\n## 留言声音\n\n要在收到来自机器人的新消息时播放您自己的自定义声音，请替换 SillyTavern 文件夹中的以下 MP3 文件：\n\n`public/sounds/message.mp3`\n\n以 80% 音量播放。\n\n如果“[仅背景声音](/guides/sillytavern/user-settings/#miscellaneous)\" 选项启用时，仅当 SillyTavern 窗口打开时才播放声音 **不专心的**.\n\n## 公式渲染\n\n要启用数学公式渲染，请使用 [乳胶扩展](https://github.com/SillyTavern/Extension-LaTeX)。要获取扩展，您需要通过 SillyTavern 中的“下载扩展和资源”菜单进行安装。\n\n在代码块中输入公式 `latex` 或 `asciimath` 分别为 LaTeX 和 AsciiMath 的语言标识符。该扩展使用 [凯泰克斯](https://katex.org/) 用于渲染。\n\n<pre><code>```latex\n\\int_{-\\infty}^{\\infty} e^{-x^2} dx = \\sqrt{\\pi}\n```\n\n```asciimath\nint_{-oo}^{oo} e^{-x^2} dx = sqrt{pi}\n```</code></pre>\n\n!!!info 弃用通知\n遗产 `$` 和 `$$` 不再支持包装语法。请使用以下正则表达式脚本来填充旧语法：\n\n- [$$ - 乳胶](https://github.com/SillyTavern/Extension-LaTeX/raw/refs/heads/main/assets/$$_-_latex.json)\n- [$ - Ascii 数学](https://github.com/SillyTavern/Extension-LaTeX/raw/refs/heads/main/assets/$_-_asciimath.json)\n  !!!\n",
      "searchText": "界面自定义 用户界面主题 主题管理 主题文件允许您保存、共享和重用您的 UI 自定义设置。您可以根据不同的心情或目的维护多个主题，并立即在它们之间切换。 导入/导出主题文件 删除现有主题 保存对当前主题的更改 另存为新主题 此部分中的所有设置都保存到当前主题。如果切换主题，这些设置将被新主题的设置替换。 显示设置 这些显示选项会影响角色和消息在聊天界面中的呈现方式。 头像风格 在圆形、方形、矩形或圆角方形之间进行选择。此设置适用于用户和 AI 头像。 聊天风格 风格 描述 斜线命令 平 干净、连续的“聊天日志”风格，一个让你的人工智能交互变得栩栩如生的平面画布。 /flat /default 气泡 “即时通讯”风格，每条消息都有明显的气泡、令人愉悦的圆角和微妙的 3D 效果。 /bubble /bubbles 文件 紧凑、类似文档的外观，具有以文本为中心的布局。隐藏过去消息的头像、时间戳和消息控制按钮。 /single /story 通知 设置通知弹出窗口（Toast 消息）在屏幕上出现的位置。 左上 顶部居中（默认） 右上 左下角 底部中心 右下角 媒体风格 聊天消息中媒体附件（图像、音频、视频）的默认显示样式。将媒体附加到聊天消息的扩展程序可能会覆盖此设置。还可以使用消息上下文菜单中的“切换媒体显示样式”操作手动更改每条消息。 列表：以网格状布局一次性显示所有媒体附件。 画廊：在轮播式图库中显示媒体附件。 此设置还会影响内联媒体附件发送到支持的聊天补全源的方式：列表一次发送所有附件，而图库发送选定的附件。 主题颜色 自定义每个 UI 元素的配色方案以创建您的完美主题。可以使用颜色选择器选择颜色，并在适用的情况下包括透明度选项。 正文 斜体文本 带下划线的文本 引用文字 文字阴影 聊天背景 用户界面背景 用户界面边框 用户留言 人工智能留言 布局和视觉设置 使用这些滑块微调界面的视觉呈现。 聊天宽度：调整聊天窗口宽度（屏幕的25-100%） 字体比例：自定义文字大小（0.5-1.5x） 模糊强度：控制 UI 面板模糊（0-30） 阴影宽度：调整文本阴影强度（0-5） 主题切换 这些开关控制各种 UI 功能和行为。有些选项可以提高低端设备的性能，而其他选项则可以向聊天界面添加有用的信息或功能。 减少运动：禁用动画和过渡 无模糊效果：消除背景模糊以获得更好的性能 无文字阴影：禁用文本阴影效果 视觉小说模式：与背景精灵的紧凑聊天 展开消息操作：始终显示完整消息上下文菜单 禅宗滑块：简化的参数控制 疯狂实验室模式：参数范围不受限制 消息定时器：显示AI响应生成时间 聊天时间戳：显示消息时间戳 模型图标：显示消息的AI模型图标 消息 ID：显示连续的消息编号 隐藏聊天头像：从聊天中删除头像 消息令牌计数：显示每条消息的 token 计数 紧凑的输入区域：单行输入（仅限移动设备） 滑动#查看所有消息：在所有消息上显示滑动切换回复号码 角色热插拔：快速选择喜爱的角色按钮 头像悬停放大倍数：头像悬停时的缩放效果 标签作为文件夹：使用标签作为文件夹组织角色 点击编辑：点击消息快速打开消息编辑器 自定义CSS 允许您应用自定义 CSS 样式来进一步自定义聊天界面的外观。 使用 展开 扩展编辑器窗口以获得更好的可见性和编辑效果。 如果您切换主题，您的自定义 CSS 将被新主题的自定义 CSS 替换。如果您想在切换主题时保留自定义 CSS，请确保将其保存到主题中。 如果您使用大量自定义 CSS，或者想要对多个主题使用相同的自定义 CSS，非官方的 CSS 片段扩展 可以帮助您管理和组织您的自定义 CSS。 留言声音 要在收到来自机器人的新消息时播放您自己的自定义声音，请替换 SillyTavern 文件夹中的以下 MP3 文件： public/sounds/message.mp3 以 80% 音量播放。 如果“仅背景声音\" 选项启用时，仅当 SillyTavern 窗口打开时才播放声音 不专心的. 公式渲染 要启用数学公式渲染，请使用 乳胶扩展。要获取扩展，您需要通过 SillyTavern 中的“下载扩展和资源”菜单进行安装。 在代码块中输入公式 latex 或 asciimath 分别为 LaTeX 和 AsciiMath 的语言标识符。该扩展使用 凯泰克斯 用于渲染。 !!!info 弃用通知 遗产 $ 和 $$ 不再支持包装语法。请使用以下正则表达式脚本来填充旧语法： $$ - 乳胶 $ - Ascii 数学 !!!",
      "translationStatus": "machine-draft"
    },
    {
      "slug": "user-settings/visual-novel",
      "title": "视觉小说模式",
      "group": "User_Settings",
      "order": 10,
      "source": "Usage/User_Settings/Visual-Novel.md",
      "sourceUrl": "https://docs.sillytavern.app/usage/user-settings/visual-novel/",
      "sourceSha256": "d90845b9713c00243bcf7e89108fbeb854afbe648c4cfc0cc4c213b2303c52ef",
      "headings": [
        {
          "id": "visual-novel-vn-mode",
          "depth": 1,
          "title": "视觉小说模式"
        },
        {
          "id": "toggling-visual-novel-mode",
          "depth": 2,
          "title": "切换视觉小说模式"
        },
        {
          "id": "enabling-visual-novel-mode",
          "depth": 3,
          "title": "启用视觉小说模式"
        },
        {
          "id": "disabling-visual-novel-mode",
          "depth": 3,
          "title": "禁用视觉小说模式"
        },
        {
          "id": "the-visual-novel-ui",
          "depth": 2,
          "title": "视觉小说用户界面"
        },
        {
          "id": "vn-mode-with-movingui",
          "depth": 3,
          "title": "带 MovingUI 的 VN 模式"
        },
        {
          "id": "obtaining-character-sprites",
          "depth": 2,
          "title": "获取角色精灵"
        },
        {
          "id": "vn-extensions",
          "depth": 2,
          "title": "越南延伸"
        },
        {
          "id": "prome-visual-novel-extension",
          "depth": 3,
          "title": "Prome 视觉小说扩展"
        }
      ],
      "content": "# 视觉小说模式\n\n视觉小说模式是 SillyTavern 中的一种特殊屏幕布局，允许您使用精灵（或其角色卡图像）与角色聊天，类似于 Doki Doki 文学俱乐部、The Fruits of Grisaia、Fate: Stay/night 和其他著名 VN 游戏等视觉小说。\n\n## 切换视觉小说模式\n\n### 启用视觉小说模式\n\n视觉小说模式内置于 SillyTavern 中，可以通过以下方式切换 *用户设置* （用户设置图标）并检查 **视觉小说模式** 下面 *无文字阴影*.\n\n![用户设置](/docs/sillytavern/static/vn/vn-mode-toggle.png)\n\n### 禁用视觉小说模式\n\n禁用视觉小说模式与启用它的步骤相同。取消切换视觉小说模式，您应该回到正常的聊天屏幕。\n\n> **关于带有 VN 扩展的 VN 模式**\n>\n> 如果您使用各自的 VN 模式，某些扩展（例如 Prome VN 扩展）将打开“视觉小说模式”。从以下位置启用/禁用 VN 模式 *用户设置* 菜单也会影响这些扩展。\n\n## 视觉小说用户界面\n\n![越南显示器](/docs/sillytavern/static/vn/vn-display.png)\n\n在视觉小说模式中，UI 略有更改，以适应中心显示的角色精灵（或角色卡图像）。然而，在与多个角色的群聊中，角色精灵会分散开来，相互适应，如下所示。\n\n![越南组显示](/docs/sillytavern/static/vn/group-vn-display.png)\n\n### 带 MovingUI 的 VN 模式\n\n> 要切换 MovingUI，请转至 *用户设置* 并检查 **移动用户界面**。请注意此功能 **仅** 适用于台式机。\n\n如果 **移动用户界面** 启用于 *用户设置*，如果您希望移动精灵（或角色卡图像）或将它们放置在屏幕上更具体的区域，则可以移动它们。\n\n> **关于精灵尺寸**\n>\n> 如果角色精灵的大小相对较大，则尝试使用 MovingUI 移动某些精灵将是一个挑战，因为拖动精灵的按钮可能会被现有精灵覆盖。您可能需要比平常更多地移动它们，特别是如果屏幕上有更多角色以获得更好的位置。\n\n![组 VN 显示 (MovingUI)](/docs/sillytavern/static/vn/vn-group-display-movingui.png)\n\n## 获取角色精灵\n\n获取角色精灵可以通过浏览互联网查找现有精灵来完成，例如，来自视觉小说的现有角色或使用视觉小说功能（如 DDLC 或 CounterSide）的游戏。如果您想要精灵的角色尚未附带精灵，您还有几个选择。\n\n1. 在角色帖子中搜索任何精灵 ZIP 包或精灵包链接。\n\n   > 一些机器人创建者可能会使用精灵包发布他们的机器人（在同一篇文章中或在精灵频道中）。如果有人还没有制作您想要的角色精灵，请搜索这些帖子。\n\n2. 使用 LoRA 和稳定扩散创建您自己的。\n\n   > 从头开始生成精灵非常耗时（特别是如果您的角色和/或您想要使用的稳定扩散模型不存在 LoRA），并且需要合适的硬件才能生成它们，如果您计划制作 28 个精灵表达式而不是 6 个，并且如果您使用 SDXL 和/或将精灵升级到更高分辨率，则更是如此。\n\n3. 使用角色卡图像。它可能不像精灵，但至少你可以在屏幕上看到一些东西。但是，多个角色卡不能在 VN 模式下使用。\n\n   > **Prome 视觉小说扩展中的角色卡图片**\n   >\n   > 在 Prome Visual Novel Extension 1.0.6+ 中，有一个功能称为 `Emulate Character Card as Sprite` 允许您通过使用角色卡作为聊天中的精灵来与精灵和非精灵角色进行群聊。\n   >\n   > ![角色卡片群聊](/docs/sillytavern/static/vn/extensions/prome/card-emulation.png)\n\n## 越南延伸\n\n### Prome 视觉小说扩展\n\nProme 视觉小说扩展是 Bronya Rand 和 Prometheus 认可的第三方扩展，它进一步增强了 SillyTavern 中的视觉小说体验，其功能包括使视觉小说 UI 更加“电影化”的信箱模式、带有变暗角色 Sprites 的焦点模式、只有聊天中的最后一条消息出现在聊天中的传统 VN 模式以及更多计划！\n\n|                                  信箱模式                                  |                                   传统VN模式                                   |\n| :--------------------------------------------------------------------: | :------------------------------------------------------------------------: |\n| ![水平信箱模式](/docs/sillytavern/static/vn/extensions/prome/horizontal.png) | ![传统VN模式](/docs/sillytavern/static/vn/extensions/prome/single-message.png) |\n\n|                               隐藏架（消息框）                               |                               聚焦模式（带变暗精灵）                               |\n| :------------------------------------------------------------------: | :---------------------------------------------------------------------: |\n| ![隐藏隐藏](/docs/sillytavern/static/vn/extensions/prome/sheld_hide.png) | ![带变暗精灵的对焦模式](/docs/sillytavern/static/vn/extensions/prome/defocus.png) |\n\n要安装 Prome Visual Novel Extension，您可以通过以下方式安装： `Download Extensions & Assets` 并发现 *Prome 视觉小说扩展*，或按照安装说明进行操作 [Prome 视觉小说扩展](https://github.com/Bronya-Rand/Prome-VN-Extension?tab=readme-ov-file#installation-and-usage) Github 页面。调整 Prome 的设置可以在 *扩展* -> **Prome（视觉小说扩展）** 或通过 🪄（魔杖）菜单。\n",
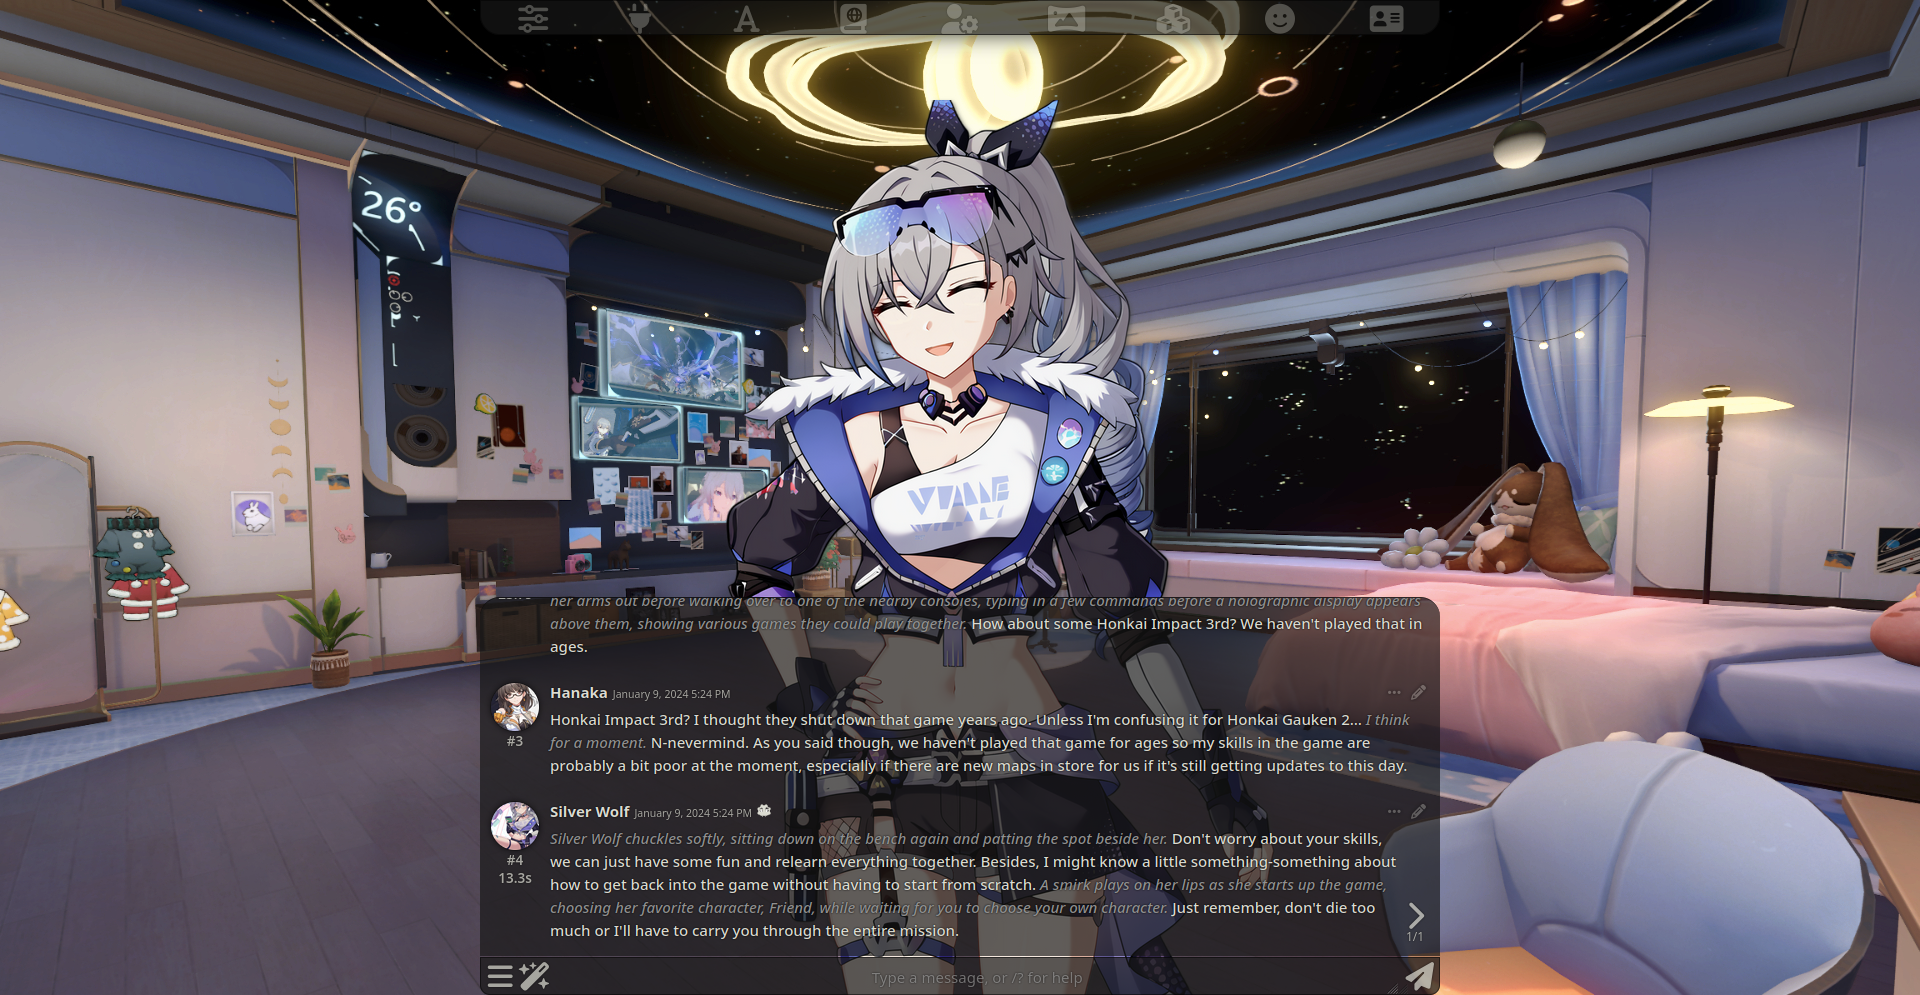
      "searchText": "视觉小说模式 视觉小说模式是 SillyTavern 中的一种特殊屏幕布局，允许您使用精灵（或其角色卡图像）与角色聊天，类似于 Doki Doki 文学俱乐部、The Fruits of Grisaia、Fate: Stay/night 和其他著名 VN 游戏等视觉小说。 切换视觉小说模式 启用视觉小说模式 视觉小说模式内置于 SillyTavern 中，可以通过以下方式切换 用户设置 （用户设置图标）并检查 视觉小说模式 下面 无文字阴影. 禁用视觉小说模式 禁用视觉小说模式与启用它的步骤相同。取消切换视觉小说模式，您应该回到正常的聊天屏幕。 关于带有 VN 扩展的 VN 模式 如果您使用各自的 VN 模式，某些扩展（例如 Prome VN 扩展）将打开“视觉小说模式”。从以下位置启用/禁用 VN 模式 用户设置 菜单也会影响这些扩展。 视觉小说用户界面 在视觉小说模式中，UI 略有更改，以适应中心显示的角色精灵（或角色卡图像）。然而，在与多个角色的群聊中，角色精灵会分散开来，相互适应，如下所示。 带 MovingUI 的 VN 模式 要切换 MovingUI，请转至 用户设置 并检查 移动用户界面。请注意此功能 仅 适用于台式机。 如果 移动用户界面 启用于 用户设置，如果您希望移动精灵（或角色卡图像）或将它们放置在屏幕上更具体的区域，则可以移动它们。 关于精灵尺寸 如果角色精灵的大小相对较大，则尝试使用 MovingUI 移动某些精灵将是一个挑战，因为拖动精灵的按钮可能会被现有精灵覆盖。您可能需要比平常更多地移动它们，特别是如果屏幕上有更多角色以获得更好的位置。 获取角色精灵 获取角色精灵可以通过浏览互联网查找现有精灵来完成，例如，来自视觉小说的现有角色或使用视觉小说功能（如 DDLC 或 CounterSide）的游戏。如果您想要精灵的角色尚未附带精灵，您还有几个选择。 在角色帖子中搜索任何精灵 ZIP 包或精灵包链接。 一些机器人创建者可能会使用精灵包发布他们的机器人（在同一篇文章中或在精灵频道中）。如果有人还没有制作您想要的角色精灵，请搜索这些帖子。 使用 LoRA 和稳定扩散创建您自己的。 从头开始生成精灵非常耗时（特别是如果您的角色和/或您想要使用的稳定扩散模型不存在 LoRA），并且需要合适的硬件才能生成它们，如果您计划制作 28 个精灵表达式而不是 6 个，并且如果您使用 SDXL 和/或将精灵升级到更高分辨率，则更是如此。 使用角色卡图像。它可能不像精灵，但至少你可以在屏幕上看到一些东西。但是，多个角色卡不能在 VN 模式下使用。 Prome 视觉小说扩展中的角色卡图片 在 Prome Visual Novel Extension 1.0.6+ 中，有一个功能称为 Emulate Character Card as Sprite 允许您通过使用角色卡作为聊天中的精灵来与精灵和非精灵角色进行群聊。 越南延伸 Prome 视觉小说扩展 Prome 视觉小说扩展是 Bronya Rand 和 Prometheus 认可的第三方扩展，它进一步增强了 SillyTavern 中的视觉小说体验，其功能包括使视觉小说 UI 更加“电影化”的信箱模式、带有变暗角色 Sprites 的焦点模式、只有聊天中的最后一条消息出现在聊天中的传统 VN 模式以及更多计划！ 信箱模式 传统VN模式 隐藏架（消息框） 聚焦模式（带变暗精灵） 要安装 Prome Visual Novel Extension，您可以通过以下方式安装： Download Extensions & Assets 并发现 Prome 视觉小说扩展，或按照安装说明进行操作 Prome 视觉小说扩展 Github 页面。调整 Prome 的设置可以在 扩展 -> Prome（视觉小说扩展） 或通过 🪄（魔杖）菜单。",
      "translationStatus": "machine-draft"
    }
  ]
}