KoboldCpp
KoboldCpp 是用于 GGML 和 GGUF 模型的独立 API。
这个 显存计算器 由 Nyx 制作,可以告诉你模型大致需要多少内存 / 显存。
Nvidia GPU 快速入门
本指南假设您使用的是 Windows。
- 下载最新版本: https://github.com/LostRuins/koboldcpp/releases
- 启动 KoboldCpp。您可能会看到 Microsoft Defender 的弹出窗口,单击
Run Anyway. - 从版本 1.58 开始,KoboldCpp 应该如下所示:
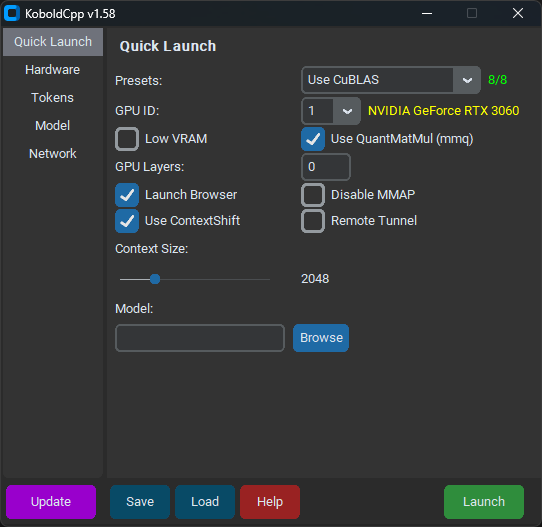
- 下
Quick Launch选项卡,选择型号和您的首选Context Size. - 选择
Use CuBLAS并确保旁边的黄色文本GPU ID与您的 GPU 匹配。 - 不要勾选
Low VRAM,即使您的 VRAM 较低。 - 除非您有 Nvidia 10 系列或更旧的 GPU,否则请取消选中
Use QuantMatMul (mmq). GPU Layers当您加载模型时应该已填充。暂时将其留在那里。- 下
Hardware选项卡,勾选High Priority. - 点击
Save因此您不必在每次启动时配置 KoboldCpp。 - 点击
Launch并等待模型加载。
你应该看到这样的东西:
Load Model OK: True
Embedded Kobold Lite loaded.
Starting Kobold API on port 5001 at http://localhost:5001/api/
Starting OpenAI Compatible API on port 5001 at http://localhost:5001/v1/
======
Please connect to custom endpoint at http://localhost:5001
您现在可以使用 SillyTavern 连接到 KoboldCpp http://localhost:5001 作为 API URL 并开始聊天。
恭喜!你完成了!
有点。
GPU层
KoboldCpp 正在运行,但您可以通过确保将尽可能多的层卸载到 GPU 来提高性能。您应该在终端中看到类似这样的内容:
llm_load_tensors: offloading 9 repeating layers to GPU
llm_load_tensors: offloaded 9/33 layers to GPU
llm_load_tensors:        CPU buffer size = 25215.88 MiB
llm_load_tensors:      CUDA0 buffer size =  7043.34 MiB
....................................................................................................
llama_kv_cache_init:  CUDA_Host KV buffer size =  1479.19 MiB
llama_kv_cache_init:      CUDA0 KV buffer size =   578.81 MiB
不要害怕数字;这部分比看起来容易。 CPU buffer size 指的是正在使用多少系统 RAM。忽略这一点。 CUDA0 buffer size 指的是正在使用多少 GPU VRAM。 CUDA_Host KV buffer size 和 CUDA0 KV buffer size 指的是有多少 GPU VRAM 专用于您的模型上下文。在本例中,KoboldCpp 使用大约 9 GB 的 VRAM。
我有 12 GB 的 VRAM,只有 2 GB 的 VRAM 用于上下文,因此我还剩下大约 10 GB 的 VRAM 来加载模型。因为 9 层使用了大约 7 GB 的 VRAM, 7000 / 9 = 777.77 我们可以假设每层大约使用 777.77 MIB 显存。 10,000 MIB / 777.77 = 12.8,所以从现在开始我将使用该模型向下舍入并加载 12 层。
现在使用系统的模型、上下文大小和 VRAM 进行自己的数学计算,然后重新启动 KoboldCpp:
- 如果你很聪明,你就点击了
Save之前,现在你可以加载以前的配置Load。否则,请选择您之前选择的相同设置。 - 改变
GPU Layers到您新的、VRAM 优化的数字(在我的例子中为 12 层)。 - 点击
Save保存更新的配置。
您现在应该看到类似这样的内容:
llm_load_tensors: offloading 12 repeating layers to GPU
llm_load_tensors: offloaded 12/33 layers to GPU
llm_load_tensors:        CPU buffer size = 25215.88 MiB
llm_load_tensors:      CUDA0 buffer size =  9391.12 MiB
....................................................................................................
llama_kv_cache_init:  CUDA_Host KV buffer size =  1286.25 MiB
llama_kv_cache_init:      CUDA0 KV buffer size =   771.75 MiB
KoboldCpp 使用了我的 12 GB VRAM 中的大约 11.5 GB。这应该比 KoboldCpp 自动生成的设置执行得更好。
恭喜!你(实际上)完成了!
要更深入地了解 KoboldCpp 设置,请查看 Kalomaze 的 简单的 Llama + SillyTavern 设置指南.